Archive for the ‘Kevin Bacon’ Category

Heute folgt ein langer und sehr technischer Beitrag. Das liegt daran, weil all dies hier den Warpantrieb der ganzen Problemløsungsmaschinerie beschreibt. Und weil’s eh schon so lang wird, verbrauche ich keine weiteren Worte fuer die Vorrede auf und frage gleich …

… wie muss ich mir eigentlich das Linknetzwerk der Wikipedia vorstellen?
Wenn man „Netzwerk“ hørt, dann denkt man mindestens an etwas Zweidimensionales und eine Form eines solchen zweidimensionalen Netzwerks kann man in den bekannten vereinfachten Beispielen sehen. Die Titel sind die Knotenpunkte und die Links dann die Pfade (zum naechsten Knotenpunkt).
Diese Vorstellung hat mir aber nicht geholfen eine Idee zu entwickeln, wie man technisch effizient dieses Netzwerk „abschreiten“ kønnte. Dann hatte ich das Sprachproblem aber „verzahlt“ und ab da formte sich (zunaechst unbewusst) in mir eine Idee.

Aus den Titeln wurden fortlaufende (!) Nummern. Ich kann die also auf eine Zahlengerade setzen. Und von jedem Punkt komme ich zu ganz bestimmten anderen Punkten. Die Links sind also eine Abbildungsvorschrift — eine Funktion. Diese ist nicht bijektiv sondern nur surjektiv. Deswegen leuchtete mir zunaechst nicht ein, was die Zielmenge dieser Abbildung ist. Also malte ich mir das drei Tage lang immer und immer wieder in meinem Kopf aus:
Nur leider hing ich darin fest. Ich wusste nicht weiter, wie ich das technisch umsetzen soll. Also ich hatte schon ein paar Ideen, aber die schienen mir technisch nicht praktikabel. Der Grund war, dass ich mir ja auf jedem Linklevel merken muss, welche Knoten schon besucht waren, damit ich nicht in Schleifen gerate. Das ist an und fuer sich kein Problem, denn die kann ich einfach alle in einen „Waggon der schon besuchten Knoten“ stecken. Das Problem ist dann, dass ich fuer jede der ueber 161-Millionen Abbildungen haette schauen muessen, ob die in besagtem „Waggon“ ist (das sollen die gestrichelten Pfeile darstellen), oder nicht. Und egal wie das Ergebnis dieses Nachschauens war, ich muss dann immer noch eine Entscheidung treffen was danach zu tun sei. All das sind Rechenoperationen die viel Zeit kosten.

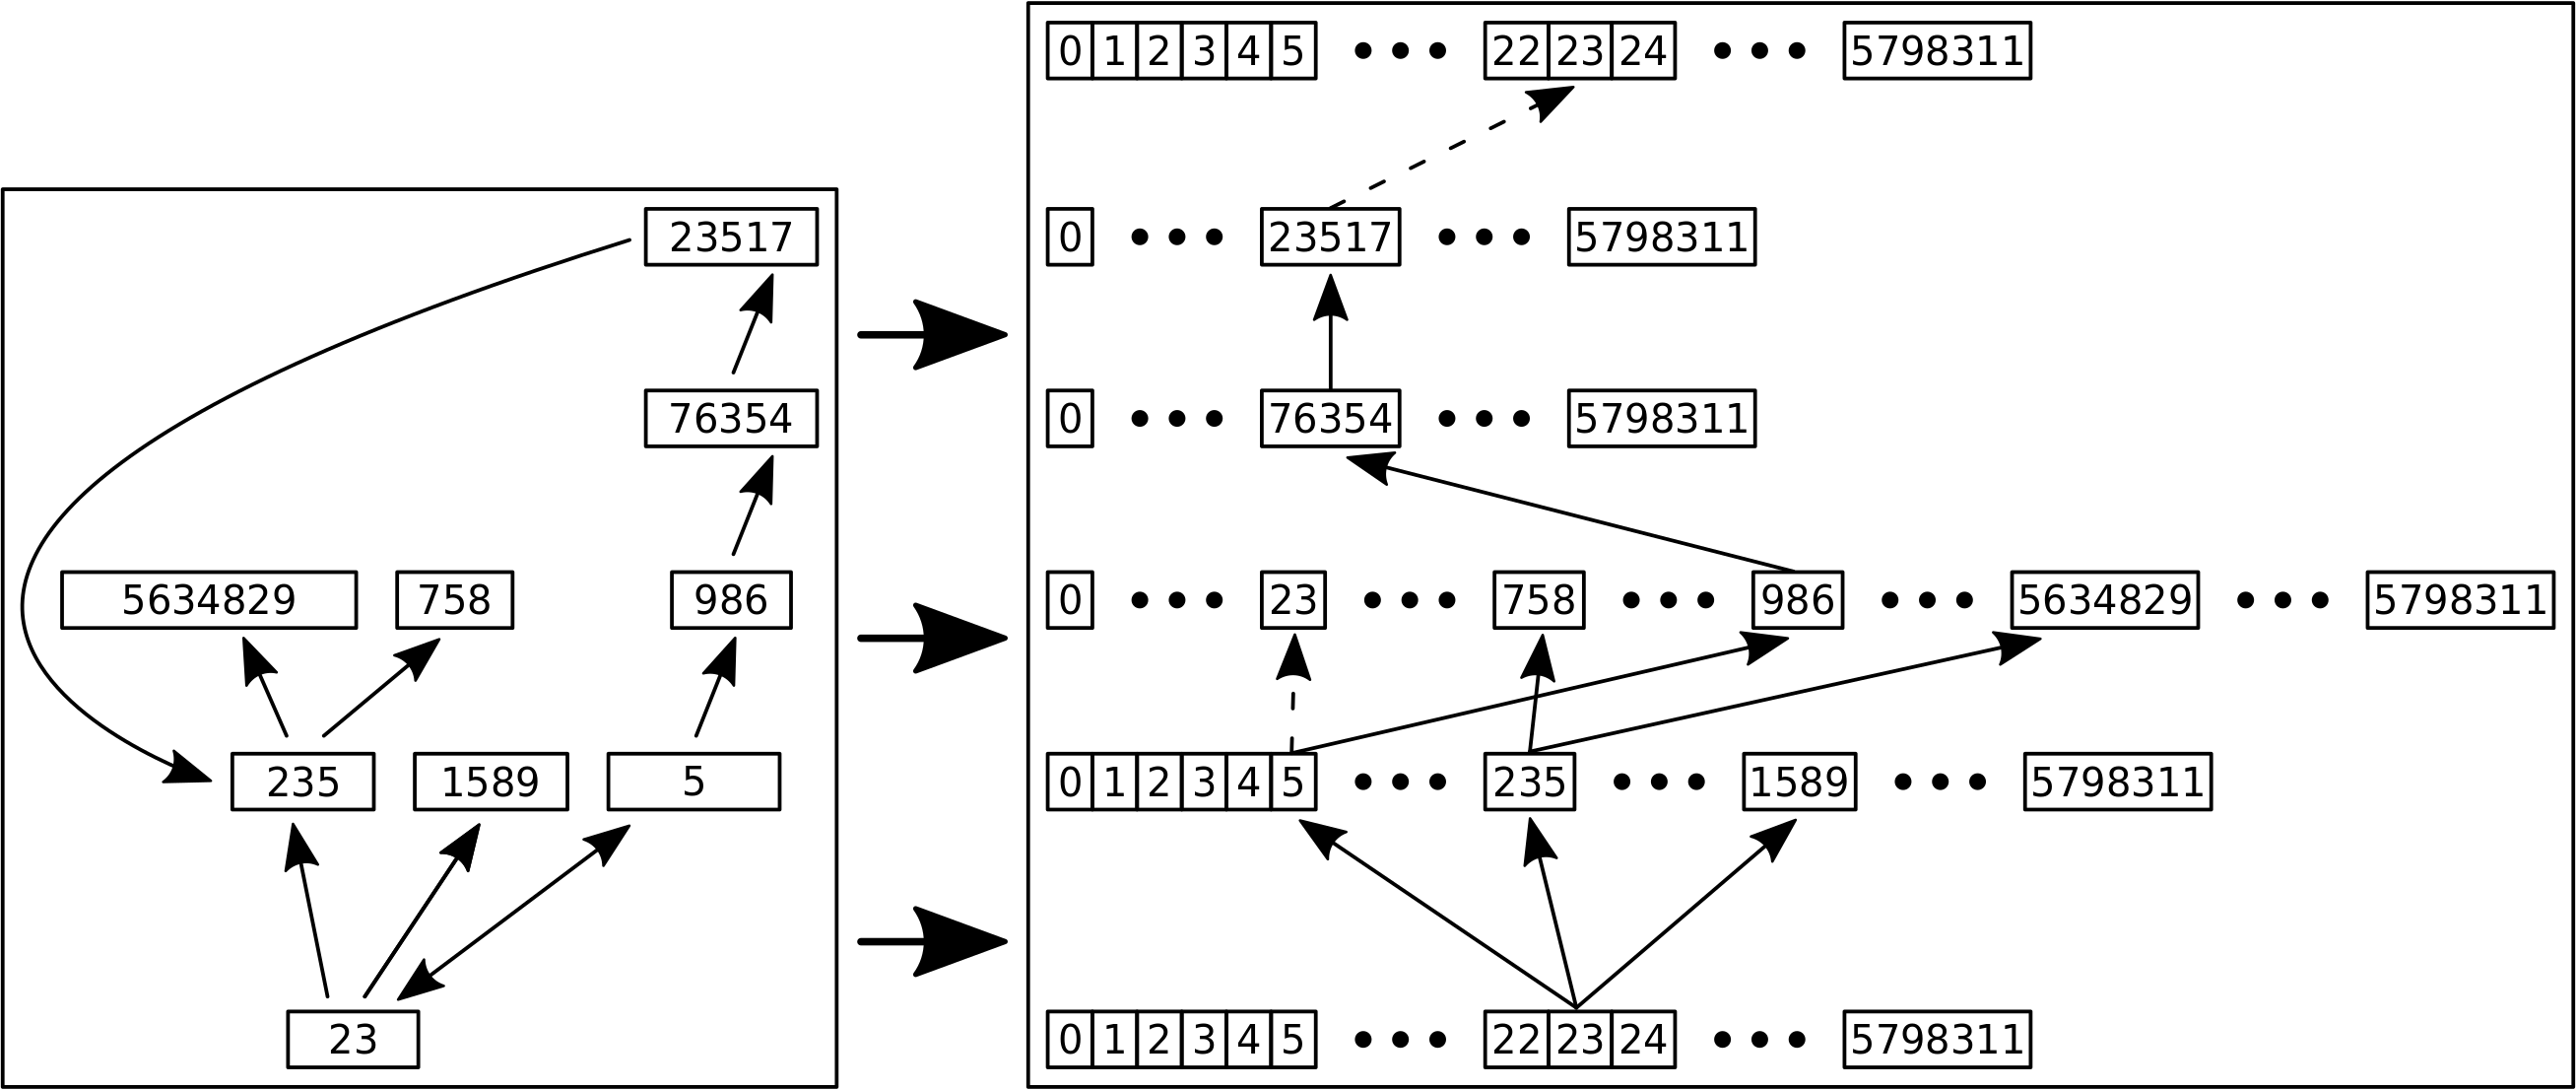
Nach drei Tagen daemmerte mir endlich die entscheidende Idee; zunaechst zøgernd, doch dann immer enthusiastischer: die Abbildungen bilden den Zahlenstrahl ja auf sich selber ab! Also buchstaeblich … bzw. wohl eher zahlstaeblich. Das Ganze sieht also viel eher so aus (LL = Linklevel):
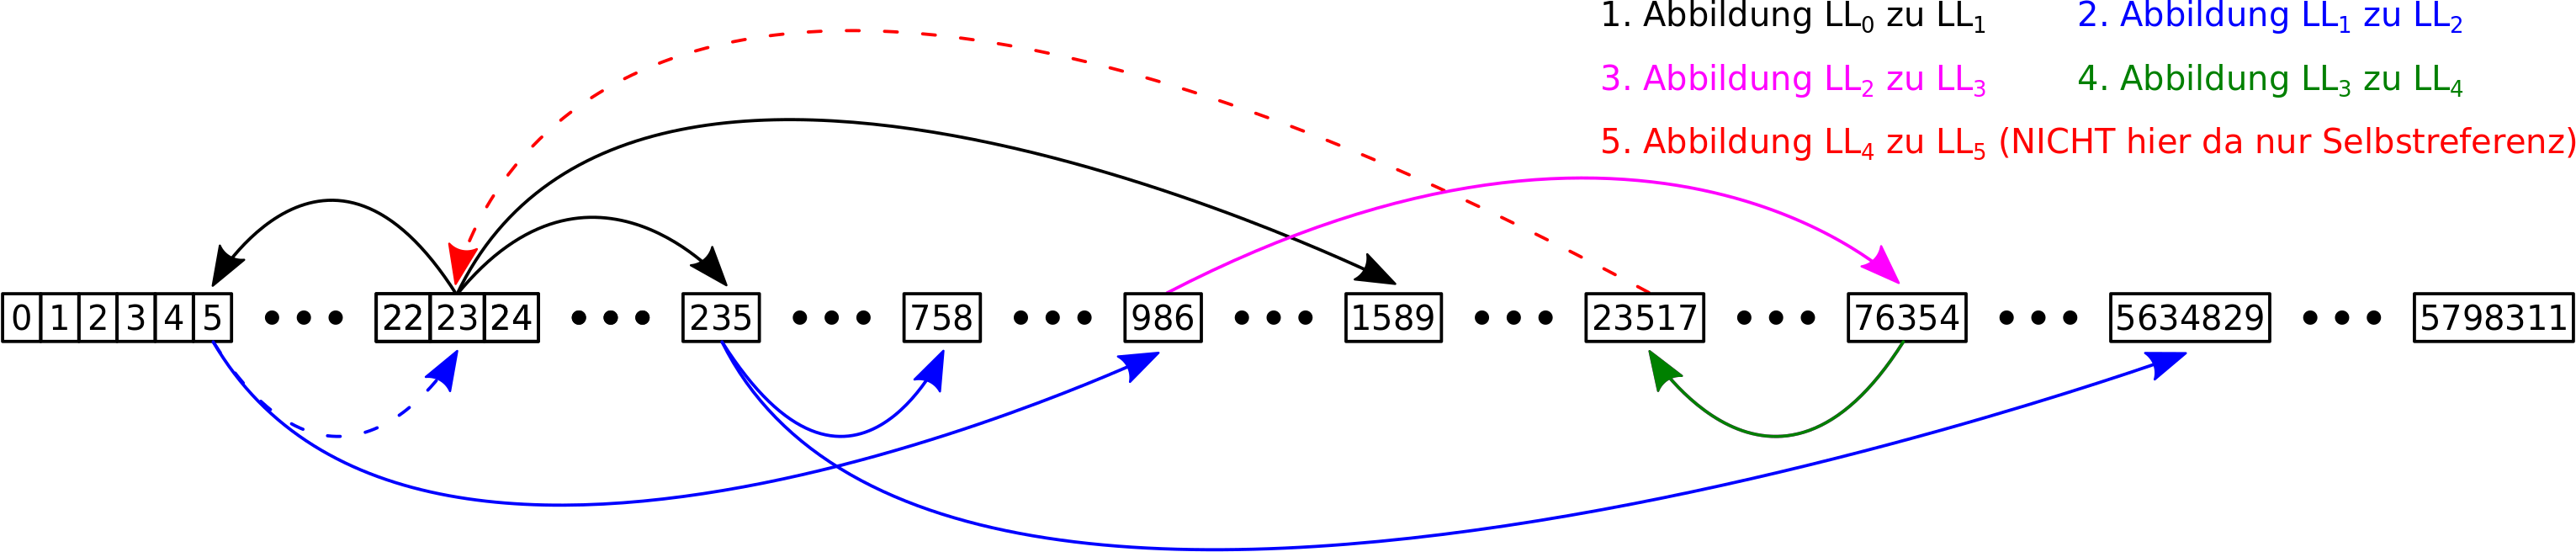
Knoten die ich schonmal besucht hatte konnte ich nach dem ersten Besuch einfach „raussschmeiszen“ und wenn eine Abbildung dann ins Leere fuehrt macht das nix.

Und ziemlich schnell nach dieser entscheidenden Idee hatte ich gleich noch einen zwei Geistesblitze: diese Zahlengerade ist ja ein Vektor! … mit 5,798,312 Dimensionen (die Zahlengerade zaehlt nur nur bis 5,798,311, weil ich bei der Null anfange zu zaehlen). Und jede Abbildung zeigt auf genau einen Punkt in diesem vieldimensionalen Raum!

Aber wenn ich das als einen Vektor sehen kann, dann kann ich das Problem doch mit den simpelsten Methoden der linearen Algebra angehen! Und lineare Algebra ist doch genau das, wofuer Computer gebaut wurden. Das bedeutet, dass ich anstatt umstaendlicher und Prozessorzeit verbrauchender „nachschauen und mittels verzweigter Anweisungen Entscheidungen treffen“-Operationen einfach nur Vektoren miteinander addieren und multiplizieren kann.

Und hier kommt jetzt die Genialitaet der beim letzten Mal besprochenen Abbildung der Wørter auf (ganze) Zahlen zum Tragen … und ein weiterer Geistesblitz: der Wert einer Zahl, entspricht der Position AUF dem Zahlenstrahl. Ist ja voll banal die Erkenntnis, aber in „Vektorform“ bedeutet dies: jeder Titel (als Zahlenwert) entspricht einem eindeutigen (!) Einheitsvektor in diesem multidimensionalen Vektorraum! Ein Einheitsvektor hat nun aber die Laenge 1. Das bedeutet, dass der Zahlenwert des Titels die Position in diesem spezifischen Einheitsvektor bestimmt, die NICHT Null wird, sondern Eins. Geil wa!

OK, ich gebe zu, das ist alles etwas abstrakt. Deswegen gehen wir mal gemeinsam der Reihe nach durch die technische Umsetzung.

Zunaechst einmal habe ich ja mein Lexikon in dem steht welcher Titel welche Links hat. Das behalten wir im Hinterkopf fuer wenn wir das brauchen. Andernfalls steht das nur passiv im Hintergrund rum, ich schlage spaeter darin nur nach wo die Links zu jedem Titel hinfuehren.

Das Folgende machen wir dann fuer jeden Titel.

Zunaechst initialisieren wir drei Vektoren mit 5,798,312 Dimensionen.
Der eine Vektor stellt alle Titel dar, die wir schon „besucht“ haben. Da wir im Moment noch keinen Titel besucht haben, stehen da ueberall Einsen. Nach dem Besuch schmeiszen wir die Eins an der Stelle des besuchten Titels raus (und zurueck bleibt eine Null). Das wird wichtig fuer spaeter. Diesen Vektor nenne ich < Verbleibend >.
Der zweite Vektor repraesentiert alle Titel die sich auf dem gerade unter Untersuchung befindlichen Linklevel befinden und NICHT bereits vorher besucht wurden. Die Elemente dieses Vektors sind alle Null, AUSZER wenn ich auf dem gegebenen Linklevel zum ersten Mal auf diesen Titel treffe. Dann wird wird der Wert des Vektors an der Stelle die dem Zahlenwert des Titels entspricht Eins. Ich nenne diesen Vektor < Jetzt >.
Den dritte Vektor nenne ich < Abbildung >. Dieser wird ebenso mit Nullen initialisiert und repraesentiert spaeter die „Ausgaenge“ von einem Linklevel zum naechsten.

Da wir uns ganz am Anfang befinden ist < Jetzt > natuerlich komplett „leer“ (also besteht nur aus Nullen). Dito, ist < Verbleibend > total „voll“ (besteht also nur aus Einsen). Fuer beide gilt eine Ausnahme, naemlich an der Position des einen Titels, dessen Linknetzwerk wir erforschen møchten. Im obigen Beispiel waere es dann Position 23 an der eine Eins in < Jetzt > bzw. eine Null in < Verbleibend > steht.
Fuer das Beispiel sehen die drei Vektoren als Zeilenvektor nach der Initialisierung so aus:
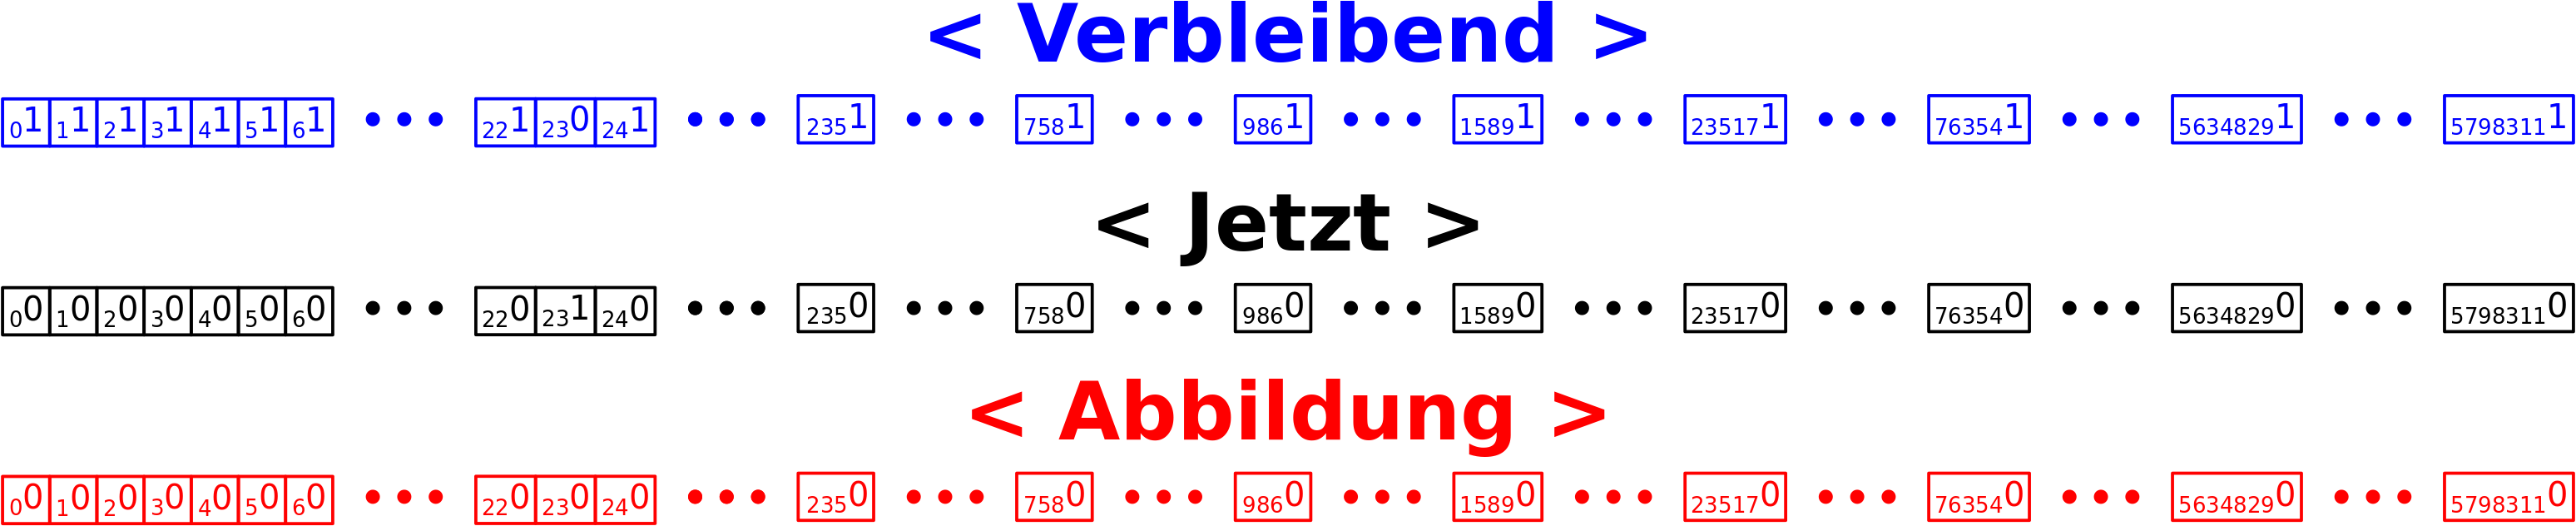
Die Indizes links unten an jeder Null oder Eins repreaesentieren die Positionen (oder Dimensionen im Sinne von x, y, z …) im Vektor. Man beachte, dass ich bei Null anfange zu zaehlen. An die richtige Position gelange ich einfach durch den Zahlenwert der betreffenden Titel. Man beachte ebenso, dass fuer < Verbleibend > und < Jetzt > der Wert an Stelle 23 anders ist als fuer alle anderen Positionen in diesen beiden Vektoren. Dies gilt nicht fuer < Abbildung >, denn wir haben ja gerade erst alles initialisiert und noch gar nicht geschaut, wo die 23 hin fuehrt.

Deswegen schauen wir im naechsten Schritt im Lexikon fuer _alle_ Titel die eine Eins in < Jetzt > haben (die also neu besuchte Titel auf diesem Linklevel sind) nach, wohin die fuehren. Die Zahlwerte dieser Links bestimmen auf welchen Positionen darauf im Vektor < Abbildung > eine Eins zu setzen ist. Im Beispiel muessen wir das erstmal nur fuer die 23 tun:

Danach finden drei der vier Auswertungen statt. Zum Ersten evaluiere ich, wie oft auf dem gegebenen Linklevel der urspruengliche Titel zitiert wird (Selbstreferenz). Im gezeigten Beispiel ist das nicht der Fall aber im Allgemeinen passiert das durchaus.
Zum Zweiten schaue ich pro Linklevel, welche Seiten zitiert werden, aber nur OB und NICHT wie oft die zitiert werden. In der Untersuchung des Linknetzwerkes fuer nur einen Titel, dann ist dieser Wert pro Linklevel fuer alle anderen Titel entweder einmal oder keinmal. Aber ich schaue mir das ja fuer alle fast 6 Millionen Titel an. Ich mache das auf diese Weise, weil mich interessiert, ob es Seiten gibt die prinzipiell eher bei høheren Linkleveln zitiert werden, verglichen mit „normalen“ Seiten. Deswegen kann ich hier auch nur „ob“ und nicht „wie oft“ zaehlen (im Unterschied zur Selbstreferenz), denn dann wuerden „populaere“ Seiten durch die schiere Anzahl der Zitate die diese bekommen das Signal verfaelschen.
Rein praktisch muss ich dafuer nur < Abbildung > auswerten und mir fuer das gegebene Linklevel merken, an welchen Positionen dieser Vektor nicht Null ist. Cool wa! So einfach ist das.
Als Drittes werte ich die Anzahl der totalen „Ausgaenge“ von diesem Linklevel zum naechsten aus. Das entspricht einfach nur der Summennorm (oder Laenge) des Vektors < Abbildung >.

Nun muss ich die naechste Iteration vorbereiten. Zunaechst muss < Jetzt > in der naechsten Iteration an den Positionen eine Eins haben zu denen ein „Ausgang“ fuehrt. Unter der Einschraenkung, dass diese Positionen nicht auf einem frueheren Linklevel bereits besucht wurden! Das kann ich einfach durch eine elementweise (!) Multiplikation von < Verbleibend > mit < Abbildung > erreichen:
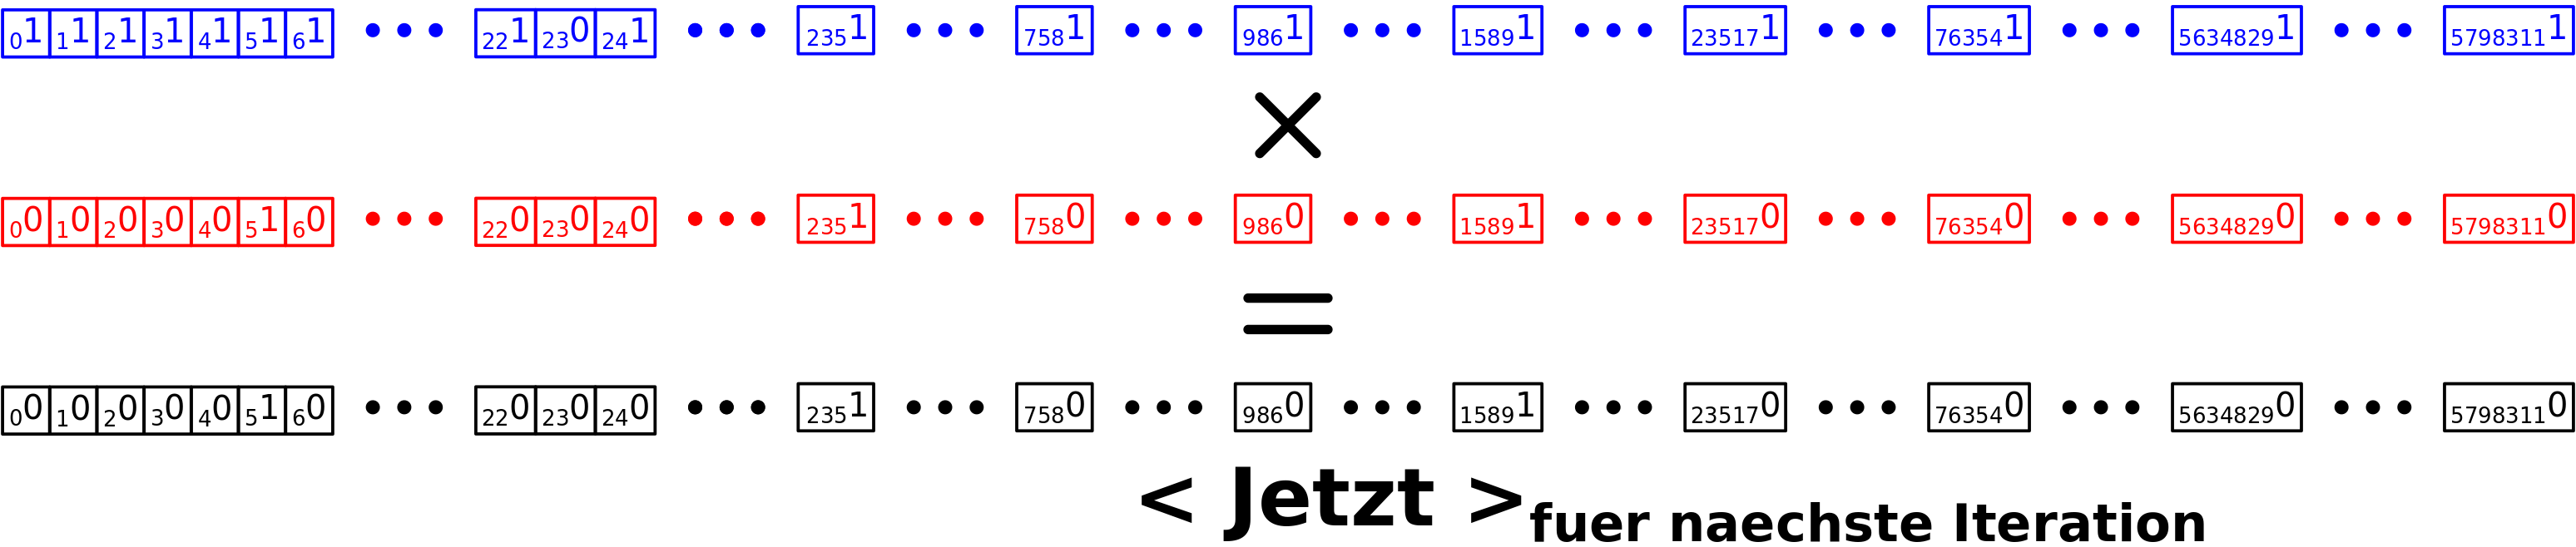
Das hier ist so geil! Man nehme an, dass < Abbildung > (also die „Ausgaenge“ vom jetzigen Linklevel zum naechsten) an einer bestimmten Stelle einen Wert von Eins hat (einfach weil das halt ein Link ist der auf diesem Linklevel auftaucht und dorthin will). Man nehme weiter an, dass ich den Titel der dieser Position entspricht aber schon besucht habe. In dem Fall hat < Verbleibend > an der selben Position einen Wert von Null. Somit wird das Produkt der Elemente der beiden Vektoren an dieser Position fuer den < Jetzt > Vektor der naechsten Iteration auch Null. Und das ist wichtig, denn ein Element in < Jetzt > soll ja nur dann Eins sein, wenn ich da noch nicht war, damit ich nicht in unendliche Schleifen gerate. Das wird klarer an Position 23, wenn ich weiter unten die Vektoren fuer die zweite Iteration voll ausschreibe.

An dieser Stelle nehme ich dann die letzte Auswertung vor. Die Laenge des neuen (!) < Jetzt > Vektors, ergibt die Anzahl der neuen, noch nicht besuchten „Ausgaenge“ auf diesem Linklevel, mit der gegebenen Startseite. Das møchte ich zusaetzlich zur obigen Anzahl der totalen „Ausgaenge“ wissen, denn nur die neuen zu besuchenden Seiten verlaengern die Kette von Kevin Bacon zu anderen Seiten der Wikipedia.
Das hier muss ich uebrigens sowieso auswerten, denn dies ist die Abbruchbedingung fuer die aeuszerste Schleife. Das bedeutet, dass wenn die Laenge des neuen < Jetzt > Vektors null wird (wenn es also keine „Ausgaenge“ zu noch nicht besuchten Seiten gibt), dann habe ich das komplette Linknetzwerk fuer die gegebene Startseite besucht. In dem Fall kann das ganze Prozedere natuerlich fuer den naechsten Titel von vorne beginnen.

Aber dies ist meistens erst bei høheren Linkleveln der Fall und deswegen møchte ich nun erstmal das naechste Linklevel untersuchen. Dafuer muss ich noch zwei letzte Sachen vorbereiten. Zum Einen muss < Abbildung > wieder zu null initialisiert werden (damit da in der naechsten Iteration wieder nur die neuen „Ausgaenge“ drin stehen). Zum Zweiten muss der neue < Verbleibend > Vektor berechent werden; ich habe ja jetzt mehr Seiten als zu Beginn der Iteration gesehen. Das ist ganz einfach, denn hier muss ich nur den (neuen) < Jetzt > Vektor vom bisherigen (alten) < Verbleibend > Vektor subtrahieren.
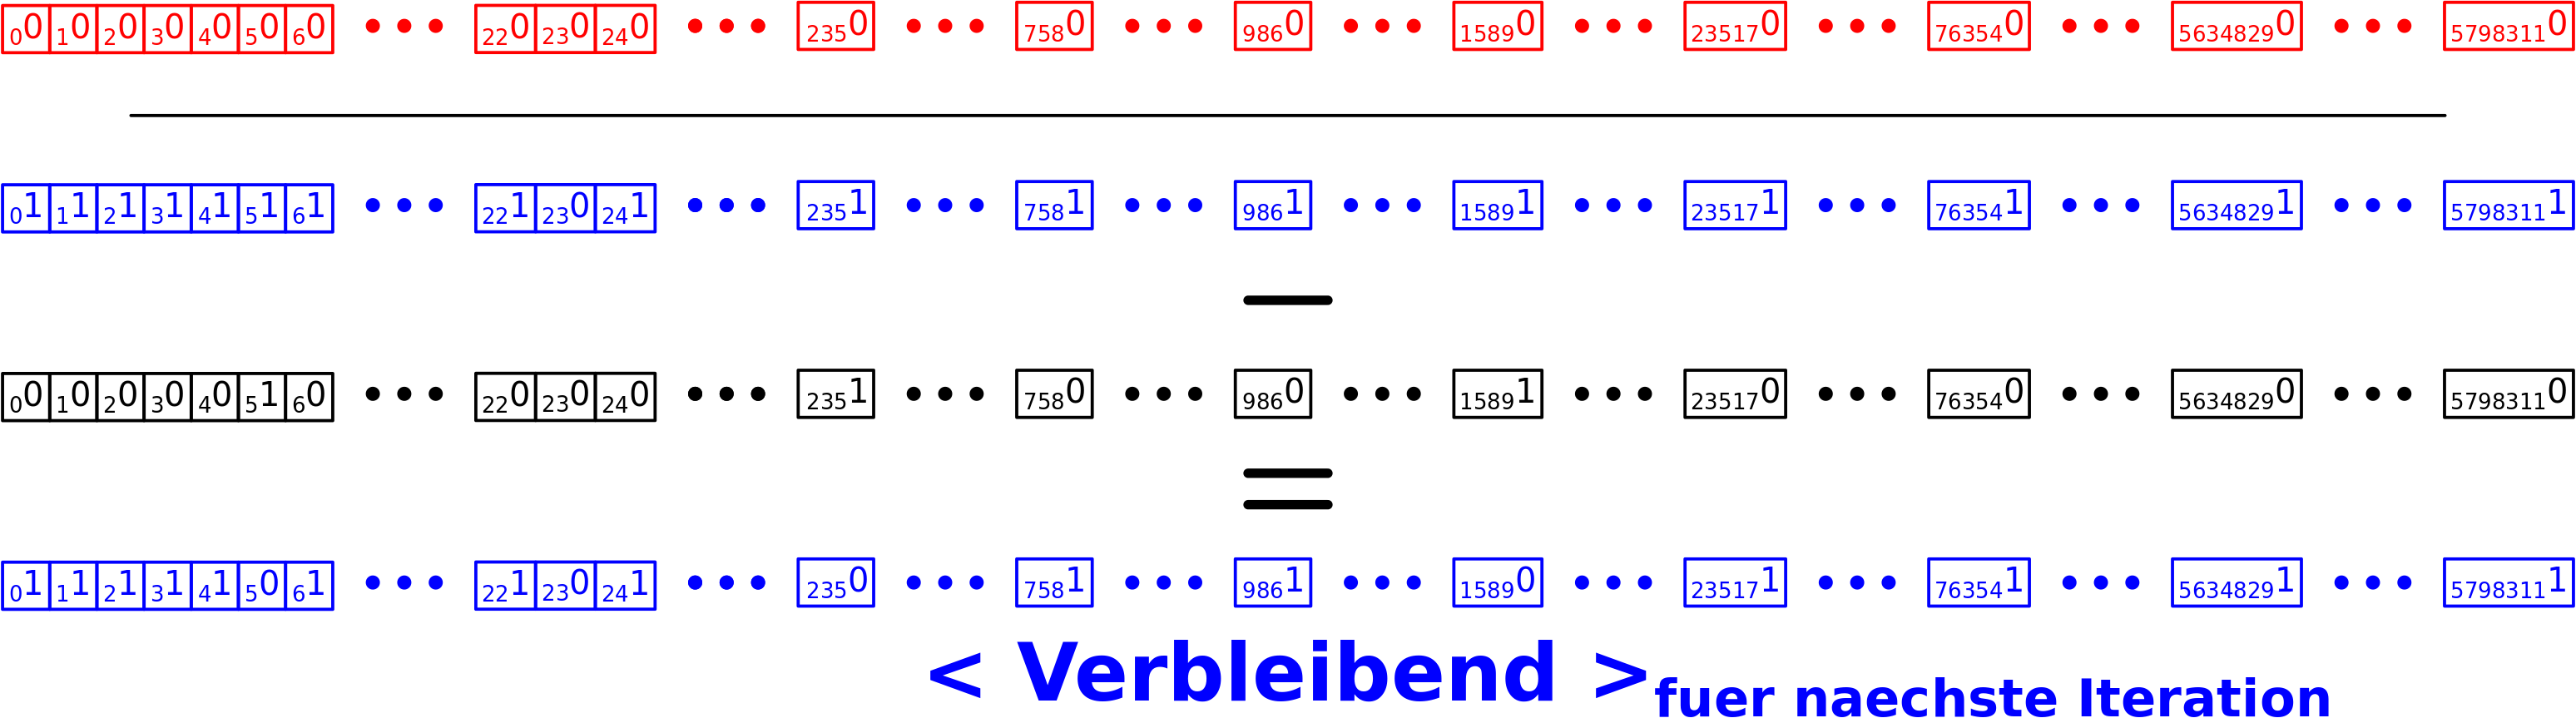
Und so einfach, meine lieben Leserinnen und Leser, ist die Løsung des Kevin-Bacon-Problems! Das ist ja wohl mal voll geil, wa! Deswegen schrieb ich ganz oben auch „Warpantrieb“, denn dadurch, dass ich hier nur Nullen und Einsen lesen, schreiben, multiplizieren und subtrahieren muss kann das ganze urst schnell berechnet werden … naja … „urst schnell“ ist relativ und ich komme darauf an anderer Stelle zurueck.

Hier nun in visueller Form die selben Schritte fuer Linklevel 2 des Beispiels:
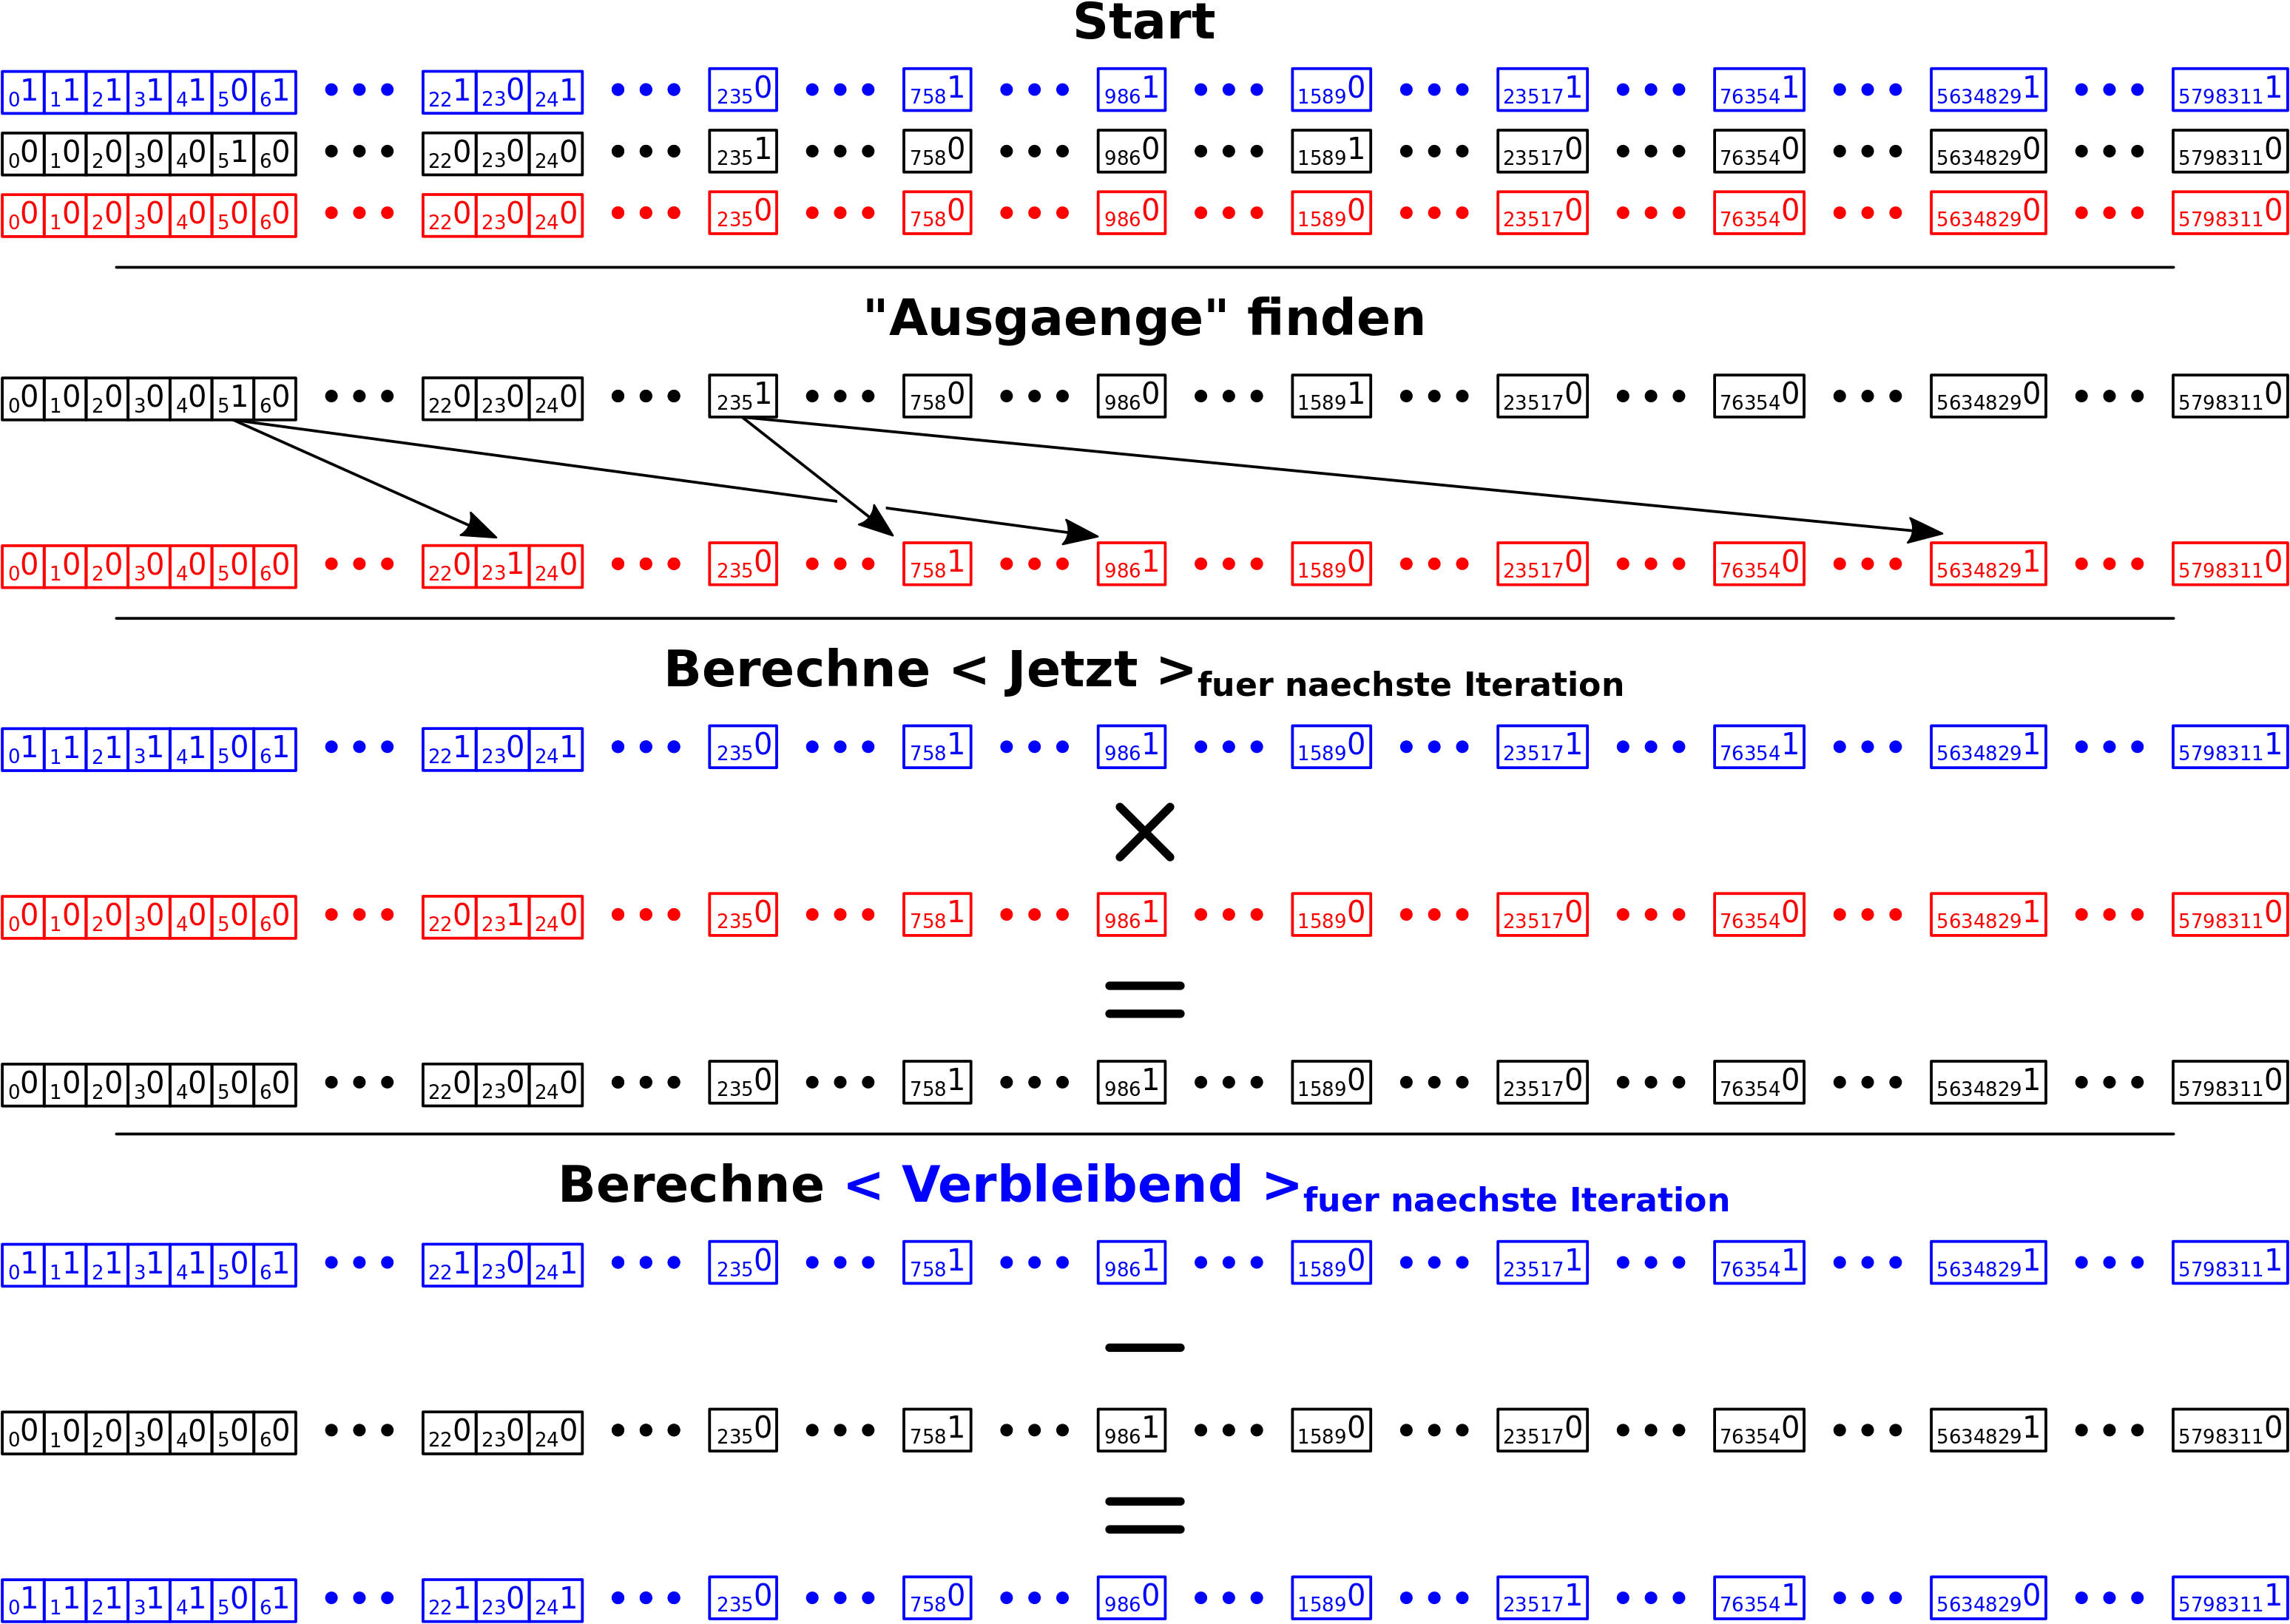
In dieser zweiten Iteration wird an drei Stellen sichtbarer, warum ich das alles so geil finde … und damit auch mich so toll finde, weil ich da von alleine drauf gekommen bin.
Im Schritt „Ausgaenge finden“ wird < Abbildung > an Position 23 natuerlich zu 1 gesetzt (das ist noch nicht das Fetzige). 5 will da hin, selbst wenn ich da schon war. Wenn ich dann aber < Jetzt >fuer naechste Iteration berechne wird das Element an Position 23 (wie oben bereits erwaehnt) durch die Multiplikation mit < Verbleibend > zu Null. DAS ist das erste Fetzige, denn diese Multiplikation ist oben besagte Kontrolle, dass ich nur bei Titeln weiter gehe, die ich noch nicht besucht hatte. Das ganze aber ohne Prozessorzeit verbrauchende Fallunterscheidungen.
Bei der selben Berechnung sieht man auch, dass die „Ausgaenge“ nicht einzeln „durchschritten“ werden (so wie wenn ein Mensch mit den Augen den Pfeilen folgt), sondern alle gleichzeitig! Das ist das zweite Fetzige.
Das dritte Fetzige ist dann letztlich, wenn < Verbleibend >fuer naechste Iteration berechnet wird. Dort sieht man, wie die Laenge dieses Vektors von Linklevel zu Linklevel immer kleiner wird, weil immer mehr Einsen zu Nullen werden. Das soll ja auch so sein, denn ich habe ja immer mehr und mehr Wikipediaseiten gesehen von Linklevel zu Linklevel.

Und das ist alles so fetzig, weil die ganzen die Problemløsung bzgl. der Uebersicht ueber wichtige Aspekte zu behalten, einfach so aus der „Mathematisierung und Verzahlung“ mit „heraus fallen“.
Haette ich hier uebrigens nur den Code hinkopiert, so waere dieser Artikel deutlich kuerzer, aber mglw. auch deutlich weniger verstaendlich, gewesen. Denn der Warpkern der Problemløsungsmaschinerie sind nur ’n paar Zeilen Code.

Fuer die tatsaechliche Implementation brauchte ich mehrere Wochen. Ich musste das naemlich letztlich in C programmieren (womit ich mich fast gar nicht auskenne) UND ich wollte das parallelisieren, dass also die Linknetzwerke mehrerer Titel gleichzeitig durchschritten werden. Diese Herausforderung war aber sooooooo herrlich und das zustande bringen der (technisch, praktikablen) Løsung soooooo befriedigend.
Damit meldet sich mein innerer Zefram Cochrane fuer heute ab.
Endlich kann ich ueber diesen Geniestreich reden … aber ich greife vor.

Beim vorletzten Mal „mathematisierte“ ich das Kevin-Bacon-Problem. Das war prinzipiell løsbar, aber ich stellte beim letzten Mal fest, dass es aufgrund von Speicherplatzmangel technisch in der gegebenen Form praktisch nicht løsbar war.

Ich redete beim letzten Mal viel ueber die „Betriebskosten“ (in Form von Speicher) die Datenobjekte haben. Dabei konzentrierte ich mich auf Wortobjekte. Fuer jedes Wort habe ich „Betriebskosten“ von 49 Bytes plus der Speicherbedarf der „Nutzlast“ von 1 Byte pro Buchstabe. Die „Nutzlast“ ist von der Laenge des Wortes abhaengig.

Ich erwaehnte auch, dass eine Zahl keine Laenge hat. Cool ist nun, dass der Gesamtspeicherbedarf („Betriebskosten“ + „Nutzlast“) einer ganzen Zahl auf meinem Rechner unter Python 3.7.3 deutlich kleiner ist als fuer Wørter; naemlich nur 28 Bytes. Und das ist unabhaengig davon, wie grosz die Zahl wird! … Naja, es gibt natuerlich Ausnahmen. Die Null braucht nur 24 Bytes und ganz grosze Zahlen (genauer gesagt ab 1,073,741,824) brauchen dann schon 32 Byte und irgendwann werden die Zahlen so grosz, dass die 36 Byte brauchen usw. Aber das ist hier nicht von Interesse, da ich nicht in diese groszen Bereiche komme mit dem gegebenen Problem.

Und hier kommt jetzt die geniale Idee: Ich bildete jeden Titel auf eine nicht negative ganze Zahl (inklusive der Null) ab. Wenn ein Titel von einem anderen Titel zitiert wird, dann erstatte ich diesen mit der gegebenen Zahl. Die Reihenfolge spielt dabei ueberhaupt keine Rolle. Diese Abbildung ist bijektiv und die Abbildungsvorschrift (einfach eine lange Tabelle welcher Titel welcher Zahl zugeordnet ist) merke ich mir natuerlich, falls ich spaeter eine spezfische Linkkette nachverfolgen will.

Durch die Abbildung auf nicht negative ganze Zahlen verringerte sich der Speicherbedarf meiner 5,798,312 Titel und 165,913,569 Links von ehedem 11 GB auf 4,807,932,668 als ca. 4.8 GB … Huzzah!

Damit habe ich das Kevin-Bacon-Problem nicht nur mathematisiert, sondern auch „verzahlt“. Das coole ist, dass sich dabei der Informationsinhalt, bzgl. der Informationen, an denen ich interessiert war (!), nicht veraenderte. Cool wa!

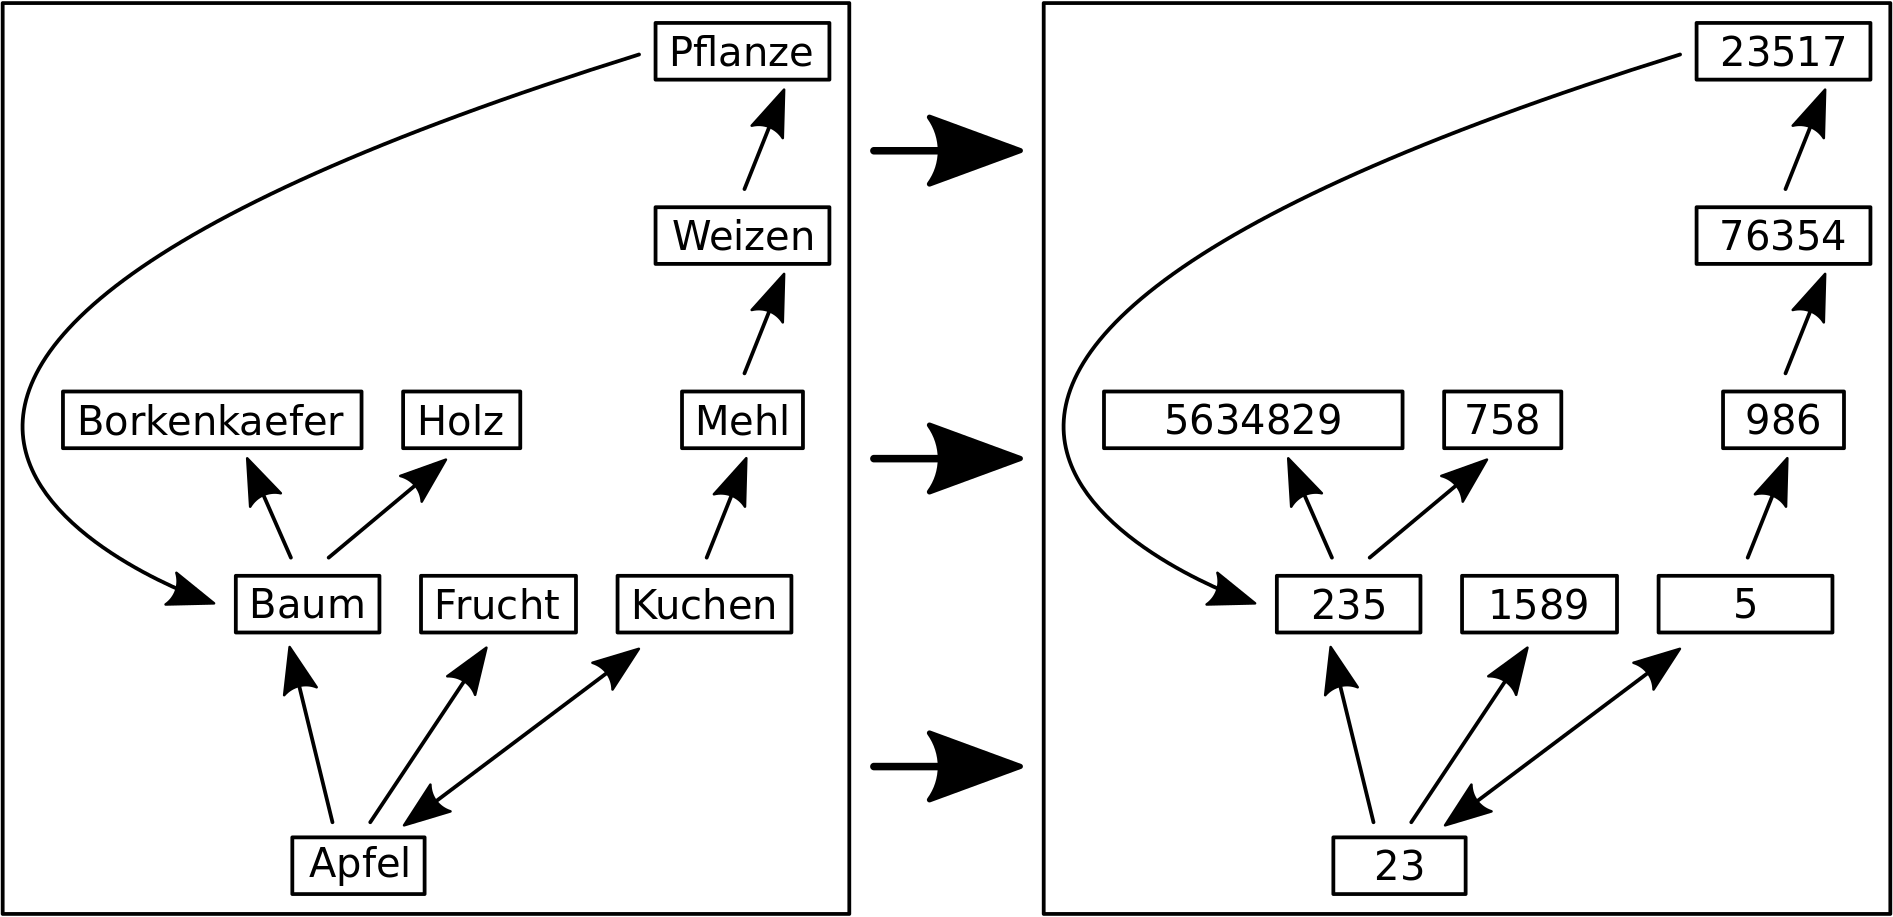
Zur Veranschaulichung hier das dritte Beispiel vom vorletzten Mal in der neuen Darstellung:

Mit dem Bild erkennt man besser, dass sich der untersuchte Informationsinhalt nicht aendert. Ob Apfel jetzt auf Kuchen zeigt oder 23 auf 5 tut nix zur Sache, solange im gesamten Netzwerk 23 immer mit Apfel und 5 immer mit Kuchen assoziiert ist.

Zum Problem der „Betriebskosten“ der Wortobjekte kamen beim letzen Mal die Betriebskosten der „Waggons“ (oder Ueberstrukturen) in denen diese aufbewahrt wurden. Ein Problem wurde es deshalb, weil jeder Titel einen solchen „Waggon“ hat. Ganz spezifisch waren diese „Waggons“ sogenannte Sets und deren „Betriebskosten“ waren abhaengig von der Anzahl der darin enthaltenen Elemente.
Das Gute ist nun, dass es noch andere Arten von „Waggons“ gibt. Fuer den Verwendungszweck hier ist nur wichtig, dass diese die „Aufbewahrungsbox“ aller zu einem Titel gehørenden Links sind, damit nix durcheinander kommt. Dafuer brauche ich kein Set, wie beim letzten Mal erwaehnt, sondern es reicht ein sogenannten Tupel.
Waehrend man mit Sets urst viel machen kann (bspw. Elemente heraus nehmen oder dazu packen, oder Mengenoperationen mit anderen Sets ausfuehren) kann man mit Tuples (fast) nix machen. Das ist ein unveraenderbarer „Kasten“ fuer meine Links (die ja nun Zahlen sind). Und weil man damit so wenig machen kann, betragen die „Betriebskosten“ eines leeren Tuples nur 56 Bytes und die steigen linear an (diesmal wirklich) mit 8 Byte pro neuem Element.

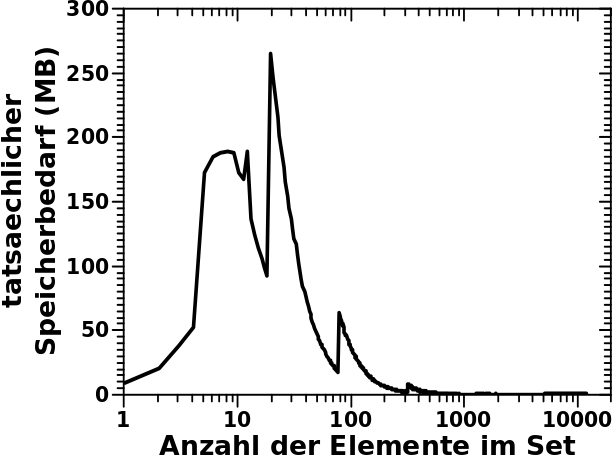
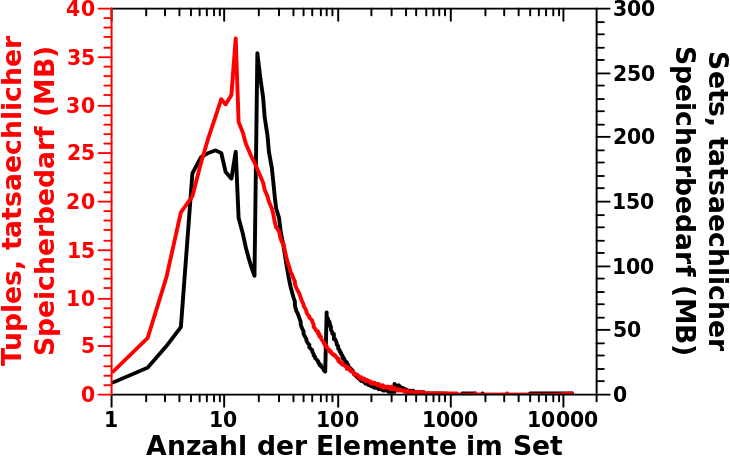
Wie beim letzten Mal brauche ich nun das Produkt aus der Verteilung der Links pro Titel und dem tatsaechlichen Speicherbedarf der Tuples. Zum Vergleich habe ich in dieses Diagramm das Resultat dieser Rechnung und der gleichen Rechnung vom letzten Mal dargestellt.

So ein Mist, da aendert sich ja nicht viel … ach nee! Die Skala der linken Ordinate ist eine ganze Grøszenordnung (!) kleiner als die Skala der rechten Ordinate … voll krass!

Der Gesamtspeicherbedarf betraegt damit fuer alle „Tuple-Waggons“ keine 11 GB wie bei den Sets, sondern nur 1,605,627,528 Bytes also ca. 1.6 GB.
Da kommen dann noch die ca. 300 MB fuer die oberste Struktur hinzu, welches alle „Waggons“ den richtigen Titeln zuordnen (die „Lokomtive“ vom letzten Mal bzw. das „Dictionary“). Insgesamt benøtige ich mit diesen Modifikationen dann nur noch 6,7 GB.

JIPPIE! So viel Speicher habe ich und deswegen soll das fuer heute reichen. So viel sei nur noch gesagt: hier hingeschrieben hørt sich der Schritt der Abbildung der Titel auf ganze Zahlen voll logisch an. Deswegen war dieser Geniestreich als solcher auch zunaechst unbemerkt. Ich wollte ja erstmal nur das Speicherplatzproblem løsen. Aber letztlich erlaubte mir erst dieser Schritt die (effiziente!) technische Implementierung der Løsung des eigentlichen Problems. Dazu Bedarf es allerdings noch ein paar weiterer (Achtung: Spoiler) „Transformationen“.

Beim letzten Mal beschrieb ich die Umwandlung des urspruenglichen Sprachproblems in ein mathematisches Problem. Damit kann man prinzipiell so wie’s ist (von Apfel zu Kuchen zu Mehl usw.) an die Sache heran gehen.
Wir sprechen hier aber von fast 6 Millionen Knoten (Wikipediatiteln) und mehr als 181-Millionen Verbindungen dazwischen in diesem Netzwerk. Und fuer jeden Knoten muss ich die Gesamtheit der Verbindungen „abschreiten“. Dabei lief ich in ein albekanntes Problem: nicht genug Speicher! Aber der Reihe nach.

Vor ein paar Monden hørte ich mit der Saeuberung der Rohdaten auf und es blieben noch …

[…] 5,798,312 Wikipediaseiten auf denen insgesamt 165,913,569 Links erscheinen […]

… zurueck.

Ich schrieb auch, dass der Speicherbedarf dieser Daten von ehemals ueber 70 GB (die gesamte Wikipedia) auf 4.1 GB verringert wurde. Ich hatte das auf 61 Dateien verteilt und die bin ich fuer die bereits vorgestellten Untersuchungen immer der Reihe nach durchgegangen (denn da hat mich ja das Netzwerk an sich nicht interessiert).
Das Komische war nun, dass das eigentlich alles in den Speicher meines Laptops passen sollte … aber irgendwie kam dieser nicht zurecht, wenn ich versuchte mehr als 10 dieser Dateien gleichzeitig zu laden.

Merkwuerdig … wie sieht das denn eigentlich im Speicher aus?
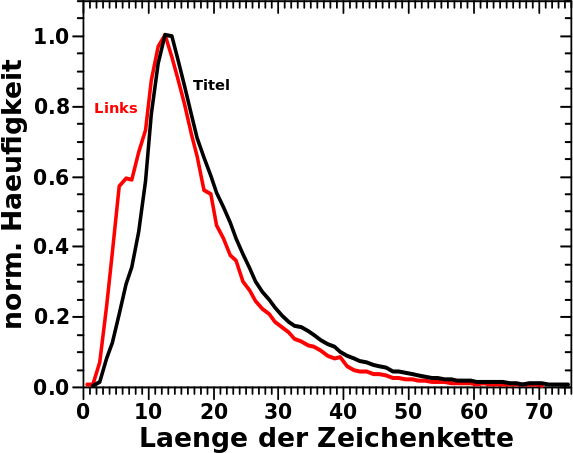
Nunja, erstmal dachte ich ganz einfach, dass die Titel der Seiten Buchstabenketten (allgemeiner: Zeichenketten) mit einer bestimmten Laenge sind. Dito bzgl. der Links „hinter“ jedem Titel.
Im Wesentlichen braucht ein Buchstabe im Speicher 1 Byte … jaja, Sonderzeichen brauchen mglw. mehr, aber ich sollte davon nicht soooo viele haben … Der Speicherbedarf der Titel sollte also das Integral ueber die hier gezeigte Verteilung sein: 117,194,976 Bytes also ca. 117 MB.
Die Verteilung der Laengen der Links ist sehr aehnlich:

In den nicht normierten Daten ist die Amplitude der Verteilung der Links natuerlich viel grøszer und diese muss natuerlich fuer das Integral genommen werden.
Nebenbemerkung: das kleine „Uebergewicht“ bzw. „Untergewicht“ links bzw. rechts vom Maximum ist sicherlich dadurch zu erklaeren, dass „prominente“ (also oft zitierte) Seiten einen kurzen und knackigen Titel haben — siehe hier. Der Unterschied ist zwar zu sehen, aber nicht so massiv (oder unerwartet), sodass ich mich da nicht weiter fuer interessiere. Insb. auch deswegen nicht, weil die gegebene Erklaerung (mit den Beispielen der meistzitierten Seiten) durchaus plausibel klingt.

Fuer den Speicherbedarf aller in den Links enthaltenen Zeichen errechnete ich nun: 2,898,076,329 also ca. 2.9 GB.

Na sowas! Meine simplen Ueberlegungen løsen die Merkwuerdigkeit nicht auf!
Des Raetsels Løsung ist zweigeteilt und ich gebe zu, dass das ueber das Anfaengerprogrammiererniveau hinaus geht (wenn auch nicht sehr weit). Aber dafuer muss ich etwas ausholen. Das wiederum handelt im vorbeigehen auch gleich etwas ab, was beim naechsten Mal total hilft :) .

Nehmen wir die Zeichenkette „gerader Strich mit kurzer Kappe, zwei mal zwei nach links offene Halbkreise, schraeger Strich mit Vordach“ — oder in kurz 1337.
Ich nehme 1337 mit Absicht. Zum Einen ist es natuerlich die Zahl Eintausenddreihundertsiebenundreiszig. Dann es aber auch das bekannteste Beispiel fuer Leetspeak und wird eben auch direkt als „LEET“ — also ein Wort — interpretiert.
Ein und die selbe (!) Zeichenkette hat also zwei unterschiedliche Bedeutungen. So wir denn von diesen Unterschieden wissen, so ist das fuer uns Menschen i.A. kein Problem 1337 kontextabhaengig richtig zu interpretieren. Wenn ich also sage packe bei 1337 nochmal 1337 ran, so ist das eine Addition im Falle der Zahl und das Ergebnis wird 2274 bzw. wird is im Falle des Wortes 13371337 (also LEETLEET).

Damit bin ich bei einem weiteren wichtigen Aspekt: Operationen.
Abhaengig von der Bedeutung die die Zeichenkette hat, kann man damit unterschiedliche Operationen ausfuehren oder gleiche Operationen, die aber unterschiedliche Ergebnisse haben. Oben erwaehnte ich die Addition. Eine andere Operation waere „Sag mir mal die Laenge von dem was ich gerade vor mir habe“.
Bei LEET entspricht die Laenge natuerlich der Anzahl der Zeichen und ist somit vier. Aber selbst wenn eine Zahl viele Zahlzeichen enthaelt, so ist die Laenge einer Zahl doch immer eins! Das ist besser zu verstehen, wenn man rømische Zahlsymbole nimmt, denn da sind 10, 50, 100, 500 und 1000 nur ein Symbol. Noch cooler ist das cistercianische Zahlsystem, welches bis 9999 immer nur ein Symbol braucht.

Das alles weisz man „automatisch“ als Mensch, aber dem Computer muss man zu jeder Zeichenkette sagen, was die jetzt eigentlich fuer eine Bedeutung hat, damit die richtigen Operationen drauf ausgefuehrt werden. Und hat eine Zeichenkette erstmal eine Bedeutung, so aendert die sich niemals … … … jaja, ich weisz, dass es da Spezialfaelle gibt, die Ausnahmen zu dieser Aussage sind … aber mir geht’s hier darum, dass man einem Computer explizit und jedes Mal sagen muss, womit dieser eigentlich gerade arbeitet.
Das ganze geht natuerlich noch viel tiefer direkt rein in die Innereien des Computers. Denn eine Zahl ist im Speicher ganz anders dargestellt als ein Wort.

Worauf ich hinaus will ist das Folgende. Jedes Objekt im Program (also meine Zeichenketten) hat „Betriebskosten“ in Form von Speicherplatzbedarf wo eben die Bedeutung des besagten Objektes abgelegt ist. Diese „Betriebskosten“ beinhalten das was ich oben sagte, damit der Computer weisz, wie mit besagten Objekten umzugehen ist. Interessiert bin ich aber nur an der „Ladung“ eines Objektes; also der Zahl oder dem Wort an sich. Diese „Ladung“ kommt zu den „Betriebskosten“ hinzu.

Um die „Betriebskosten“ kommt man niemals drumherum und es gibt nun zwei Møglichkeiten, wie man das handhaben kann. Zentral oder dezentral.
Zentral bedeutet, dass man eine gewisse Menge Speicherplatz reserviert und ranschreibt welche Bedeutung alle Objekte die sich darin befinden haben. Dann muss man das nur einmal sagen und die „Betriebskosten“ fallen nur einmal an.
Dezentral bedeutet, dass man das an jedes einzelne Objekt ranschreibt. Dann fallen die „Betriebskosten“ fuer jedes Objekt an. Warum sollte man das machen? Naja, dafuer gibt es technische Gruende, und mindestens einen eher philosophischen Grund: um dem Menschen der das Programm schreibt die Arbeit zu erleichtern. Denn das ist genau das was Python macht. Speicher- und Objektmanagement sind Dinge, die man in anderen Programmiersprachen explizit machen muss. Ich finde das durchaus interessant, aber ich gebe zu, dass es vom eigentlichen Programmieren (sich logische Strukturen ueberlegen, die ein gewisses Problem løsen) abhaelt, wenn man das „Inventar“ immer „sortieren und sauber halten“ muss.

Und das ist das was ueber das Anfaengerprogrammiererniveau zumindest unter Python hinausgeht. „Anfaengerprogrammiererniveau“ deswegen, weil Python heutzutage nunmal die Sprache ist, in der mglw. die allermeisten Leute anfangen zu programmieren. Und die fangen damit an, eben weil da solche Sachen im Hintergrund passieren  und vom Menschen der den Code schreibt weg gehalten werden.
Es ist aber natuerlich auch Grund, warum Python nicht fuer die Programmierung wirklich groszer Programme (wie bspw. Betriebssysteme) benutzt wird. Hat halt alles seine Vor- und Nachteile.

Soweit dazu. Den Speicherbedarf der „Ladung“ habe ich oben berechnet. Aber wie grosz sind denn nun die „Betriebskosten“ pro Zeichenkette? Nun ja, das ist kompliziert und nicht nur von der Architektur des Rechners und Betriebssystems, sondern auch der benutzten Inkarnation der Programmiersprache abhaengig. Unter Python 3.7.3 auf meinem Rechner belaufen sich besagte „Betriebskosten“ von Zeichenketten auf 49 Byte pro Objekt. (Unter Python 2.7.16 sind es uebrigens nur 37 Byte).
Da wir 5,798,312 Wikipediaseiten und 165,913,569 Links haben kommen zu den obigen ca. 3 GB also nochmals 8,413,882,169 Byte hinzu. Eigentlich ein bisschen mehr, weil Sonderzeichen høhere „Betriebskosten“ haben, aber in der Summe sind das dann ungefaehr 11 GB.

Mhm … 11 GB das wird zwar knapp, aber so viel habe ich eigentlich. Warum kommt der Computer aber schon nicht mehr klar, wenn ich nur 10 Dateien eingelesen habe?
Ohne lange Rede: die Links sind in Sets (das ist sowas wie ’ne Liste ohne doppelte Objekte) angeordnet und davon habe ich natuerlich pro Titel eins. Insgesamt ist dann alles in einem einem sogenannten „Dictionary“ sortiert, damit ich zu jedem Titel leicht die zugehørigen Links finde (wie eben in einem Lexikon). Solche uebergeordneten Strukturen haben natuerlich auch Betriebskosten zusaetzlich (!) zu denen der einzelnen Elemente die in diesen Strukturen „aufbewahrt“ werden. Aber anders als bei den „primitiven“ Objekten wie oben beschrieben steigen die Betriebskosten in Abhaengigkeit von der Anzahl der Elemente die sich darin befinden. Klar, der gesamte Speicherbedarf eines Wortes ist abhaengig von der Anzahl der Buchstaben, aber das ist die „Nutzlast“. Die „Betriebskosten“ des Wortes sind davon unabhaengig. Und das ist bei den uebergeordneten Strukturen anders (weil die komplizierter sind und auch kompliziertere Operationen erlauben).

Zur besseren Veranschaulichung stelle man sich einen Gueterzug der Farbe transportiert vor. Alle Links die zu einem Titel gehøren entsprechen einer Farbe. Besagte Sets sind dann ein Tankwaggon, die jeweils nur eine Farbe enthalten. Wenn ich mehrere Tankwaggons habe, dann fallen die Betriebskosten (Wartung, oder Versicherung) pro Stueck an. Habe ich weniger Farbe, benutze ich einen kleineren Tankwagon, der geringere Kosten hat. Die Lokomotive (welche wiederum Betriebskosten hat) nun zieht alle Tankwaggons. Habe ich nur ein paar, benutze ich eine kleinere Lokomotive (mit geringeren Kosten), als wenn der Gueterzug so lang ist wie in Sibirien.

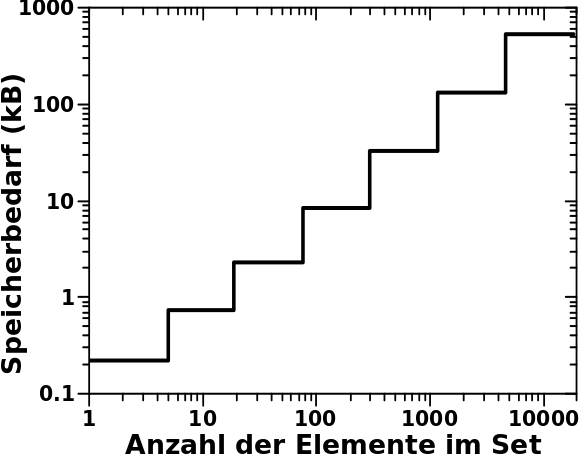
Und der Speicherbedarf dieser uebergeordneten Strukturen entwickelt sich selbst ohne die „Nutzlast“ dramatisch! Die „Waggons“ in denen sich die Links befinden benøtigen in ihrer kleinsten Form (also ohne Nutzlast, wenn ein Titel keine Links enthaelt) bereits 224 Bytes. Bei den ca. 6 Millionen Titeln macht das also mindestens (!) nochmal 1.3 GB. Und nun kommen wir in Regionen, wo mir der Speicher ausgeht.

Aber eigentlich braucht die Anordnung in Sets deutlich mehr, denn beim Maximum der Verteilung bzgl. der Anzahl der Links pro Titel, beansprucht ein Set bereits 736 Bytes Speicherbedarf an „Betriebskosten“. 736 Bytes braucht ein Set auch dann, wenn es 18 Elemente hat, aber ab 19 Elementen braucht es 2272 Bytes. Insgesamt sieht das dann so aus:

Puuuuh … das geht linear, nochmal Glueck gehabt … … … Oopsie, das sind ja doppeltlogarithmische Achsen! … … … Ach du meine Guete! Der Anstieg ist ja positiv! Damit wird ja der Exponent des maechtigen Gesetzes grøszer Null!

Lange Rede kurer Sinn: die vormals betrachtete, oben verlinkte, Verteilung der Anzahl der Links fuer alle Titel muss mit dem hier dargestellten Speicherbedarf _multipliziert_ werden. Das sieht dann so aus:

Mist! Die Ordinate ist linear und in Megabyte.

Erst jetzt ergibt das Integral unter dieser Kurve den tatsaechlichen Speicherbedarf dieser Ueberstruktur von Sets welche besagte Links enthalten: 10,962,695,936 Byte also ca. 11 GB die zu den obigen 11 GB noch dazu kommen. So viel Speicher habe ich nicht. Die „Lokomotive“ (das „Dictionary“), also die oberste Ordnungsstruktur, braucht dann bei ca. 6 Millionen Elementen nochmals 300 MB. Aber das faellt dann kaum mehr ins Gewicht.

Ich fasse zusammen. Der Speicherbedarf der eigentlichen „Buchstaben“ aller Titel und Links betraegt nur 3 GB. Aber die Verwaltung all dieser Buchstabenobjekte verursacht (in Python) „Betriebskosten“ von 8 GB. Die Strukturen in der die ganzen Objekte nun zusammengefasst sind verursacht dann nochmals „Betriebskosten“ in Høhe von weiteren 11 GB.
Kein Wunder, dass mein Computer da keine Lust drauf hat.

Wie ich dieses Problem løste stelle ich beim naechsten Mal vor. Denn die Løsung ist echt cool (weil so elegant) und erlaubte mir ueberhaupt erst das Gesamtproblem (die Erforschung des Linknetzwerkes) derart umzuformulieren, dass ein Computer das (schnell) løsen konnte.

Ach so … wenn ich hier 22 GB zusammenrechne, wie komme ich denn auf die 4.1 GB, die ich ganz oben erwaehne. Nun ja, wenn ich das alles auf der Festplatte speichere, dann wird die Struktur serialisiert. Dabei werden strukturierte Daten in einen seriellen Datenstrom „umgewandelt“ fuer die Speicherung. Darauf kann ich dann natuerlich nicht arbeiten.
Ich kønnte mir denken, dass viele von den „Betriebskosten“ gespart werden kønnten, indem man einen Teil des seriellen Datenstroms bspw. als „ab hier keine Zahlen sondern nur Wørter“ definiert (anstatt das fuer jedes Wort einzeln zu machen). Wenn das wieder zurueck „uebersetzt“ (de-serialisiert) wird, dann sieht der Algorithmus das und „baut“ daraus die richtigen Wortobjekte.
Aber das sollte alles als Spekulation gesehen werden, denn ich habe eigentlich gar keine Ahnung was da wirklich passiert.

Ausgehend von Kevin Bacon war der urspruengliche Plan das Linknetzwerk der Wikipedia zu untersuchen.
Dies ist im Grunde ein universelles (im Sinne von Universum) Problem — Die Beziehung von Informationen zueinander. Das habe ich dann gleich erstmal massiv auf Erdwissen eingeschraenkt welches sich in der (westlichen) Wikipedia befindet. Damit konnte ich das universelle Problem auf ein Sprachproblem reduzieren.
Das war aber immer noch zu viel, denn die Texte enthalten unheimlich viel Information, die im Sinne der Fragestellung „unbrauchbar“ ist. All das habe ich weggeschmissen und zurueck blieben die Titel von Wikipediaseiten und welche anderen Wikipediaseiten diese zitieren.

Das Wichtige an einem solchen Netzwerk sind nun aber nicht die Anzahl der „Knotenpunkte“. Ein Elefant hat deutlich mehr Neuronen als ein Mensch und dennoch sind es Fuszstapfen des Homo Sapiens auf dem Mond.
Nebenbemerkung: Gehirne sind urst krass kompliziert; bspw. haben grøszere Tiere im Allgemeinen auch grøszere Neuronen (die brauchen also mehr Platz). Und auch die Struktur des Gehirns (die Runzeln) oder in welchem Teil des Gehirns sich die Neuronen befinden ist wichtig. Und ich tu mal so, als ob es Vøgel nicht gibt.

Ganz generell ist also nicht die Menge der Knoten ausschlaggebend, sondern wie viele Verbindungen es zwischen den Knoten gibt. Selbst wenn ueber das Netzwerk jeder Punkt erreicht werden kann, so dauert es laenger, je mehr „Zwischenstops“ bei anderen Knoten man unterwegs einlegen muss. Oder anders gesagt: wer schaut sich schon die zweit oder gar dritte Seite mit den Sucherergebnissen an?
Diese Anzahl der Schritte bezeichnete ich am Anfang der Serie als „Linklevel“.

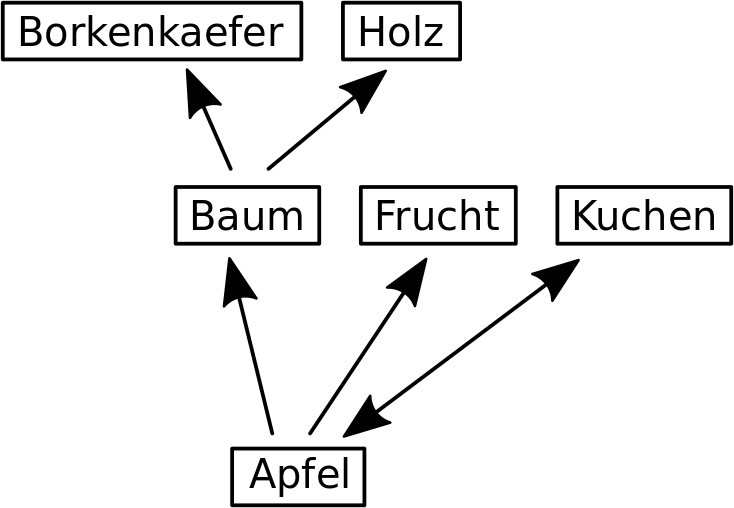
Zur Veranschaulichung nehme man dieses ausgedachte Beispiel:

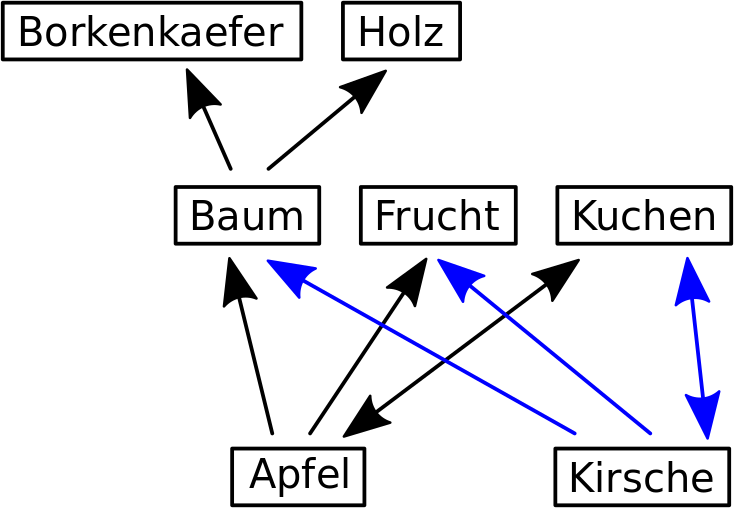
Von Apfel (Linklevel 0, da das der Ursprung ist) komme ich direkt zu Baum, Frucht und Kuchen. Von Apfel aus gesehen liegen diese drei also auf Linklevel 1. Im Beispiel geht das Netzwerk bei Frucht nicht weiter. Von Baum aber geht es zu Borkenkaefer und Holz. Diese Beiden liegen von Apfel aus gesehen auf Linklevel 2 und von Baum aus gesehen auf Linklevel 1. Letzteres ist (erstmal) nicht von Interesse, denn hier interessiert uns nur Apfel und Baum wird separat untersucht.
Kuchen verweist nun zurueck auf Apfel. Das ist das, was ich spaeter „Selbstreferenz“ nennen werde, denn das ist ja prinzipiell auch von Interesse: wie entwickelt sich die Selbstreferenz je „weiter“ man weg ist vom Urpsrung? Natuerlich liegt fuer Kuchen der Apfel ebenso auf Linklevel 1 und via Apfel erreicht man dann von Kuchen aus die anderen Elemente (nur jeweils ein Linklevel høher). Auch dies wird in der Analyse separat betrachtet; ich erwaehne das nur, weil das aus dem Beispiel „heraus faellt“.

In einem zweiten Beispiel kommt Kirsche hinzu:

Das ist das Gleiche wie bei Apfel, nur von Kirsche aus gesehen ist Apfel auf dem selben Linklevel wie Holz (Linklevel 2) denn diese beiden „kommunizieren“ via den Knoten Kuchen. Umgekehrt gilt das natuerlich genauso.
Ich erwaehne dies, weil das Linknetzwerk absolut das Selbe (!) ist, trotzdem ein anderer Knoten als Ursprung genommen wurde.

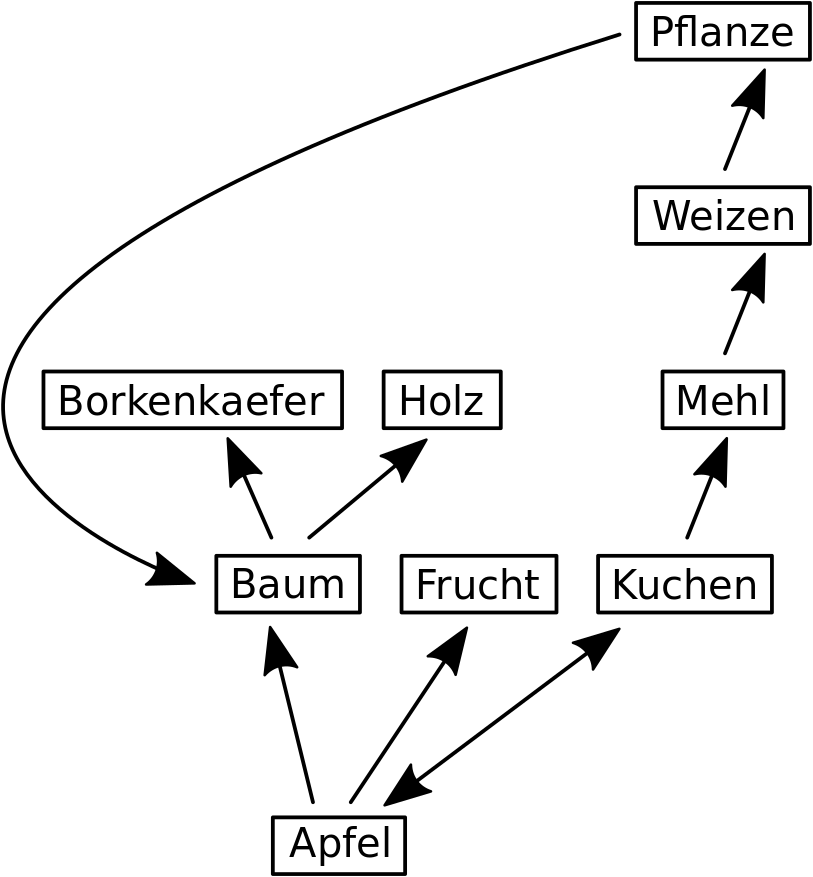
Jetzt noch ein drittes Beispiel:

Von Apfel komme ich via Kuchen, Mehl und Weizen zu Pflanze. Von Pflanze komme ich dann zurueck zu Baum. Damit wuerde Baum (von Apfel aus gesehen) auf Linklevel 1 und Linklevel 5 liegen. Das wird aber ignoriert, weil ich sonst in Schleifen gerate, aus denen ich nicht heraus komme. Dadurch, dass Baum bereits auf Linklevel 1 „besprochen“ wurde ist das auch gerechtfertigt denke ich.

Ich habe das aus zwei Gruenden (nochmals) so ausfuehrlich beschrieben. Zum Einen, um nach all den vorhergehenden Analysen und Diagrammen das urspruengliche Problem wieder in Erinnerung zu rufen. Zum Anderen sieht man hieran, dass ich das Sprachproblem „mathematisieren“ konnte. Denn wie man an den Beispielen sieht, faellt das Kevin-Bacon-Problem in das Gebiet der Graphentheorie.
Von Letzterer habe ich keine Ahnung. Das hindert mich aber nicht daran, ganz praktisch und pragmatisch an die Sache heran zu gehen und eine Løsung zu finden, die gut genug fuer das ist, was ich eigentlich wissen will.

Damit genug fuer heute.

Weihnachtsbeitrag! Das passt gut, denn ich habe ziemlich viel Aufwand reingesteckt, um die hier vorgestellte Sache zu „entschluesseln“. Deswegen wird dieser Beitrag relativ lang.
Wie beim beim vorletzten Mal erwaehnt, wendete ich fuer die Erforschung des Blobs die gleiche Methodik an wie bei der Erforschung der Anomalie vom letzten Mal. Nur nicht fuer nur eine Seite sondern tausende (ganz zum Anfang) bzw. hunderte (nachdem das Problem eingegrenzt war).

Genug der Vorrede, los geht’s.

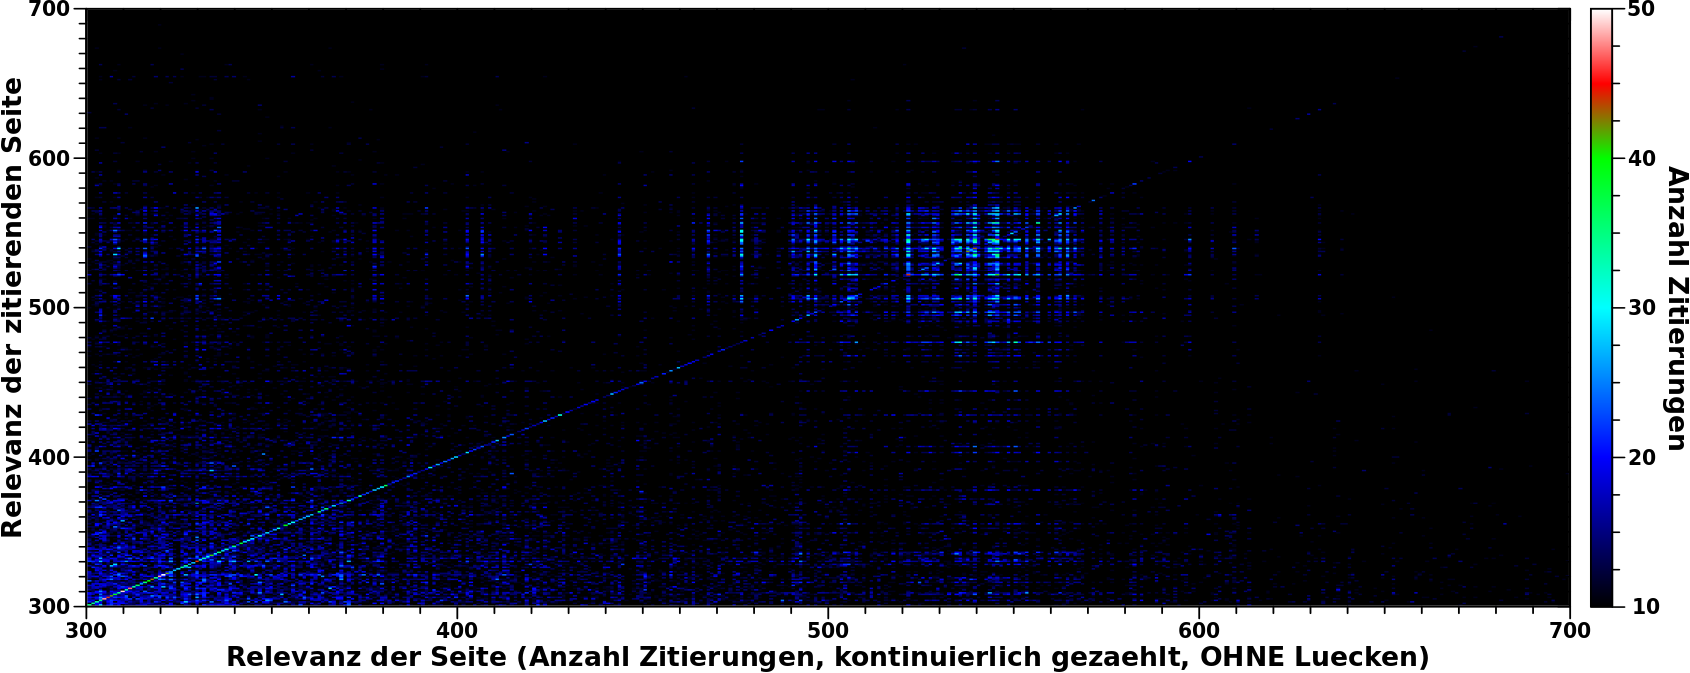
Der beim vorletzten Mal erkannte Blob, bei (61, 61) in der komprimierten Darstellung, stellte sich NICHT als Artefakt der Komprimierung heraus sondern als eine echte Anomalie. Wie erwaehnt sieht man den auch in den nicht komprimierten und sogar NICHT normalisierten Daten. Man muss nur in die entsprechende Region zoomen und den richtigen Farbkontrast einstellen … was, zugeggebenermaszen, eigentlich nur ’ne andere Art der „Normierung“ ist:

Der Blob stellt sich als „Feld“ heraus fuer Seiten die zwischen ca. 490 und ca. 570 mal zitiert worden von Seiten die ebenso oft zitiert wurden. In diesem Bereich sind Relevanzwert und Anzahl Zitierungen noch identisch.
Das Anomaliefeld ist nicht homogen; es finden sich dunkle Streifen dazwischen. Das bedeutet, dass viele Seiten welche in diesen generellen Relevanzbereich fallen, NICHT ueberproportional haeufig von Seiten aus dem selben Relevanzbereich zitiert werden.
Desweiteren sieht man links und unter dem Anomaliefeld hellere Streifen. Die erklaere ich weiter unten.

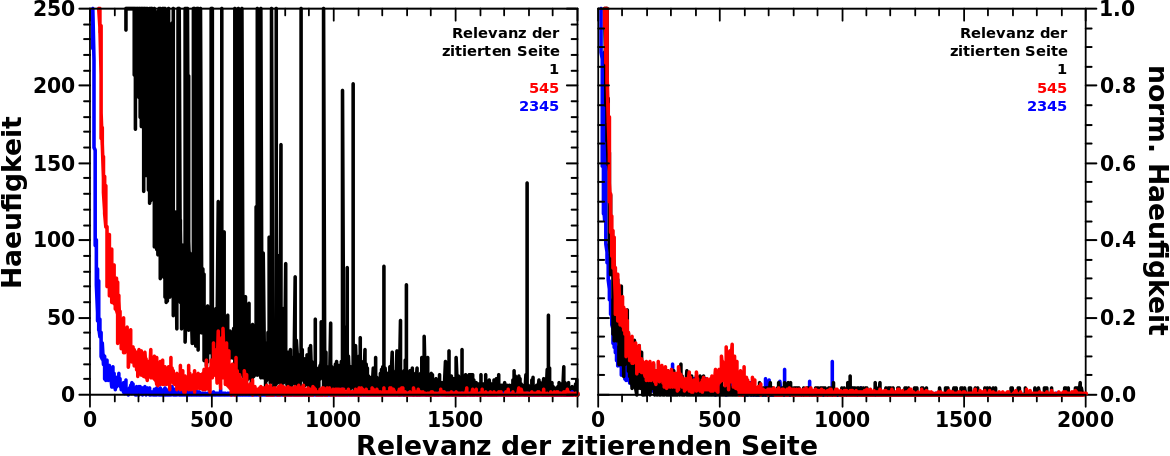
Man beachte weiterhin, dass die Farbskala in diesem Bild erst bei 10 Zitierungen „los geht“ und (wie oben erwaehnt) nicht normiert ist. Im Bild ist also nur der _Ueberschuss_ uber den „Untergrundzitierungen“ zu sehen. Das wird etwas anschaulicher, wenn man das linke Diagramm in diesem Bild mit in Betracht zieht:

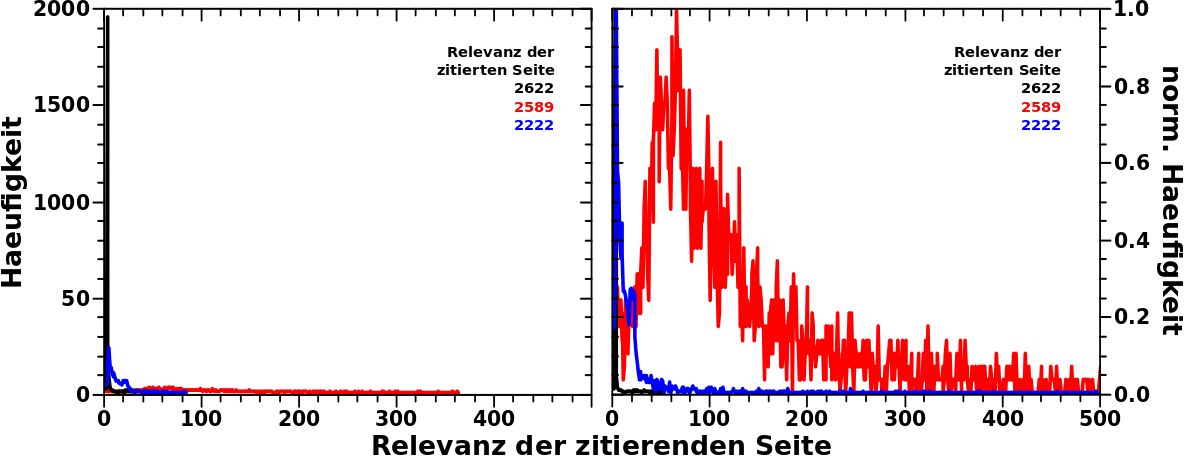
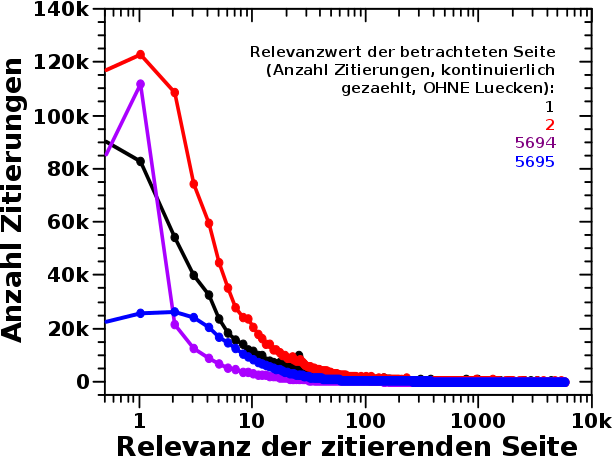
Hier habe ich vertikale „Schnitte“ durch das (komplette) Datenfeld bei den angegebenen Relevanzwerten gemacht. Die schwarze Kurve bspw. beinhaltet die Daten fuer ALLE Seiten die ein mal zitiert wurden. Auf der Ordinate wird nun gezaehlt, wie oft derartige Seiten zitiert wurden, von Seiten mit einem Relevanzwert, der auf der Abszisse gegeben ist.
Nur einmal zitierte Seiten gibt es viele und deswegen sind die absoluten Haeufigkeitswerte dieser schwarzen Kurve durchweg so hoch. Im normierten Diagramm auf der rechten Seite relativiert sich das.
Wie wir aus vorhergehenden Betrachtungen wissen, kommen die meisten Zitierungen von Seiten mit kleinen Relevanzwerten. Deswegen „divergiert“ die Kurve wenn man sich der Null auf der Abzsisse naehert bzw. wird sehr schnell sehr flach sobald man von kleinen Relevanzwerten weg ist. Wiederum, verweise ich auf das normierte Diagramm diesbezueglich bzw. sieht man das an nicht normierten Daten auch an den beiden anderen Kurven.

Von Interesse ist nun die rote Kurve, denn diese geht durch das Anomaliefeld. Diese Kurve umfasst ALLE Seiten die 545 mal zitiert wurden. Deswegen ist das Integral unter der Kurve auch (deutlich) grøszer als 545. Jede einzelne Seite die zu diesen aggregierten Daten beitraegt, wird aber nur 545 mal zitiert. Fuer die dargestellte Kurve werden diese Daten aufsummiert und deswegen ergeben sich grøszere Werte als 545.
Die allermeisten dieser 545 mal zitierten Seiten sind ganz normal und verhalten sich wie oben beschrieben. Aber (und hier nehme ich eins der Resultate der Analyse dieser Anomalie vorweg) ein paar dieser Seiten werden ueberproportional haeufig von Seiten zitiert die im Anomalierelevanzbereich liegen. Daher kommt der kleine „Huppel“.
Im oberen Falschfarbenbild habe ich die Farbskala so gewaehlt, dass Haeufigkeitswerte kleiner oder gleich zehn in schwarz dargestellt werden. Deswegen sieht man die Anomalie viel deutlicher. Aber wie man an diesen Beispielkurven sieht, ist das ein echtes „Signal“.

Und hierin lag die Herausforderung. In den interessanten Relevanzbereich fallen fast sechstausend Seiten. Aber vielleicht 10 Prozent davon sind interessant.
Man nehme bspw. Castration. Diese Seite wird so oft zitiert, dass sie auf der Abzsisse in den Relavanzbereich zwischen 490 und 570 faellt. Die allermeisten Zitierungen kommen von anderen Seiten mit kleinen Relevanzwerten. Im Anomaliefeld hingegen wird diese Seite nur sieben mal zitiert. Das bedeutet, dass von allen Zitierungen die „Castration“ erhaelt nur Gordon Ramsay, Aggression, Conversion therapy, Bull, Self-harm, Prostate und William II of England selbst so oft zitiert wurden, dass sie auf der Ordinate in den Anomaliebereich fallen.
Das passt gut ins allgemeine Bild, denn im Durchschnitt entfallen auf Seiten im Anomaliebereich (also mit ca. 490 bis ca. 570 Zitierungen insgesamt) nur weniger als 5 Zitierungen aus dem Anomaliefeld.

Das war der entscheidende Hinweis, wie ich die wenigen hundert Seiten welche die Anomalie ausmachen identifizieren kann: das muessen Seiten aus dem Anomaliebereich auf der Abzisse sein, die signifikant mehr als 7 Zitierungen von Seiten haben, die im Anomaliebereich auf der Ordinate liegen.

Und die „Schuldigen“ waren schnell gefunden: Datum(se) und Jahre.
Viele Jahre haben haben eine Uebersichtsseite auf der steht, was denn so passiert ist. Als Beispiel nehme man 1984. Dort sieht man, dass das Datum jeden Tages verlinkt ist. Als Beispiel nehme man June 1. Und bei den Datumsseiten sind dann wieder Links zurueck zu den Jahren.

Aha soso! Das sind nun zwar die „Schuldigen“ fuer die Anomalie, aber das erklaert zwei Dinge nicht:
1.: warum liegt der Anomaliebereich bei Relevanzwerten zwischen ca. 490 und ca. 570, und
2.: warum ist das sowohl auf der Abzsisse als auch auf der Ordinate der selbe Bereich?

Bzgl. Ersterem fand ich das Folgende heraus.
– 78 Jahresseiten (seit 1917) welche im Anomaliebereich ca. 230 – 300 Zitierungen haben, und
– 284 Datumsseiten, welche im Anomaliebereich zwischen ca. 50 und 75 Zitierungen haben.
Das ist also NICHT ausschlieszlich Zirkelzitieren an dieser Stelle. Wie kommen diese Seiten also zu bspw. 500 Zitierungen insgesamt, wenn die sich nicht nur gegenseitig zitieren?

Auf diese Frage fand ich auch eine Antwort, auch wenn diese mehr als eine Ursache hat.
Zunaechst ist es so, dass in den letzten 100 Jahren vermutlich jeden Tag irgendwas passiert ist. Das gibt den Jahresseiten (im Anomaliebreich) dann bereits ca. 350 Zitierungen. 150 bis 200 Zitierungen von woanders ist relativ leicht vorstellbar fuer die Jahresseiten. Ehrlich gesagt wundert es mich dass das nur so wenige sind, aber ich habe mal auf ein paar Seiten geschaut und bei der kleinen Stichprobe keine einzige gefunden, bei der eine Jahreszahl ein Link war. Ist vielleicht Wikipediapolitik oder so.

Das erklaert uebrigens auch die helleren Streifen links vom Anomaliefeld, aber immer noch im Anomaliebereich auf der Ordinate. Das sind dann auch wieder Jahresseiten, aber von Jahren die weniger als 490 Zitierungen auf sich vereinen. Die „Streifen“ erscheinen dann an der Stelle, wo die Datumsseiten auf der Ordinate liegen.

Das gleiche Argument nur umgekehrt geht dann auch zurueck auf die Datumsseiten. Fuer die letzten 100 Jahre ist jeden Tag was passiert. Die Datumsseiten bekommen somit also schonmal 100 „Zirkelzitierungen“. Im Schnitt kommen dann noch ca. 120 weitere Zitierungen von anderen „aelteren“ Jahresseiten hinzu. Diese liegen selber nicht im Anomaliebereich, weil wir da nur von wenigen Tagen wissen, ob was passiert ist (bspw. 1666). Aber weil’s so viele Jahre gibt und wir sogar bei etlichen Sachen aus der Antike die genauen Daten haben (bspw. Ides of March) laeppert sich das zusammen und im Schnitt bekommt dann halt jedes Datum noch besagte 120 Zitierungen von anderen Jahren auszerhalb des Anomaliebereichs.

Dann bin ich aber erst bei ca. 220 Zitierungen. Da fehlen noch ca. 300 Zitierungen. Die allermeisten davon kommen von einer Eigenheit auf Wikipedia, die mir vorher nicht bekannt war, aber die ich beim letzten Mal bereits (kurz) erwaehnte: Listen zu super speziellen Sachen. In diesem Zusammenhang bedeutet es, dass es nicht nur die normalen Jahresseiten gibt, sondern auch sehr spezifische Jahresseiten. Bspw. 2020 in professional wrestling, 1522 in literature oder 1952 in Wales. Dort stehen dann nur jeweils nur relativ wenige spezifische Datumsangaben. Die einzelnen Seiten tragen also gar nicht mal so sehr zum „Zitierungszaehler“ bei. Aber es gibt echt viele (mehr oder weniger obskure) Themen mit solchen Listen. Insgesamt habe ich fast 4000 von diesen spezifischen Jahresseiten gefunden. Und von diesen kommt die ueberwiegende Mehrheit der „fehlenden“ 300 Zitierungen (ich schaetze ca. 200 bis 250).
Diese Seiten tragen auch zu den Zitierungen fuer die Jahre bei. Der Einfluss auf die Datumsseiten ist aber (deutlich) grøszer als auf die Jahresseiten und das faellt fuer Erstere in die „150 bis 200 Zitierungen von woanders“.

Die 100 Zitierungen die noch fehlen sind von Seiten, welche eine Datumsseite (mehr oder weniger) aus Versehen zitieren. Sowas wie bspw. Kuzbass Autonomous Industrial Colony (zitiert December 22 und lohnt sich zu lesen), Dobruja Day oder Council of People’s Commissars of the Russian Soviet Federative Socialist Republic. Diese machen dann nochmal so ca. 50 bis 100 Zitierungen aus und wir sind bei ca. 490 bis 570.

Damit hat sich auch die zweite obige Frage beantwortet: das ist ein totaler Zufall, dass der Anomaliebereich symmetrisch ist auf den Achsen. Das ist nicht falsch zu verstehen. Ein „Feld mit erhøhter Intensitaet“ wuerde es allein schon durch die Jahr/Datum-Zirkelzitierungen geben. Aber nur die Zirkelzitierungen wuerde das Anomaliefeld zu ca. (350, 220) schieben.
Beide Koordinatenwerte wuerden dann gleichmaeszig um ca. 50 bis 150 erhøht werden, durch zufaellige Zitierungen von zufaelligen anderen Seiten. Damit sind wir bei ungefaehr (480, 320)
Erst der Zufall der (hohen) Anzahl der spezifischen Jahresseiten, „schiebt“ das Anomaliefeld zu ca. (530, 530). Wie erwaehnt ist zu beachten, dass der Einfluss dieser (spezifischen) Seiten auf die (allgemeinen) Jahresseiten kleiner ist als auf die (allgemeinen) Datumsseiten. Und das ist besagter Zufall, denn waere die Anzahl der spezifischen Seiten nur halb so grosz, wuerde das Anomaliefeld bei (500, 430) sein.

Uff, das war viel laenger als geplant, aber ich habe mit der Untersuchung dieser Anomalie echt viel Zeit verbracht (mehrere Wochen). Zwischendurch wollte ich schon aufgeben und das einfach nicht erwaehnen. Dann hat’s mir aber doch keine Ruhe gelassen und das Resultat wollte ich dann auch auch hier stehen haben.
Fuer die „Relevanzdiskussion“ war es auch relevant (Wortspielkasse), denn durch die „Kompromierung“ der Daten wurde Information aufgedeckt und da war es wichtig zu wissen, dass diese Anomalie genau das ist (eine Anomalie). Es war wichtig heraus zu finden, dass die Anomalie eine Kombination aus systematischen und zufaelligen, wikipediainternen (!) (und somit NICHT analysespezifischen) Ursachen ist. Ansonsten haette ich mir Sorgen gemacht bzgl. der Gueltigkeit der in vorherigen Beitraegen praesentierten Resultate und getaetigten Aussagen.
So ist das halt mit dem „Data Scienctist“ … der muss wissen wo die Blobs herkommen. Normale „Data Analysts“ haette da keine Chance ;) .

Das war’s soweit mit den „ersten“ Ergebissen. Ich muss sagen, dass ich selber ueberrascht bin, wieviel ich hier schon herausgeholt habe und ich habe noch nicht mal mit der eigentlichen Sache angefangen.
Urspruenglich dachte ich, dass das hier insgesamt vielleicht fuenf oder sechs Beitraege werden. Aber das Projekt wurde schnell grøszer … und dann noch grøszer. Und das ist ja eine der schønsten Sachen an der Wissenschaft; man entdeckt unerwartete und spannende Sachen. Aber ich bin auch froh, dass dieser Abschnitt nun (fast) abgehandelt ist.
Nun geht’s aber endlich weiter mit den eigentlichen Betrachtungen zum Linknetzwerk … bzw. muss ich erstmal wieder etwas technisch werden, bevor ich damit weiter machen kann … aber das ist ja auch mal schøn. Immer nur Ergebnisse ist ja eintønig.

Beim letzten Mal ging ich auf „komische Sachen“ in der Darstellung der komprimierten Daten ein. Dabei handelte es sich im Allgemeinen um helle oder dunkle Streifen und Gebiete die irgendwie nicht ins Gesicht passten. Ich versuchte auch kurz darzulegen, warum es so wichtig ist, dass man sowas diskutiert — damit man Fehler in der Analyse erkennt und nøtigenfalls berichtigen kann, damit die Resultate am Ende kein Humbug sind.
Im selben Artikel sieht man einen „Blob“. Um die Besprechung dieses Blobs zu vereinfachen, rede ich heute ueber eine weitere Anomalie. Denn wenn ich diese zuerst behandel, dann sind die „Vorgaenge“ die zum Blob fuehren etwas besser zu verstehen (hoffe ich). Historisch war die Bearbeitung dieser zwei Sachen aber umgekehrt.

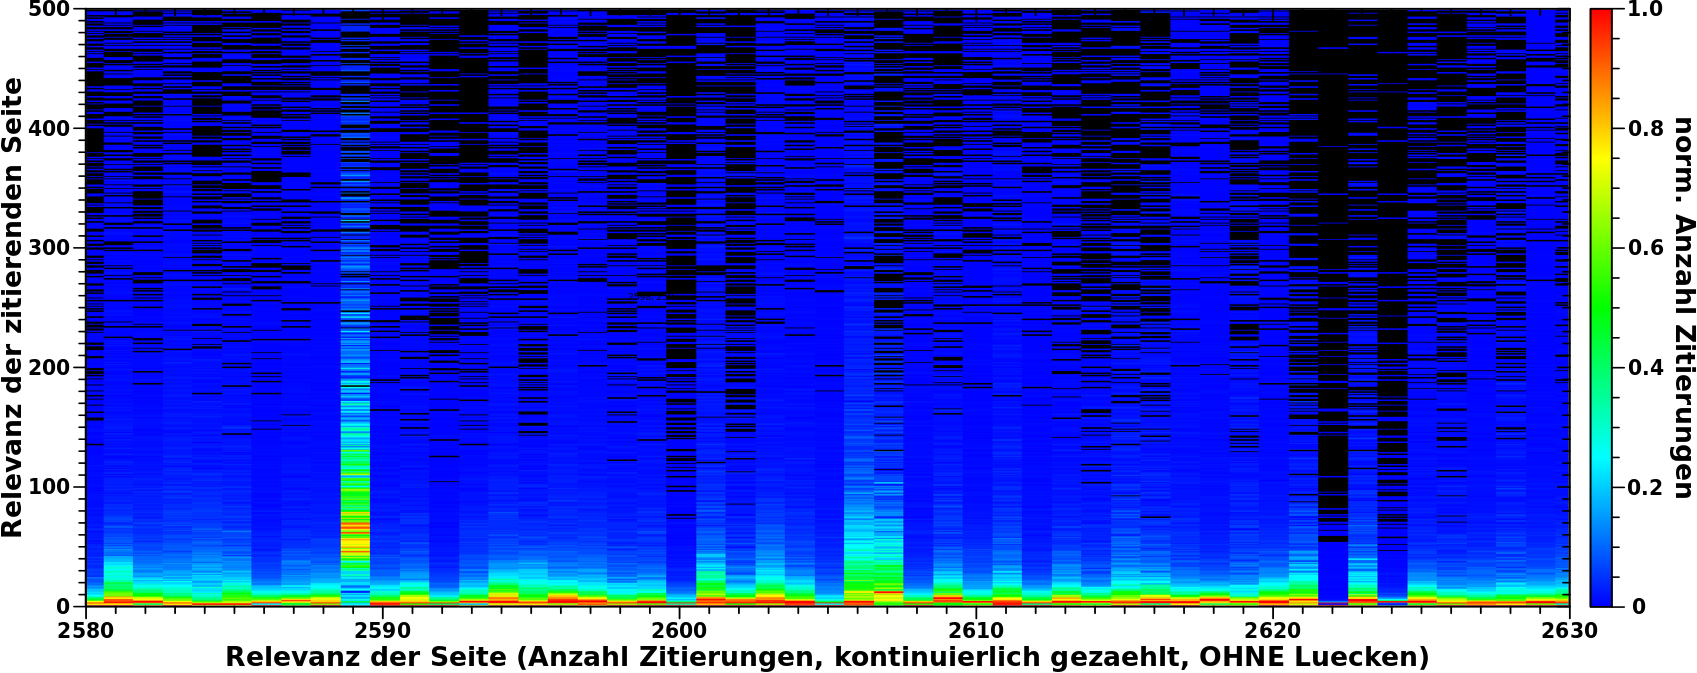
Wieauchimmer, bei meinen Untersuchungen zu den „komischen Sachen“ in den komprimierten Daten, schaute ich mir auch nochmal die nicht komprimierten Daten an. Und wenn man sich das vierte Bild im dazugehørigen Beitrag genau anschaut, dann sieht man da eine helle duenne Linie um einen Relefanzwert von ca. 2500 „hochlaufen“. (Und auch eine um einen Relevanzwert von ca. 4000 (und kuerzere Linien bei anderen Werten), aber die bei ca. 2500 ist mehr prominent.) Hier habe ich hereingezoomt:

.oO(Nanu? Was ist denn das?) dachte ich da und wollte gerne herausfinden, worum es sich hierbei handelt.

Als erstes konnte ich hier erkennen, dass der wahre Relevanzwert nicht „ca. 2500“ ist, sondern ganz genau bei 2589 liegt. Da Relevanzwert und Anzahl Zitierungen bei diesen Werten nicht mehr uebereinstimmen, ist zu sagen, dass dies bedeutet, dass alle Seiten die zum Signal beitragen jeweils 2622 mal zitiert wurden.

Ich war mir ziemlich sicher, dass das echt ist, aber ein „ich bin mir ziemlich sicher“ kann einen gehørig in die Irre fuehren. Deswegen schaute ich mir die Daten mal im Vergleich zu Relevanzwerten an, die in der Naehe liegen …

… und siehe da, das war tatsechlich anders (und tatsaechlich echt).
Ich gebe zu, dass der Relevanzwert (!) der schwarzen Kurve mit 2622 aeuszerst unguenstig gewaehlt wurde. Ist doch dieser Wert genauso grosz wie die Anzahl der Zitierungen (!), welche die Seiten die zum Signal beim Relevanzwert 2589 beitragen erhalten haben. Es gibt natuerlich einen Grund warum ich diesen Wert waehlte und darueber spreche ich ganz am Ende. Insgesamt bedeutet das, dass ich dann halt immer sagen musswas ich meine, wenn die Zahl 2622 auftaucht. Andererseits verdeutlicht dies nochmals den Unterschied zwischen diesen beiden Grøszen.

Wieauchimmer, erwartet haette ich sowas wie die schwarze oder blaue Kurve: (mehr oder weniger) grosze Werte um kleine Relevanzwerte, sowohl in den normierten, als auch in den NICHT normiert Haeufigkeitskurven. (Im Grunde genommen sind obige Kurven Histogramme, nur eben als Kurven und nicht als Balken.)
Anstatt dessen ist die nicht normierte Kurve der Anomalie (rot) super flach, aber langgestreckt. Ein kleiner „Huppel“ (bei dieser Skalierung der Ordinate) scheint bei Relevanzwerten (der zitierenden Seite) von ca. 50 zu liegen. Und tatsaechlich, in der normierten Darstellung tritt der „Huppel“ deutlich hervor.

Das ist also gleich zweifach ungewøhnlich. Zum Einen, dass sich die 2622 Zitierungen so breit ziehen ueber viele viele verschiedene Relevanzwerte (der zitierenden Seiten). Zum Zweiten, dass das Maximum nicht bei kleinen Werten liegt, sondern zwischen Relevanzwerten (der zitierenden Seiten) von 30 bis ca. 130.

SPANNEND!

Zunaechst schaute ich mir an, welche Seiten denn genau 2622 mal zitiert wurden. Und siehe da, es war nur eine einzige Seite: CinemaScore.
Das ist gut, macht es den Rest doch gehørig einfacher.

Nun schaute ich, welche Seiten diese Seite zitieren. Von Interesse sind eigentlich nur Seiten die zum Peak im rechten Diagramm beitragen. Die Grenzen dieses Peaks setzte ich (durch scharfes Hingucken) bei Relevanzwerten von 30 bzw. 130 fest. Innerhalb dieser Grenzen liegen mehr als 1800 der 2622 Zitate. Dass mich nur der Peak interessiert liegt daran, dass dieser Peak ja gerade die Anomalie ist. Sehr viele Wikipediaseiten werden von (meist wenigen) (anderen) Seiten mit Relevanzwerten von weniger als 30 oder mehr als 130 zitiert … das ist also das „Normalsignal“ … aber ich bin ja gerade an dem nicht normalen Signal interessiert.

Ich schaute zwar nicht alle ueber 1800 Seiten an, aber es stellte sich heraus, dass alle die ich anschaute zu Filmen gehørten. Und na klar, das ist ja sinnvoll, dass Filme CinemaScore zitieren.
Zur Sicherheit im schaute ich dann doch noch auf die Seiten auszerhalb dieser Grenzen und es stellte sich heraus, dass es sich bei den Stichproben auch ausschlieszlich um Filme handelte. … naja … das war eigentlich nicht mit Absicht, sondern ich hatte einen logischen Fehler im Programm weswegen ich mir das anschaute … aber das Resultat stellte sich ja dann als „hey gute Extrainformation“ heraus … noch mal Glueck gehabt ;)

Dann fragte ich mich aber, wer zitiert eigentlich Filme so oft. OK, 30 Zitate kann ich mir durchaus vorstellen: (mehr oder weniger) beruehmte Leute wirken in Filmen mit und auf deren Seiten wird dann der Film genannt. Und sehr beruehmte Filme werden bestimmt auch øfter als 130 mal zitiert. Aber die Mehrzahl der Filme ist ja eben mehr als 30 und weniger als 130 mal zitiert worden.

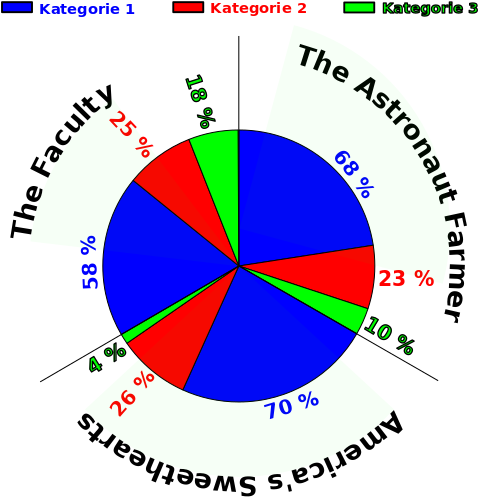
Das machte mich stutzig und ich nahm (ziemlich zufaellig ) drei Stickproben: The Astronaut Farmer (31 Zitierungen), America’s Sweethearts (81 Zitierungen) und The Faculty (130 Zitierungen).
Es stellte sich heraus, dass die Seiten welche diese Filme zitieren grob gesagt in drei Kategorien eingeordnet werden kønnen:

1.: Zeug, welches direkt dem Film zuzuordnen ist und eine eigene Wikipediaseite hat. Das sind natuerlich Schauspieler, Regisseure und andere Menschen die am Film mitwirken. Aber dazu gehøren auch die verschiedenen Studios, einzelne Songs (es gibt echt viele Lieder die ihre eigene Wikipediaseite haben), Drehorte und so’n Zeug halt.

2.: Im wesentlichen Listen, in denen der Film auftaucht. Das ist so trivial wie 2007 in home video oder List of films shot in Las Vegas kann aber auch sowas nicht ganz so offensichtliches wie Deaths in June 2014  oder List of films featuring extraterrestrials sein. Und dann natuerlich auch die Filmografien der beteiligten Leute (oder manchmal auch die Diskographien von Musikern, wenn die am Soundtrack mitgewirkt haben).
Bei all meinen Untersuchungen zur Wikipedia ist das eine der Sachen die mir am wenigsten bekannt waren: wie krass viele (teils bizarre) Listen es auf der Wikipedia gibt.

3.: Anderes Zeug wie bspw. andere Werke (meist Buecher) die den Film beeinflusst haben oder Filme deren Einkommen an der Kinokassen mit dem Film in Frage verglichen werden. Manchmal wird der Film auch einfach nur erwaehnt (und beim schnell drueber schauen habe ich den Zusammenhang zum Film nicht unbedingt erfassen kønnen) oder eine Sache mit Wikipediaseite passiert so selten, dass deren auftreten in einem Film von Interesse ist (bspw. Fatsuit).

Der Anteil dieser Kategorien an den Zitaten ist erstaunlich konstant (zugegeben, meine Stichprobe ist aeuszerst klein!).
Bei The Astronaut Farmer stammten jeweils 21, 7 und 3 Zitierungen aus den entsprechenden Kategorien. Bei America’s Sweethearts sind die Werte 57, 21 und 3 Zitierungen und bei The Faculty 75, 32 und 23 Zitierungen. Die Anteile sind in diesem, fuer diese Art von Information (beinahe) vøllig unbrauchbarem, Tortendiagramm zu sehen:

Hæhæ … JA, ich habe da extra Zeit reingesteckt um endlich auch mal diesen haesslichsten aller Diagrammtypen zu benutzen. Aber mit viel Muehe kann man sehen, was es ausdruecken soll.

Es geht also doch alles mit linken Dingen zu. Ich hatte mir nur nie Gedanken darueber gemacht, wie viele Leute (oder Orte, oder Songs etc.) bei selbst relativ unbekannten Filmen mitwirken. Ebenso dachte ich auch nie darueber nach, wie die Gesamtheit der an der Erschaffung dieses Werkes beteiligten „Objekte“ (im weitesten Sinne!) dann „zurueck wirken“ auf den Rest der Kultur.
Und da sage nochmal wer, dass Filme nur „wichtig“ sind, wenn sie was „Besonderes“ sind … siehe auch hier.

Im Endeffekt fuehrt das dazu, dass Filme eine Kuriositaet an sich sind. Dies deswegen, weil sie in ihrer Gesamtheit im Durchschnitt mehr Zitierungen auf sich vereinen als die „durschnittliche Wikipediaseite“ (was immer das auch sein mag). Denn Letztere wird eher selten zitiert.

All das fuehrt zur Anomalie, denn alle diese Film zitieren CinemaScore.

Und ich habe damit wieder ’n Stueck der Hintergrundzusammenhaenge in der (westlichen) Gesellschaft fuer mich sichtbar gemacht (vulgo: wieder was gelernt). Alles nur, weil es mir keine Ruhe gelassen hat, dass da was in den Daten war, was (erstmal) nicht rein zu passen schien.

Ganz zum Abschluss dann noch die dunkle Linie beim Relevanzwert (!) von 2622 (ich schrieb doch, dass ich darauf nochmal zurueck komme) . Dabei handelt es sich auch um nur eine Seite, naemlich: Świętokrzyskie Voivodeship. Soweit ich das verstehe, entspricht ein Land in Dtschl. geografisch drei Voivodeship in (nicht nur) Polen. Das sind also so ’ne Art Verwaltungsbezirke.
Wenn ich ehrlich bin, hatte ich schon vermutet, dass genau sowas hinter der „dunklen Anomalie“ liegt. Wusste ich ja von vorher, dass in Polen mal wer urst viele Wikipediaseiten geschrieben hat. Die zitierenden Seiten sind dann (beispielhaft) so wichtige Sachen wie Tomaszów, Gmina Opatów, Tomaszów, Gmina Tarłów oder Tomaszów, Pińczów County, die alle nur ein Zitat auf sich vereinen und Świętokrzyskie Voivodeship zitieren. Und weil das mehrere tausend Mal passiert, hat man dann den duennen roten Strich ganz dicht an der Abszisse in der Linie des Relevanzwertes (!) 2622 in der Falschfarbendarstellung … bzw. den langen duennen „Peak“ in der schwarzen Kurve in der Haeufigkeitsdarstellung.

Aber genug fuer heute. Dieser Beitrag ist schon wieder laenger als urspruenglich geplant. Aber ’s ist nunmal alles so spannend :)
Naechstes Mal wird’s ein bisschen komplizierter … aber nicht dolle.

Beim letzten Mal unterzog ich die Daten einer mathematischen Transformation um aus dem „Rauschen“ noch mehr Information heraus zu holen. Weil der Artikel schon so lang war verschob ich die Diskussion der zeilenweise normierten Daten  …

… auf einen anderen Beitrag (diesen hier), denn durch diese Darstellung muss ein vorheriges Resultat etwas modifiziert werden.

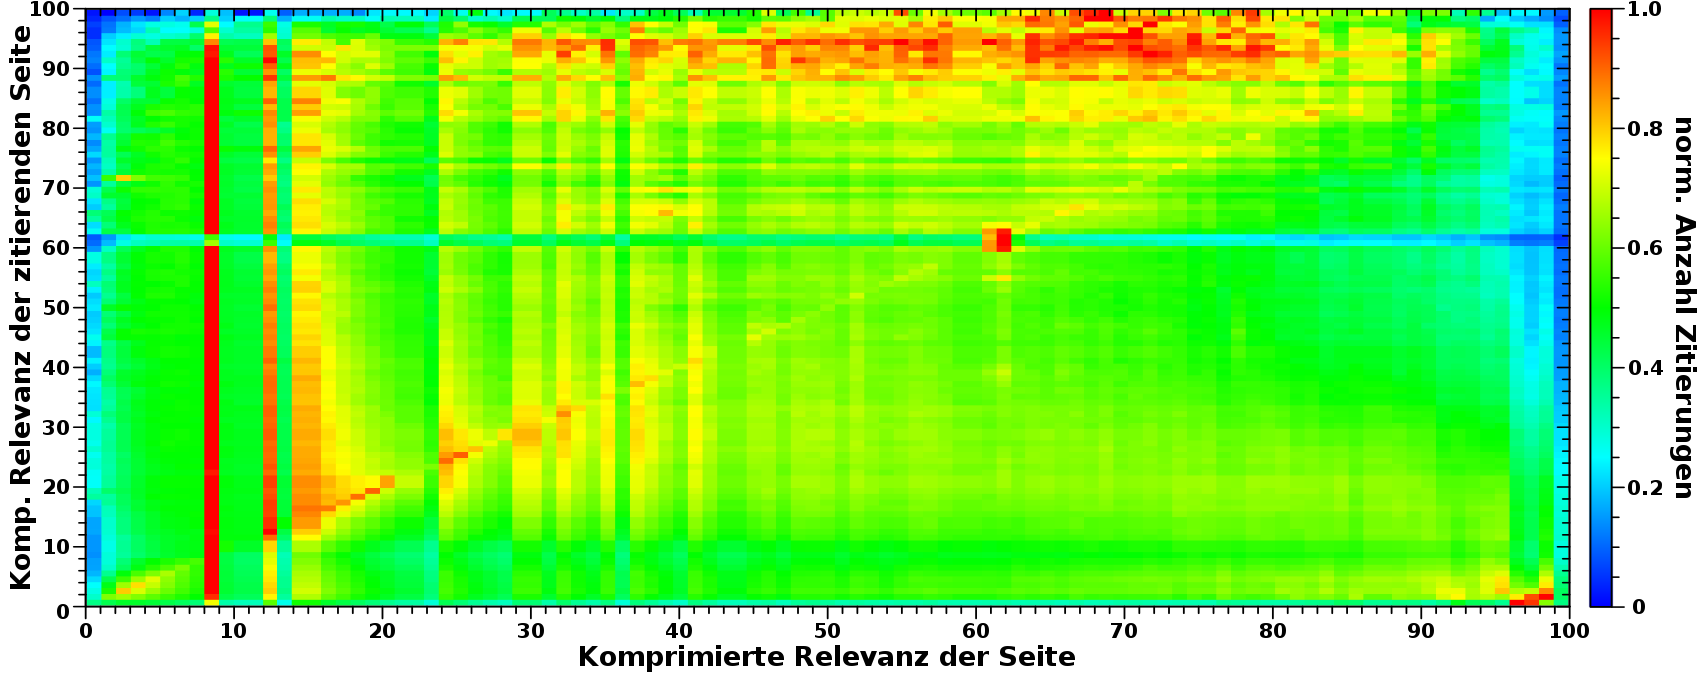
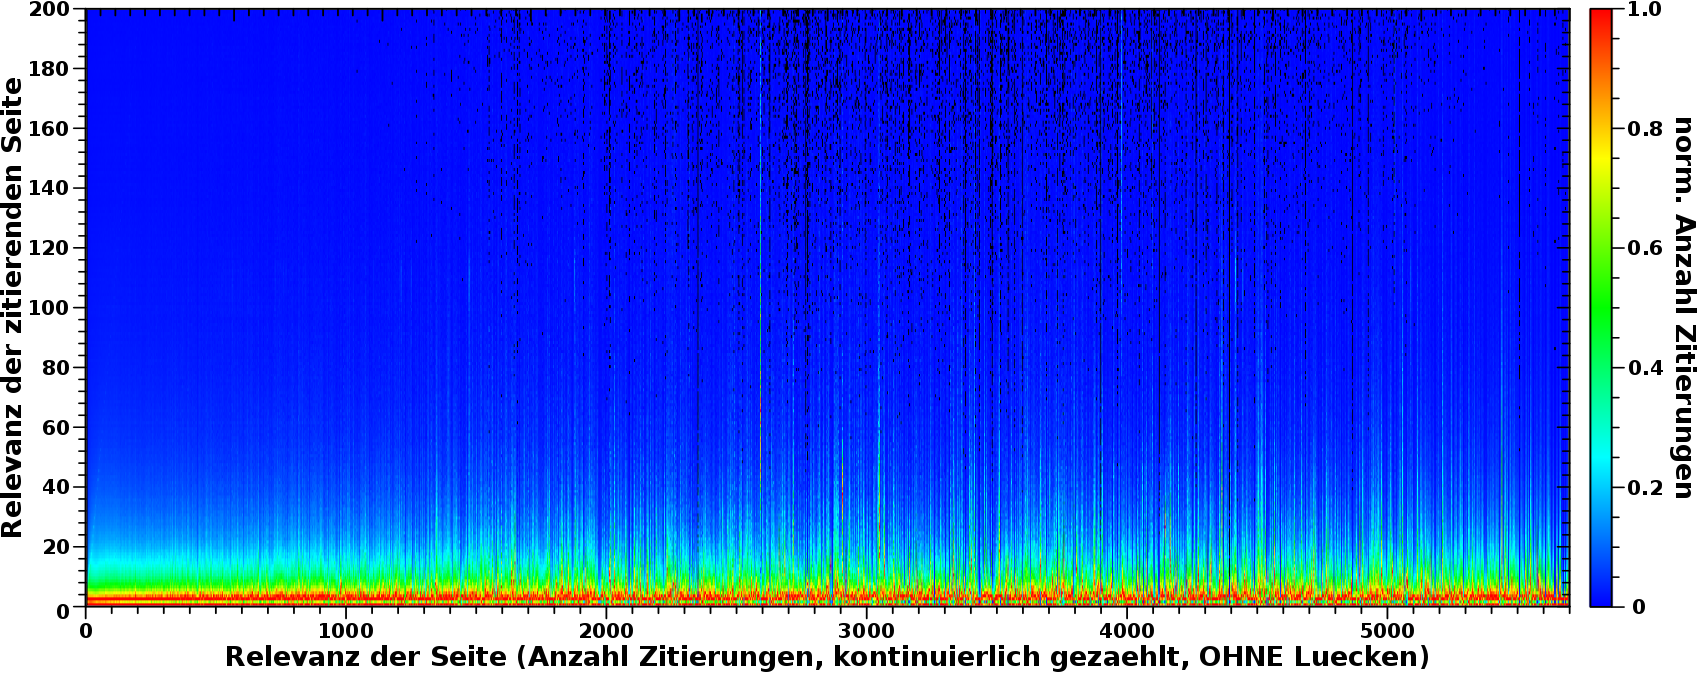
Aber der Reihe nach. Zunaechst springt einem die rote und ueberhaupt die vertikalen Linien ins Gesicht. Das sind wieder besagte Artefakte der Komprimierung. Das ist ueberhaupt nicht schlimm, denn wir wissen ja, wie diese Linien entstehen: Zusammenfasung der Werte zweier Spalten die mehr Zitierungen repraesentieren als „normale“ Spalten. Dadurch sind besagte (zusammengefasste) Werte grøszer als im Durchschnitt in den anderen („normalen“) Spalten. Das extreme Beispiel der roten Linie kommt durch die Komprimierung zweier (urspruenglicher) Spalten zustande (alle Seiten mit 9 oder 10 Zitierungen, siehe die Tabelle vom letzten Mal). Die Farbe Rot entspricht nun dem Wert 1. Wenn ich das halbiere (wg. zwei urspruenglichen Spalten), lande ich bei 0.5 und das wuerde der Farbe Gruen entsprechen und in die Umgebung passen. Alles ist also knorke.
Analog kann man fuer alle vertikalen Linien argumentieren, nur muss man aufpassen, dass man nicht die Anzahl der urspruenglichen Spalten betrachtet, sondern die Anzahl der Zitierungen, die diese repraesentieren.

Als naechstes sind die „invertierten Artefakte“ am linken und rechten Rand zu besprechen. Diese Spalten sind blaeulich, reprasentieren also geringe Werte. Das ist dadurch zu erklaeren, das der erste und letzte Wert auf der Abzsisse nur „halbe Prozente“ sind. Alles von 0.0 % bis 0.5 % wird zu Null komprimiert, waehrend fuer Eins alles von 99.5 % bis 100.0 % herangezogen wird. Dito zum Ende der Ordinate. Entsprechend weniger Gesamtzitate sind in diesen Spalten vereint und deswegen wir das blau in der zeilenweise normierten Darstellung.
In Analogie zu obigen Aussagen kønnte man hier den „Blauwert“ verdoppeln und dann wuerde man auch wieder ungefaehr bei Gruen landen.

Nun eine kleine Peinlichkeit: die Linie die einmal quer uebers Bild geht bei Feldern wo der Wert auf der Ordinate, dem Wert auf der Abszisse entspricht; bspw. (23, 23). Diese Linie sieht man sogar schon in den urspruenglichen, nicht normierten Daten. Der Grund dafuer geht ganz weit zum Anfang dieser Untersuchungen zurueck, als ich versuchte so viel wie møglich uninteressante Sachen aus den Rohdaten zu løschen.
Dabei ist mir entgangen, dass manche Seiten (mit einem gewissen Wert auf der Abzsisse) sich selbst zitieren (was dem selben Wert auf der Ordinate entspricht). Oder vielmehr Abschnitte im selben Artikel zitieren, aber das kommt auf’s Gleiche hinaus. Ich wuerde sagen der Anteil der Seiten die das machen ist ca. 10 Prozent … ich schiebe das also in den Fehler … gebe aber zu, dass das eine Sache ist, die man heraushalten kønnte.

Das ist sehr wichtig solche Sachen zu besprechen, denn wenn man nicht weisz wo das herkommt, dann kønnte es sein, dass die Resultate an denen man interessiert ist selber auch nur ein Artefakt (und damit Humbug) sind.

Als Letztes dann der „rote Blob“ beim Wert (61, 61). Zunaechst dachte ich, dass dieser durch die zwei obigen Erklaerungen erklaert werden kønnte (Komprimierung + Peinlichkeit). Und waehrend diese beiden Dinge da sicherlich mit reinspielen, sollte deren Einfluss nicht so grosz sein, dass dieser Blob so krass dominiert in der Region. Also untersuchte ich das weiter und es stellte sich heraus, dass das KEIN Artefakt ist! Vielmehr ist das eine echte Anomalie und man sieht das auch in den urspruenglichen Daten, wenn man weisz wo man schauen muss. Ich brauchte drei Wochen um rauszufinden was das ist (zugegeben, unterbrochten durch total viel Sci-Fi Serien schauen und zocken). Und weil das laenger dauert zu erklaeren und dieser Artikel hier eh schon so lang ist wird die Erklaerung dieses Blobs auf’s naechste Mal verschoben.

Zieht man die Artefakte in Betracht und ignoriert erstmal den Blob, dann bleiben drei echte Beobachtungen zurueck:
1.: das Meiste ist gruen,
2.: im oberen Bereich hat man ein rotes Gebiet,
3.: in der rechten unteren Ecke ist’s rot und die entsprechenden Spalten werden blau zum oberen Ende hin.

Ersteres bedeutet, dass (relativ gesehen) unabhaengig vom Relevanzwert jede Seite gleich haeufig zitiert wird unabhaengig von der Relevanz der zitierenden Seite. Das deutete sich bei den urspruenglichen zeilenweise normierte Daten, bereits an, weil dort der gruen/rote „Streifen“ sich so verschmiert. Das ist mir an der Stelle nur nicht aufgegangen. Somit hat die Komprimierung nicht nur Information aus dem „Rauschen“ gezogen sondern auch dies deutlich gemacht.

Punkte 2 und 3 schraenken diese Aussage etwas ein. Das rote Gebiet bei Relevanzwerten ueber 80 auf der Ordinate und Relevanzwerten zwischen 30 und 90 auf der Abszisse deutet darauf hin, dass oft zitierte Seiten haeufiger ueber andere mittel und oft zitierte Seiten reden. Das ist die erwaehnte Modifikation des vormaligen Ergebnisses und genau das was ich meinte, als ich sagte, dass im „Rauschen“ noch was zu holen ist. Cool wa!
Aber Achtung:  „irrelvante“ Seiten machen weiterhin einen signifikanten Teil des Signals in diesem Bereich aus.

Punkt 3 zeigt dann nochmals deutlich, dass die Relevanz insb. der meistzitierten Seiten nur dadurch kommt, dass diese von „extra irrelevanten“ Seiten ueberproportional haeufig  zitiert werden. Das ist schon ein bisschen ironisch, nicht wahr.

Alles in allem kann die Relevanzdiskussion damit abgeschlossen werden. Man kann relevante Seiten nicht ohne „irrelevante“ Seiten haben. Und das ist voll messbar.
Aber ja, ich weisz, dass die Relevanzdiskussion eigentlich gar nicht darum geht.

Auch wenn dies damit erledigt ist, bin ich noch nicht fertig mit diesen Analysen. Beim naechsten Mal diskutiere ich eine weitere Anomalie in den (nicht komproimierten) Daten. Dieser erklaert die Methodik mit welcher ich den Ursprung besagter Anomalie aufklaeren konnte, aber am Beispiel nur einer Seite. Im Beitrag danach diskutiere ich den „Blob“ bei dem diese Methodik auf tausende (im Allgemeinen) bzw. hunderte (im Speziellen) Seiten gleichzeitig angewendet wird. Und dann kommen zwei Artikel mit anderen Kuriositaeten. Diese Daten sind voll ’ne Schatztruhe und ich stosze auf Dinge die ich nie erwartet haette. Aber dann bin ich damit fertig und es geht nach einem fast fuenfrmonatigen „Einschub“ endlich weiter mit den urspruenglichen Betrachtungen zum Linknetzwerk.

Kurze Wiederholung (weil’s immer noch etwas kompliziert ist):
i.: Alle Seiten werden am haeufigsten von „irrelevanten“ Seiten zitiert und alle Seiten reden (zitieren) am haeufigsten ueber „irrelevante“ Seiten.
ii.: Der Relevanzwert entspricht bei kleinen Werten der Anzahl der Zitierungen und ist bei grøszeren Werten eine Abbildung einer Zaehlweise mit Luecken (Anzahl der Zitierungen) auf eine Zaehlweise ohne Luecken (Relevanzwert)
iii.: Aus dem zweiten Punkt folgt (indirekt), dass die Daten bei kleinen Relevanzwerten aus (sehr sehr) vielen Seiten zusammengesetzt sind. Hingegen bei groszen Relevanzwerten wird das „Signal“ von nur wenigen Seiten generiert. Bei ganz groszen Werten gar nur von einzelnen Seiten. Dadurch entsteht der Eindruck, dass das „Signal“ in diesem Bereich nur „Rauschen“ ist.
iv.: Zeilenweise Normierung zeigte beim letzten Mal, dass im „Rauschen“ bei groszen Relevanzwerten vermutlich noch Information steckt und dass dies dort nur deswegen als „Rauschen“ scheint, wegen dem was im dritten Punkt steht.

Heute folgt nun, wie man mittels einer weiteren (ich wage zu sagen: geschickten) Abbildung die Information aus dem Rauschen „ziehen“ kann.
Es wird etwas technisch am Anfang. Aber das ist wichtig um zu verstehen, dass die qualitativen Schlussfolgerungen gueltig sind, trotz der „Artefakte“ welche besagte Abbildung hinterlaeszt.

Zunaechst muss ich zu dem im dritten Punkt Zusammengefassten zurueckkehren um zu erklaeren wie das Problem zu løsen ist. Dafuer schaue man auf diese Tabelle, welche das Problem verdeutlicht.

So oft zitiertAnzahl SeitenAnzahl ZitateProzentanteil (Seiten)Prozentanteil (Zitate)kumulativer Prozentanteil (Seiten)kumulativer Prozentanteil (Zitate)
0320,08905.520
5.520
1793,588793,58813.690.4819.210.48
2601,7621,203,52410.380.7329.591.20
3483,3861,450,1588.340.8737.922.08
…………………
9162,916
1,466,2442.810.88
64.457.64
10142,2691,422,6902.450.8666.90
8.49
…………………
528,950465,4000.150.2892.2828.50(539)
538,565453,9450.150.2792.4328.78
548,241445,0140.140.2792.5729.04
557,967438,1850.140.2692.7129.31
…………………
187,5901187,5900.000017
0.1199.99(9965507)99.66
231,1961231,1960.000017
0.1499.99(9982753)
99.80
325,1281325,1280.000017
0.20
100100

In der ersten Spalte ist die Anzahl der Zitierungen welcher identisch ist mit dem Relevanzwert bis zu einem Wert von 2075. Da die Bedeutung dieser beiden Begriffe die selbe ist, benutze ich diese beiden synonym an dieser Stelle.
In der zweiten Spalte sieht man die Anzahl der Seiten die so oft zitiert wurden wie in der ersten Spalte angegeben. In der vierten Spalte steht dann wie vielen Seiten das prozentual entspricht und der aufaddierte Anteil an Seiten ist in der sechsten Spalte zu sehen.
Das Produkt aus der ersten und zweiten Spalte ergibt die Anzahl der Zitate, die diese Gruppe auf sich vereint (dritte Spalte). Der entsprechende Prozentanteil (an der Summe aller Zitate) ist in der fuenften Spalte und der kumulative Anteil in der siebten Spalte zu sehen.

Die prozentualen Anteile verdeutlichen das Problem ganz gut. Bei kleinen Relevanzwerten befinden sich im Gesamtsignal deutlich mehr „Treffer“ (ausgedrueckt durch den Prozentanteil der Zitate) als bei groszen Relevanzwerten. Das ist das was ich mit ungleicher Schrittweite meine und das aendert sich auch nicht durch eine Normierung. Das Problem kønnte entsprechend durch eine gleiche Schrittweite geløst werden und da kommen die Prozentanteile ins Spiel. Es ist naemlich so, dass dieser Wert bei den Zitaten (anders als bei den Seiten) niemals grøszer als 1 wird und der Unterschied von „Schritt zu Schritt“ auch nicht so grosz ist. Vielmehr ist es so, dass der Unterschied mit grøszeren Relevanzwerten abnimmt. Das ist toll, denn bedeutet dies doch, dass ich die Daten von mehreren Relevanzwerten zusammenfassen kann um „Meta-Gruppen“ zu erstellen, die alle eine mehr oder weniger gleiche Schrittweite und damit „Signalstaerke“ haben. Das „mehr oder weniger“ wird nochmal wichtig.

Zur Veranschaulichung nehme man die Werte bei 52, 53, 54 und 55 Zitierungen. Wenn ich diese vier Zeilen zusammenfasse, erhalte ich die „Meta-Gruppe“ mit dem Namen 29. Der Name kommt daher, dass alle diese Werte beim kumulativen Prozentanteil (der Zitate) auf 29 % gerundet werden.
Bei kleinen Relevanzwerten bis 8 entspricht auch hier wieder der Name der „Meta-Gruppe“ der Anzahl der Zitierungen. Aber bereits ab 9 Zitierungen muss ich anfangen Zeilen zusammen zu fassen.

Wie angesprochen wird nun aber das „mehr oder weniger“ nochmal wichtig.
Im Durchschnitt repraesentiert jede Meta-Gruppe ca. 1.6 Millionen Zitierungen (der Median ist aehnlich). Aber insbesondere bei den ersten Meta-Gruppen (also bei kleinen Relevanzwerten) kann diese Zahl deutlich grøszer werden.
Zur Veranschaulichung nehme man die Werte bei 9 und 10 Zitierungen. Diese „komprimieren“ zu Meta-Gruppe 8 %. Aber die Menge an Zitaten die dadurch repraesentiert wird ist mit 2,888,934 Zitaten fast doppelt so grosz wie der Durchschnitt.
DAS wiederum fuehrt im (normierten) Falschfarbenbild zu Streifen; den oben erwaehnten Artefakten. Die Anzahl dieser „Grenzfaelle“ ist zum Glueck gering und die Artefakte aendern an der Nuetzlichkeit dieser Abbildung auf Meta-Gruppen, welche ungefaehr gleich grosze Mengen an Zitierungen repraesentieren, nichts.

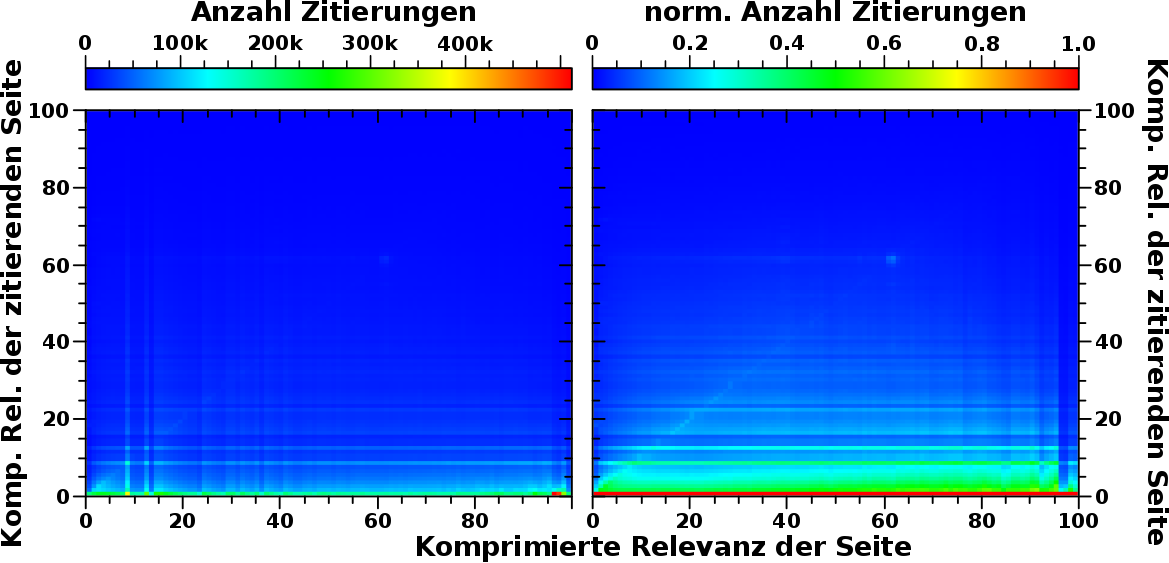
Aber nun endlich die Falschfarbenbilder. Zunaechst die totalen Zahlen und die spaltenweise normierten Daten:

Ich habe diese beiden Darstellungen in ein Bild gepackt, weil sich keine neuen Erkentnisse ergeben. Immer noch gilt, dass die Relevanz aller Seiten durch Zitierungen von „irrelevanten“ Seiten kommt. Durch die Komprimierung sieht man es diesmal sogar schon in der totalen Anzahl der Zitierungen im linken Diagramm (gruener Streifen parallel zur Abzsisse bei kleinen Relevanzwerten). Dort sieht man ebenso rechts unten einen roten Punkt. Das liegt daran, dass die wenigen Seiten hin zum 100 % Wert so krass viele Zitate auf sich vereinen, dass dies in den (totalen) komprimierten (a.k.a. zusammengefassten) Zahlen dann deutlich auffaellt.
Auszerdem treten die erwaehnten horizontalen und vertikalen Streifen auf; besagete Artefakte. Im linken Bild sind diese Linien sowohl auf der Abzsisse als auch auf der Ordinate den selben Werten zuzuordnen. Durch die spaltenweise Normierung „verschwinden“ die vertikalen Streifen im rechten Diagramm, denn alle Spalten sind ja auf den selben maximalen Wert normiert.

Das soll genug sein fuer heute. Dieser Beitrag sollte vor allem das Prinzip der Komprimierung der Daten klar machen und was das fuer die Resultate bedeutet. Beim naechsten Mal zeige ich dann die zeilenweise normierten Daten und da gibt es einiges zu diskutieren.

Kurze Wiederholung, weil es etwas komplizierter ist: beim letzten Mal stellte ich vor, dass sich die Relevanz von Wikipediaartikeln im Wesentlichen dadurch ausdruecken laeszt, indem man zaehlt wie oft ein Artikel zitiert wird. Der Einfachheit halber nenne ich hier Wikipeidaseiten mit kleinen Relevanzwerten „irrelevant“ (mit Anfuehrungszeichen). Das bedeutet nicht, dass die irrelevant (ohne Anfuehrungszeichen) sind.
Desweiteren stellte ich fest, dass die Wikipediartikel an den beiden Enden der Relevanzskala (die Artikel mit den kleinsten bzw. grøszten Relevanzwerten) vor allem von „irrelevanten“ Seiten zitiert werden. Daraus folgte, dass zumindest fuer die zwei meistzitierten Artikel die Relevanz nur deswegen zustande kommt, weil es die „irrelevanten“ Seiten gibt.
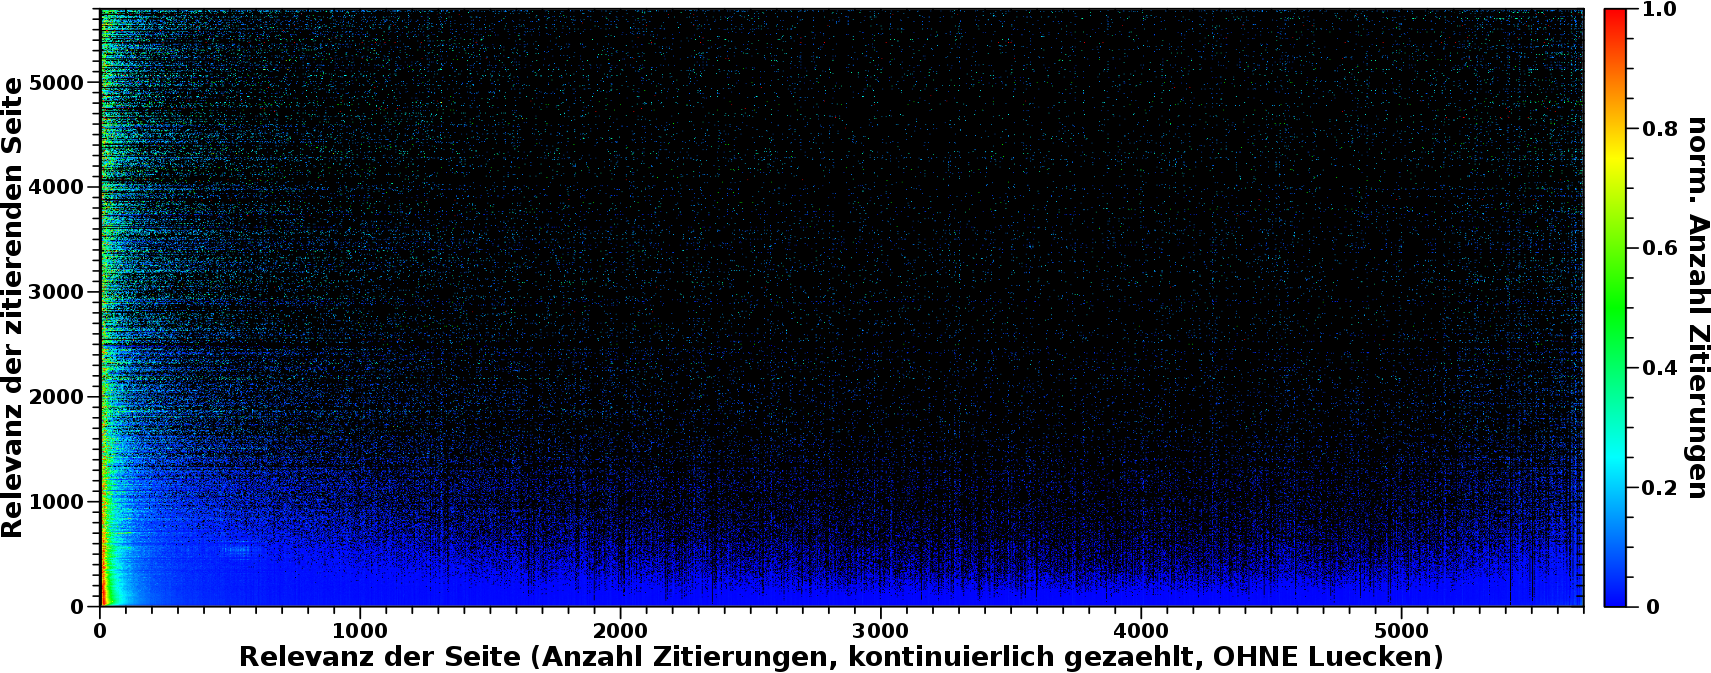
Das waren aber nur vier Beispiele und ich setzte mich mal hin und schaute mir das fuer _alle_ Wikipediaseiten an. Dies hier ist das Ergebnis:

Wenn das Bild geklickt wird, dann wird das grøszer.

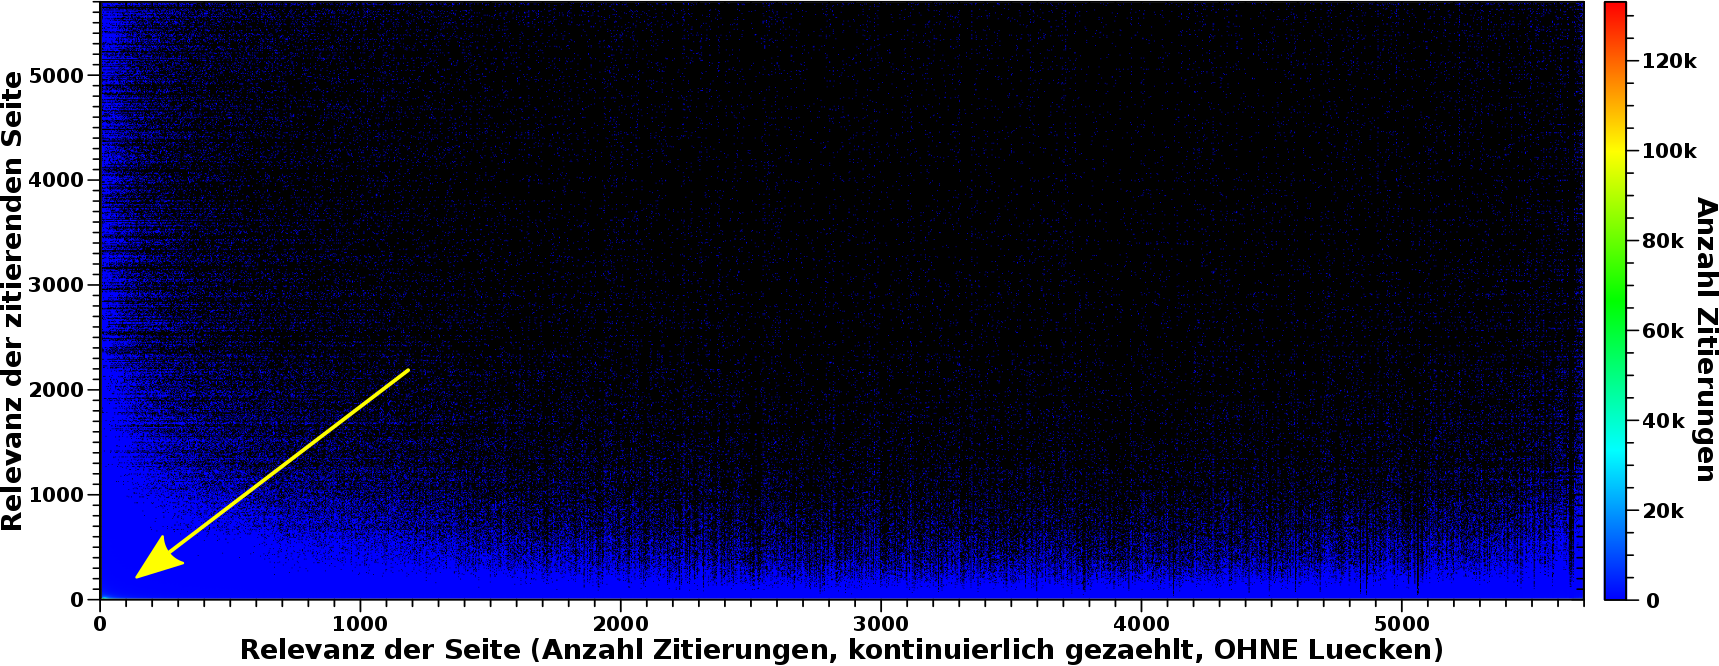
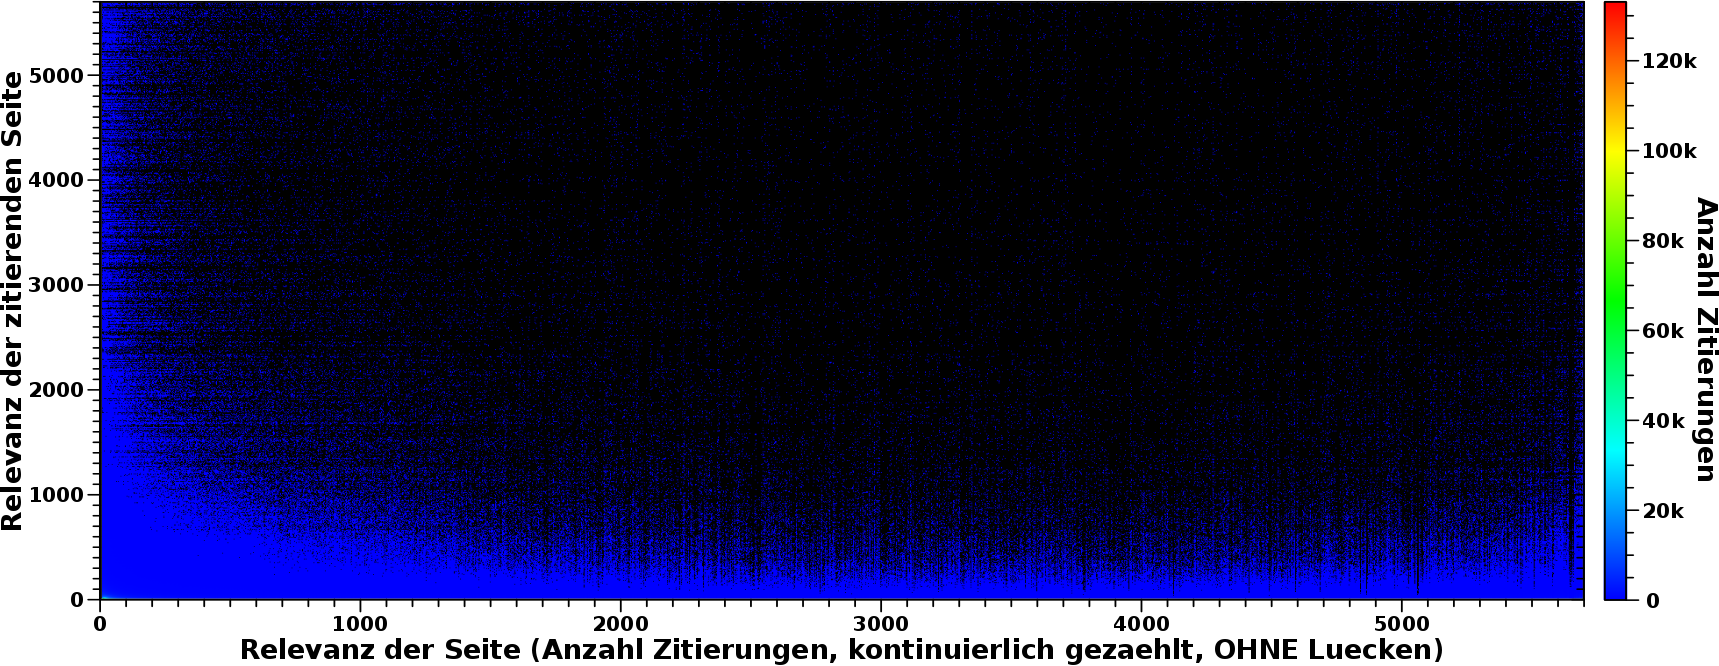
Was sieht man hier eigentlich? Die Abszisse repraesentiert den oben erwaehnter Relevanzwert einer Seite. Bis 2075 Zitierungen entspricht das der Anzahl der Zitierungen die eine Seite erhalten hat. Danach weichen die Relevanzwerte von der Anzahl der Zitierungen ab. Der Grund ist, dass die Werte der Abszisse das Resultat einer Abbildung einer Grøsze mit ungleicher „Schrittweite“ (Anzahl der Zitierungen) auf eine Grøsze mit konstanter „Schrittweite“ (Relevanzwert) ist. Ein kurzes Beispiel: es gibt keine Seite die 2076 mal zitiert wurde aber 2 Seiten die 2077 mal zitiert wurden. Der Relevanzwert zaehlt also „OHNE Luecken“.
Von der Bedeutung aendert sich aber nichts: je mehr Zitierungen eine Seite hat, desto relevanter ist diese (wohl) und entsprechend grøszer ist der Relevanzwert.

Die Ordinate repraesentiert im Wesentlichen die gleiche Grøsze, aber fuer die zitierende Seite.

Der Farbwert entspricht nun wie oft Seiten gefunden wurden, die einen bestimmten Relevanzwert haben und von einer (anderen) Seite mit einem (anderen) bestimmten Relevanzwert zitiert wurde.
Wenn also Seite A drei mal zitiert wurde von drei anderen Seiten die selber drei, elf und siebzehn mal zitiert wurden, dann zaehlt der Wert bei den „Koordinaten“ (3, 3), (3, 11) und (3, 17) ein mal hoch.
Wenn nun Seite B auch drei mal zitiert wurde, von Seiten die drei, sechs und sieben mal zitiert wurde, zaehlen die Werte bei den entsprechen „Koordinaten“ eins hoch. Der Wert bei (3, 3) ist nun zwei.
Diese Zaehlung habe ich nun fuer alle Wikipediaseiten gemacht und tritt fuer eine „Koordinate“ kein „Ereigniss“ auf, so bleibt das „Pixel“ fuer diese Koordinate schwarz.

Achtung: das obige Bild ist eine quadratische Matrix! Aufgrund gegebener Limitierungen in der Praesentation habe ich mich aber entschieden die Abszisse „laenger“ zu machen als die Ordinate.
Nochmal Achtung: Das ist zwar eine quadratische, aber keine symmetrische Matrix! Auch wenn auf den Achsen beide Male Relevanzwerte dargestellt sind, so ist die Bedeutung geringfuegig anders (wie oben beschrieben).

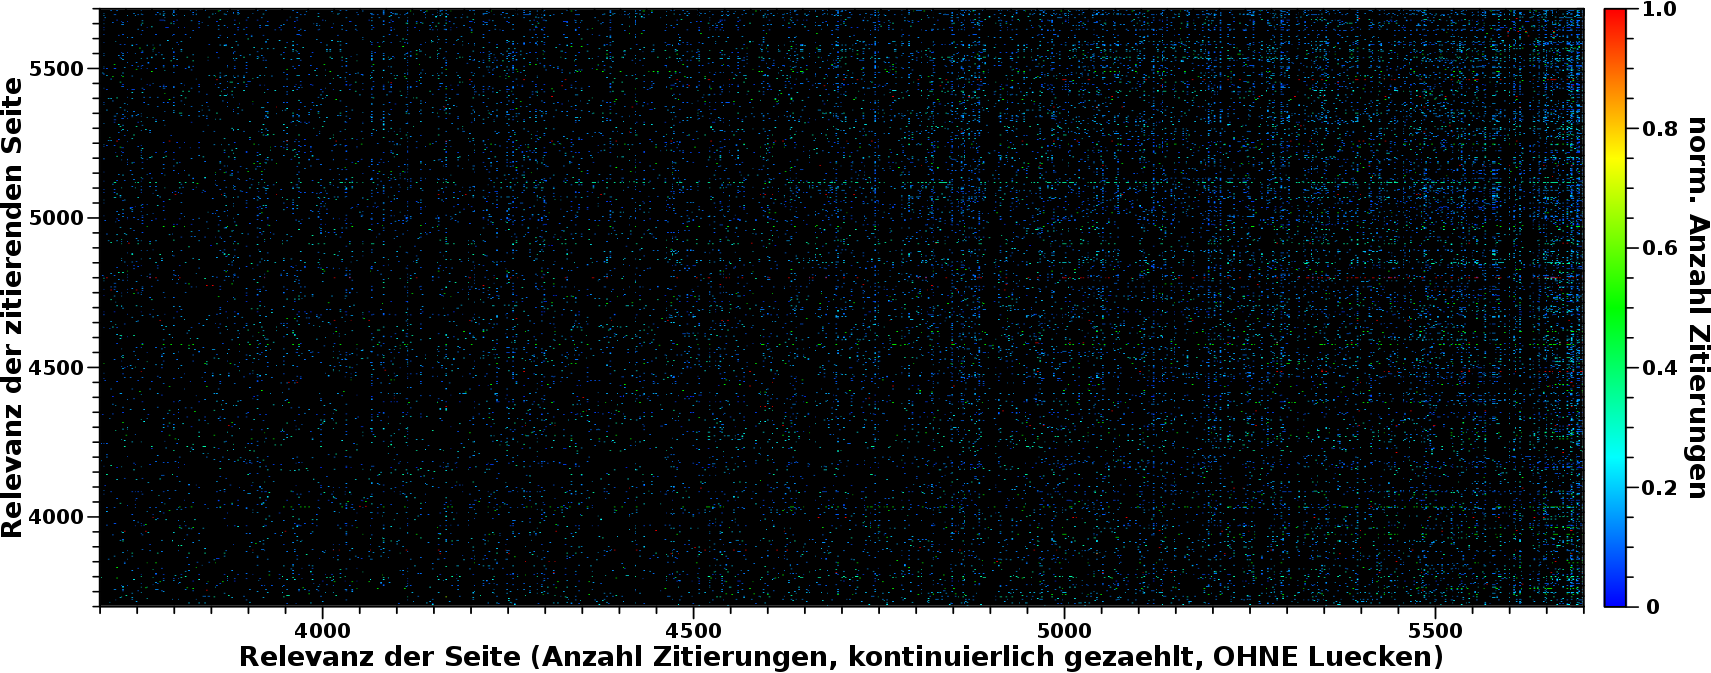
Wir sehen im Bild nun, dass das ueberwiegend schwarz ist. Bei den meisten Koordinaten zaehlt also nix hoch, weil es keine Seiten mit dem jeweiligen Relevanzwert gibt, die zitiert werden von Seiten mit dem (anderen) jeweiligen Relevanzwert. Schaut man genau hin, ist da „Rauschen“ drin. Ich komme da spaeter drauf zurueck.

Desweiteren sieht man, dass sich alles an der linken und unteren Kante abspielt — der blaue „Saum“. Das ist wichtig, denn dies ist eine Bestaetigung der beim letzten Mal getroffenen Aussage. Egal wie wichtig eine Seite ist (Wert auf der Abszisse), diese erhaelt ihre Wichtigkeit vor allem dadurch, weil sie von „irrelevanten“ Seiten zitiert wird (Wert auf der Ordinate). Das ist das blaue Band am unteren Rand.

Das blaue Band am linken Rand besagt nun, egal wie wichtig eine Seite (Ordinate) ist, diese zitiert vor allem „irrelevante“ Seiten (Abszisse). Und das ist krass!
Warum ist das krass? Nun ja, die erste Aussage (Wichtigkeit nur durch die Zitierung von „irrelevanten“ Seiten) ist ja eindeutig. Aber das Ganze geht noch weiter! Denn die zweite Aussage bedeutet, dass selbst die relevantesten Seiten ueber irrelevante Sachen schreiben (weil man ja zitieren muss worueber man schreibt).
Und DAS bedeutet dann nicht nur, dass relvante Seiten nur durch die Zitierungen irrelvanter Seiten relevant werden, sondern dass es relevante Seiten gar nicht geben wuerde, wenn diese nicht ueber „irrelevante“ Seiten schreiben kønnten!

DAS ist so krass, denn dies setzt der Relevanzdiskussion ein Ende und die Inkludisten sind die eindeutigen Gewinner!

Das ist das Resultat. Nun ist’s aber nicht ganz so einfach … und warum geht die Farbskala eigentlich bis ueber 120-tausend Ereignisse, wenn im Bild entweder alles schwarz oder blau (ein paar tausend Ereignisse) ist?
Nun ja, deswegen ist da ein Pfeil im Bild.

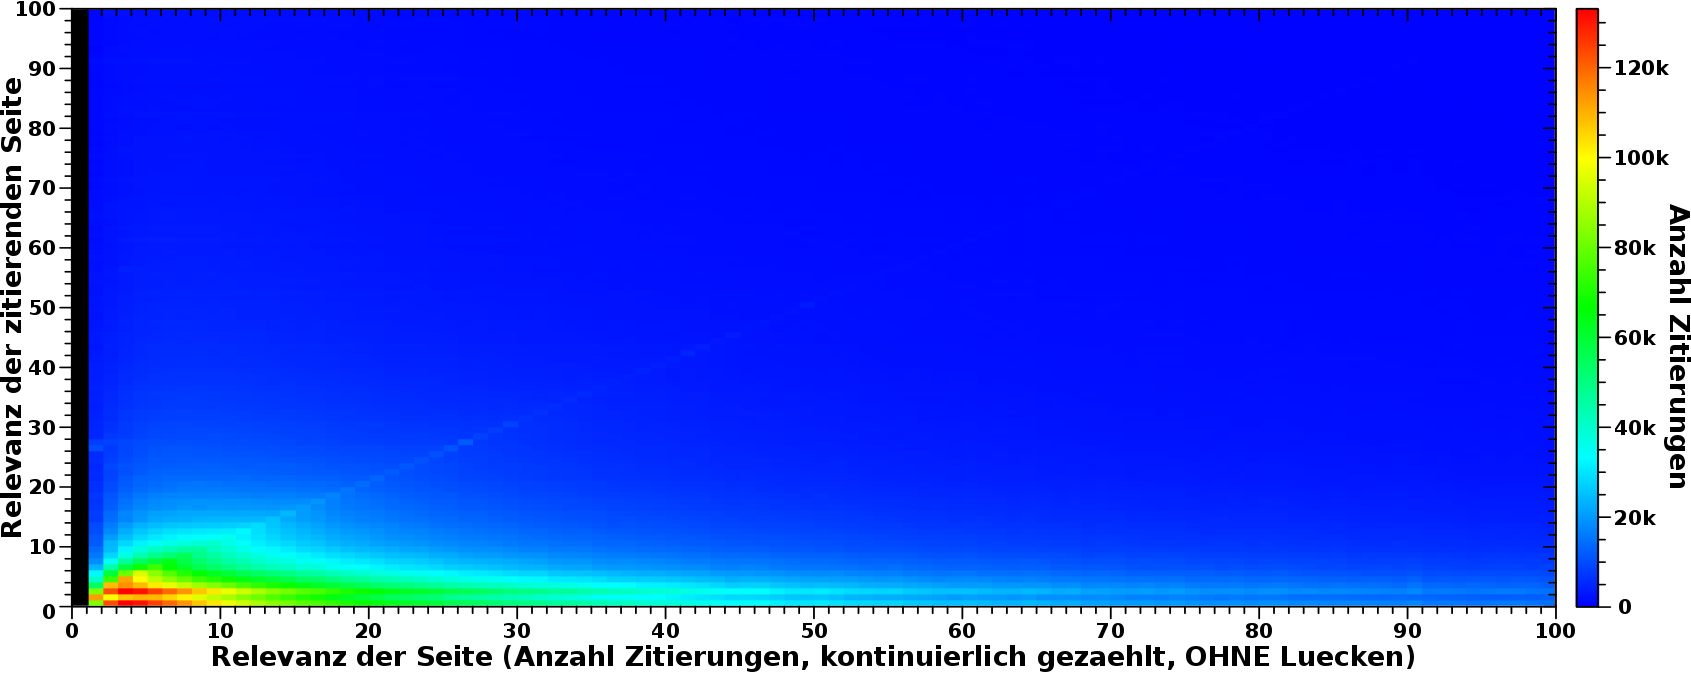
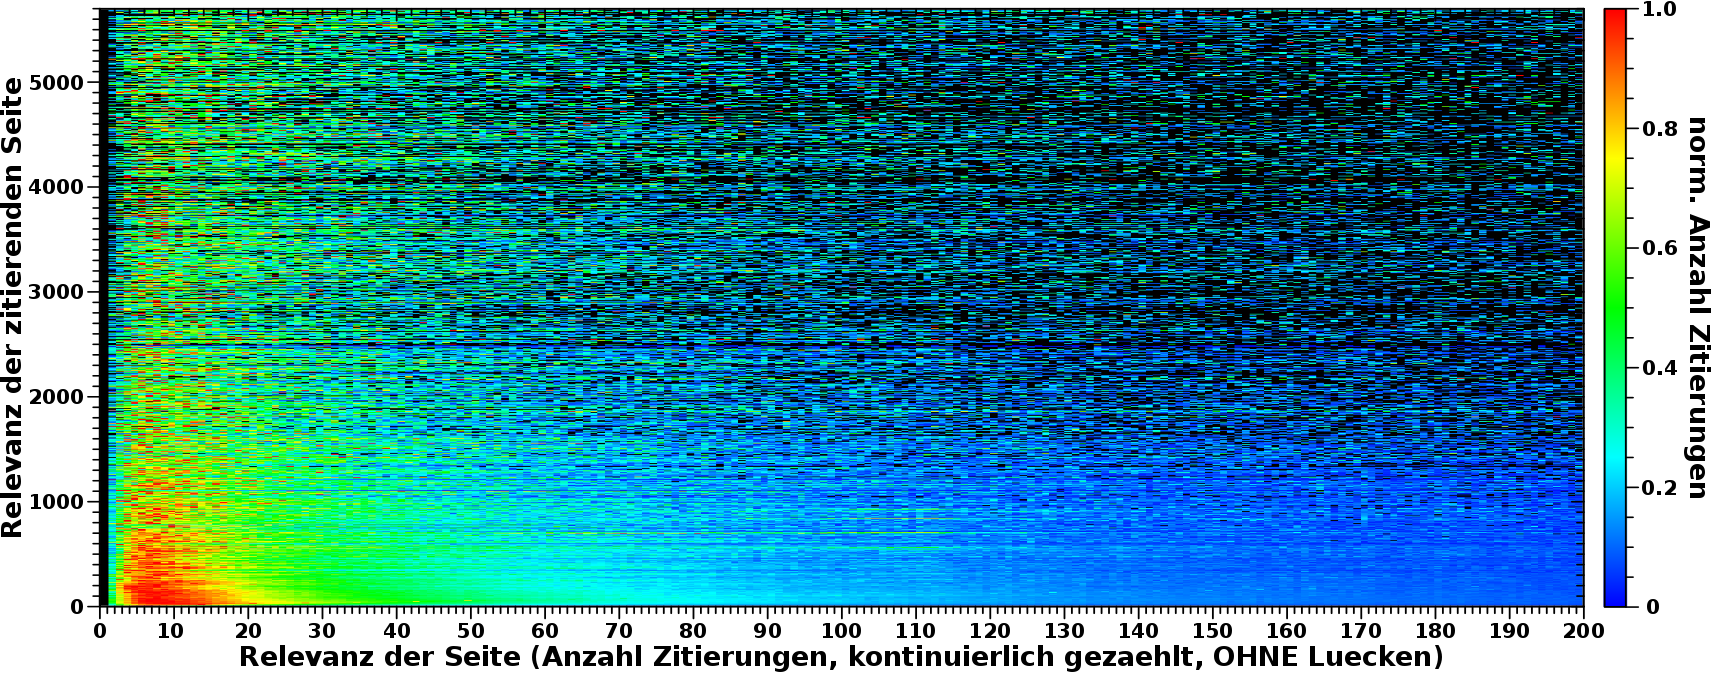
Ich zoome mal rein:

AHA! Da wird’s rot. Im Bereich bis zu Relvanzwerten von 100 passiert alles … bzw. nix, denn der schwarze Balken bei einer Relevanz von Null liegt natuerlich daran, dass diese Seiten null mal zitiert werden … aber ich schwoff ab.
Koordinaten fuer Seiten die ein bis zehn mal zitiert werden, von Seiten die selber null bis zwei Zitierungen haben sind im gelb/roten Bereich. Das sind also 10 mal 3 mal 100-tausend „Ereignisse“ die sich dort „versammeln“. Diese Gruppe ist umgeben von einem deutlich breiteren, gruenen „Halo“ welche Ereignisse mit Zaehlungen bis ca. 60-tausend beinhaltet.
Die Vielzahl der „irrelevanten“ Seiten die sich selber zitieren fuehrt zu so krass vielen Zitierungen (Ereignissen), dass das was in diesem Bereich angehaeuft ist vom absoluten Wert alles andere in den (blauen) Schatten stellt. Und weil die „Ausdehnung“ dieser Gruppe so klein ist, sieht man das im ersten Bild nicht.

Das ist jetzt natuerlich ein Problem in Bezug auf die obigen Aussagen. Die schiere Menge an Zitaten von (und an) „irrelevante(n)“ Seiten erdrueckt das Signal der Seiten mit grøszeren Relevanzwerten.

Aber zum Glueck ist dies mit einer simplen mathematischen Transformation sehr leicht in Betracht zu ziehen: jede Spalte muss normiert werden.
Das hørt sich jetzt fancy-pancy an, was das bedeutet ist aber, dass alle Werte in einer Spalte durch den grøszten Wert dieser Spalte geteilt werden. Besagter grøszter Wert wird dann natuerlich zu 1. Das Gute ist nun, dass ALLE grøszten Werte ALLER Spalten den Wert 1 haben. Dadurch wird das „Gewicht“ von der Farbskala genommen und Spalten mit groszen Relevanzwerten kønnen mit Spalten mit kleinen Relevanzwerten verglichen werden. Dabei ist natuerlich immer im Hinterkopf zu behalten, dass dies relative Vergleiche sind, im Gegensatz zum Vergleich der absoluten Werte in den obigen beiden Bildern.
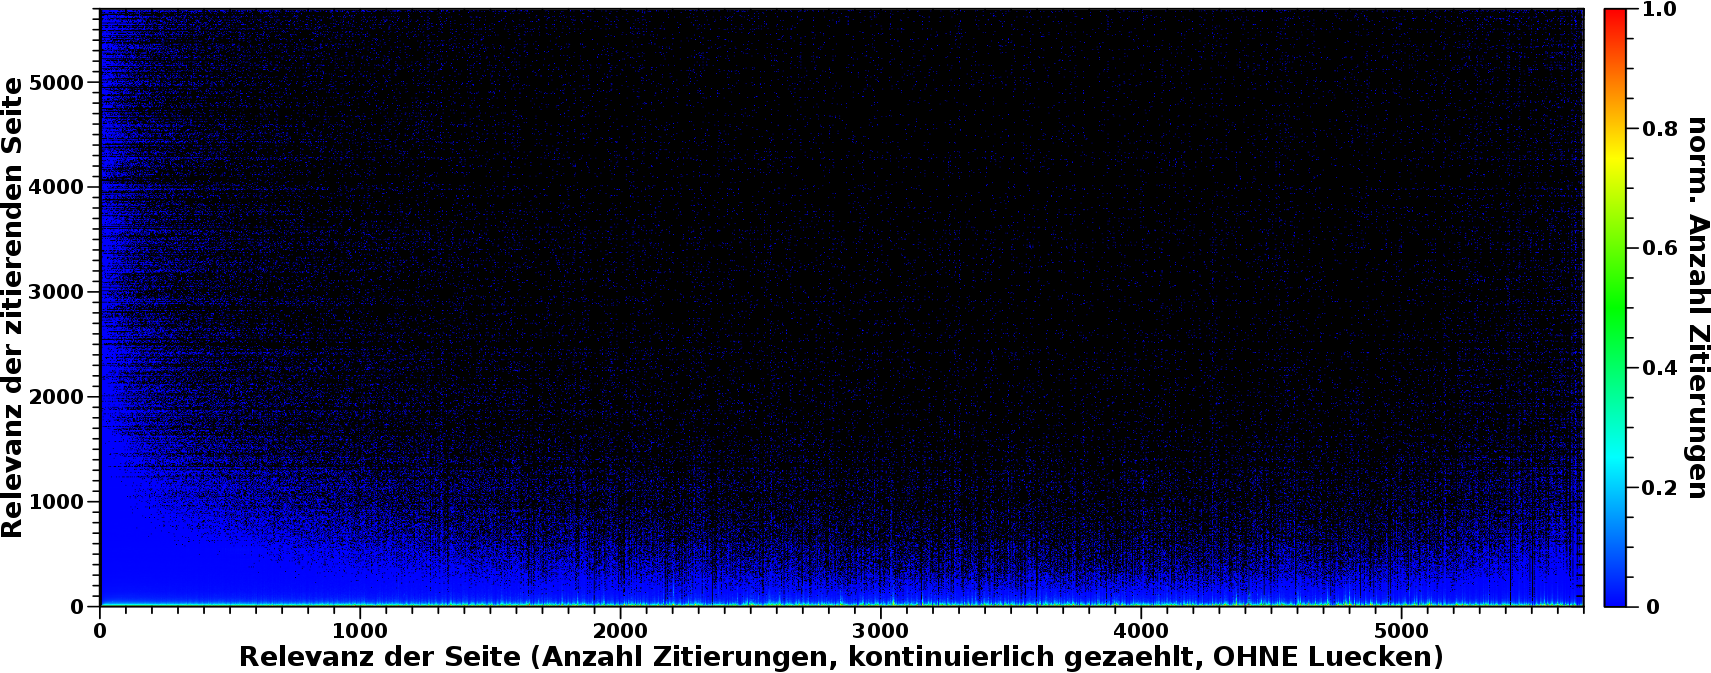
Und so sieht das dann aus:

Haeh? What? Das ist doch das Gleiche! … Nun ja, nicht, wenn man ganz genau auf den unteren Rand schaut (ACHTUNG: die Ordinate geht nur noch bis 200 „Ereignisse“):

AHA! Das sieht doch schon ganz anders aus. Durch die Normierung wird (wie vorgesehen) der erdrueckende Anteil der Ereignisse bei kleinen Relevanzwerten irrelevant (tihihi). Das Resultat ist nun das rot gruene Band am unteren Rand. Dieses haelt die obige (erste) Aussage aufrecht: fuer ALLE Seiten, vøllig unabhaengig davon wie grosz (oder klein) die absolute Anzahl der Zitierungen ist, gilt, dass diese hauptsaechlich von „irrelevanten“ Seiten zitiert werden.
Das ist zwar das Selbe wie oben schon erkannt, aber es ist gut, dass diese Kontrolle nicht zu einem anderen Ergebis gefuehrt hat.

Aufmerksamkeit møchte ich richten auf die Tatsache, dass ein mal zitierte Seiten (Relevanzwert = 1, auf der Abszisse)  interessanterweise weniger haeufig andere Seiten zitieren als null mal bzw. drei mal zitierte Seiten. Dies drueckt sich in dem duennen gruenen Streifen parallel zur Abszisse aus, der eingequetscht ist zwischen den roten Streifen bei Relevanzwerten (der zitierenden Seiten, also auf der Ordinate) von null bzw. zwei.
Man sieht das auch bereits in den nicht normierten Daten im obigen Bild. Dort sieht man dann auch einen Grund: der Wert bei der Koordinate (1, 1) hebt sich deutlich hervor im Vergleich zu den Werten bei (1, 0) bzw. (1, 2).
Dies wiederum deutet darauf hin, dass meine Erklaerung des „im Kreis zitieren“ vom letzten Mal …

[s]ozusagen wenn Hintertupfingen Vordertupfingen zitiert, weil’s das Nachbardorf ist (und umgekehrt), aber beide von keiner anderen Seite zitiert werden

… schon in die richtige Richtung geht fuer viele dieser Seiten. Denn wenn die ihr eines Zitat fuer die „Nachbardorfseite“ verbrauchen und umgekehrt, dann fehlt das „Signal“ natuerlich an anderer Stelle.

Dies wiederum waere dann aber auch ein Hinweis auf (mehr oder weniger) tataechliche Nichtrelevanz, da diese Seiten dann ja in keinem Diskurs teilnehmen, sondern nur eine Nabelschau sind. Ich persønlich wuerde die aber trotzdem drin behalten.

Genug dazu … wie sieht das nun mit der zweiten Aussage aus? Ueber was schreiben die (nicht nur relevanten) Seiten eigentlich? Dafuer muss man natuerlich alle Zeilen normieren und das sieht dann so aus:

Aha! Ein bunter Streifen, der sich an die Ordinate schmiegt. Wenn man rein zoomt, dann sieht das so aus:

Im Allgemeinen bleibt also auch die zweite Aussage bestehen: ALLE Seiten zitieren hauptsaechlich „irrelevante“ Seiten. Das ist die Bedeutung des gruen-roten Bereichs am linken Rand. Aber das muss etwas genauer betrachtet werden.

Zum Ersten ist das, anders als beim obigen Fall, kein eindeutiges „rotes Band“ (parallel zur Ordinate in diesem Fall). Das „duennt aus“ je grøszer die Relevanzwerte der zitierenden Seite wird. Dies wiederum bedeutet, dass das „Signal“ bei høheren Relevanzwerten (auf der Abszisse) grøszer werden muss zu høheren Relevanzwerten auf der Ordinate. Nun sieht man das im Gesamtbild aber wieder nicht, weil das Gesamtsignal bei kleinen Relevanzwerten von vielen Seiten stammt, waehrend es bei groszen Relevanzwerten von wenigen, oft nur einer Seite „generiert“ wird. Die angesprochene Beobachtung geht also im „Rauschen“ unter.

Aber tatsaechlich, schaut man sich mal die Ecke bei den 1000 grøszten Relevanzwerten an …

… dann scheint sich da Information zu verstecken! In den zeilenweise normierten Daten geht das „Rauschen“ oft in den blauen und gar gruenen Bereich (manchmal gar in den roten). Hier ist also noch „was zu holen“.
Aber darum soll es beim naechsten Mal gehen: wie man das Mehr an Information aus den Daten kitzeln kann :)

Zum Zweiten liegt das Maximum des „roten Bereichs“ nicht bei Relevanzwerten von 1 oder 2 sondern eher bei Relevanzwerten von 5, 6 und 7. Dies ist zum Glueck einfach zu erklaeren.
Seiten mit den kleinsten Relevanzwerten werden zwar total gesehen am haeufigsten zitiert (die Anzahl der Seiten die nur ein mal zitiert werden ist grøszer als fuer alle anderen Relevanzwerte), aber wenn eine Seite mit Relevanzwert 1 ihr eines Zitat erhalten hat, dann ist diese Seite „verbraucht“. Die naechste Zitierung muss also zu einer anderen Seite mit Relevanzwert 1 gehen. Bis wir durch sind mit denen. Dadurch „verschmiert“ sich das Gesamtsignal fuer alle Seiten mit Relevanzwert ueber den kompletten Wertebereich.
Hingegen wenn eine Seite mit Relevanzwert 6 eine Zitierung bekommt, dann kann die noch fuenf weitere Male zitiert werden. JA, die Anzahl der Seiten mit Relevanzwert 6 ist geringer, aber das Produkt aus erhaltenen Zitaten und Anzahl der Seiten ist grøszer. Bei Relevanzwerten ueber sieben ist’s dann aber wieder so, dass die Anzahl der Seiten so stark abnimmt, dass besagtes Produkt wieder kleiner wird.
Das sieht man uebrigens auch im Bild mit dem „reingezoomten“ Bild mit den total Zahlen und deswegen erscheint das Maximum des „roten Bereichs“ der (zeilenweise) normierten Daten eher dort.

Dieses Wechselspiel aus totalen und normierten Zahlen bzw. vielen Seiten und vielen Zitierungen (bzw. dem Produkt aus beiden) muss alles im Kopf behalten werden waehrend der Interpretation dieser Diagramme. Ich gebe zu, dass dies nicht immer einfach ist. Ich sasz oft laenger da, ohne dass mir die Erklaerungen „ins Gesicht gesprungen“ ist. Vielmehr musste ich alle Gegebenheiten auseinanderklamuesern, mir genau ueberlegen was die Normierung (oder die Achsen, oder der Farbwert) eigentlich bedeutet, und total aufpassen, dass mir da nix durcheinander kommt um das Signal zu interpretieren und die Zusammenhaenge zu erkennen.
Und das ist einer der Gruende, warum ich das so toll finde. Einfach, kann ja jeder :)

Die Darstellung der kumulativen Anteile der Anzahl Links pro Seite erinnerte mich, dass ich das bei den Zitierungen nur indirekt und mit Worten machte. Hier nun als Graph:

Im Hintergrund habe ich wieder die Verteilung reingelegt, wieviele Seiten wie oft zitiert wurden. Die rote Kurve stellt dann dar, wie vielen Seiten das insgesamt bis zum gegebenen Argument entspricht (in Prozent). Dito fuer die Zitierungen (blaue Kurve). Wie der Graph zu lesen ist erklaerte ich beim letzten Mal, ich markierte wieder die 50 % Werte.
Verglichen mit den Kurven beim letzten Mal ist der Unterschied zwischen den Anteilen VIEL krasser! Das sieht man noch deutlicher im Diagramm auf der rechten Seite, wo der Anteil der Seiten sich praktisch an die Ordinate anschmiegt und dann „sofort“ bei 100 % ist. Das ist eine Sache, die bei der Beschreibung mit Worten gar nicht soooo dolle rueber kam.
Kleine Abschweifung: beide Diagramme enthalten die gleiche Information (oder gar die Selbe?). Aber erst durch die verschiedenen Abszissen wird man erst auf bestimmte Dinge aufmerksam.

Warum zeige ich das hier? Nun ja, davon abgesehen, dass das ’n cooles Diagramm ist, ist es auch wichtig fuer das was ich im Folgenden besprechen werde. Denn diese Darstellung brachte mich auf die Idee, dass man die beruehmt-beruechtigte Relevanz mglw. messen kann. Nicht dass ich denke, dass das irgendwen umstimmen wuerde, aber es ist mal interessant anzuschauen.

Die Grundlage der „Messbarkeit der Relevanz“ ist ganz einfach: ein Artikel ist relevant wenn er ein wichtiger Teil der Diskussion ist. Ein wichtiger Teil der Diskussion ist ein Artikel, wenn dieser oft zitiert wird. Wie oft ist oft? Das ist dann im Allgemeinen nicht mehr so einfach zu quantifizieren.
Aber das ist auch nicht wirklich nøtig, denn im Speziellen denke ich, dass ein Konsens darin gefunden werden kann, dass die paar Seiten (lila Punkt im linken Diagramm) die 50 % der Zitierungen (gruen/lila Punkt) auf sich vereinen mit Sicherheit relevant sind. Einfach aus der (messbaren und damit objektiven (?)) Tatsache, dass die so krass viele Zitierungen auf sich vereinen, obwohl es sich dabei um nur ein bisschen mehr als 1.5 % aller Wikipediaseiten handelt. Zur Erinnerung: hier hatte ich die 50 meistzitierten Seiten aufgelistet.

Damit stellt sich dann als naechstes die Frage: wer zitiert diese Seiten eigentlich so oft? Oder anders: „wer“ sorgt eigentlich dafuer, dass diese Seiten relevant werden (sind)? Und DAS ist messbar … wird aber ein dreidimensionales Datenfeld mit 32,433,025 Millionen Werten … aber ich greife vor.

Zunaechst einmal: wie kann das gemessen werden?
Nun ja, das ist (mehr oder weniger) ganz einfach. Ich habe fuer jede Seite die Zitate (vulgo Links zu anderen Wikipediaseiten). Nun gehe ich zum ersten Mal durch die Daten, schaue fuer jede Seite wie oft die von anderen Seiten zitiert wird und merke mir das. Damit habe ich nun ein Masz fuer die „Wertigkeit“, „Wichtigkeit“ oder eben „Relevanz“ einer Seite. Je mehr Zitierungen desto „relevanter“.
Dann gehe ich ein zweites Mal durch die Daten und fuer jede zitierte Seite merke ich mir dann, von welcher Wichtigkeit die Seite war, welche diese Zitierung ausgesprochen hat. Letzteres weisz ich ja vom ersten Durchgang.

Das muss ich zwar fuer jede Seite in Erfahrung bringen, aber die Information wird zusammengefasst in Gruppen nach ihrer Relevanz. Also bspw. wann immer eine Seite die fuenf Mal zitiert wurde von einer anderen Seite die drei Mal zitiert wurde zitiert wird, dann zaehlt der Zaehler dieser 3-5-Gruppe einen hoch. Damit habe ich 3596 mal 3596 Gruppen. Wie? Nur so wenige? Mindestens eine Seite wird doch deutlich mehr als 300-tausend mal zitiert. Die Erklaerung liegt darin (wie man im Diagramm auf der rechten Seite sieht), dass da ganz schøn viel „Luft“ zwischen den Balken mit groszer Anzahl an Zitierungen ist.

Lange Rede kurzer Sinn: der Relevanzwert entspricht der Anzahl der Zitierungen ohne Luecken. Dabei muss man dann im Kopf behalten, dass die Relevanzwerte von 0 bis 2075 tatsaechlich dem entsprechen wie oft eine Seite zitiert wurde. Hingegen entspricht der Relevanzwert 5695 der einen Seite, die mehr als 325-tausend mal zitiert wurde und der Relevanzwert von 5694 eben jener Seite die „nur“ ein bisschen mehr als 231-tausend mal zitiert wurde; usw. rueckwaerts is alle Luecken geschlossen sind.
Das ist gar nicht so verwirrend, wie es sich erstmal anhøren mag. Ich bilde nur die groszen Werte auf kleineren Werten nach einer gegebenen (determinischen) Zuordnungsfunktion ab. Im Wesentlichen zaehle ich nur etwas anders.

Auch wenn das eine deutliche Reduktion des Problems ist, so sind das dennoch die weiter oben erwaehnten 5695 mal 5695 = 32,433,025 Millionen Werte.
Als ich das das Erste Mal programmierte hackte ich nur kurz zusammen, was mir gerade in den Kopf kam. Die beiden Durchlaeufe brauchten zwei Tage. Dann merkte ich, dass ich einen Fehler gemacht hatte, korrigierte den und liesz das nochmal zwei Tage laufen.
Dann hatte ich die Idee, dass ich das Ganze ja gleich in eine Matrix schreiben kønnte. Die eine Dimension der Matrix ist die „Relevanz“ einer Seite (in ganzen Zahlen mit oben erwaehnter Zaehlung). Die andere Dimension ist die Relevanz der zitierenden Seite. Und der Wert eines Felds ist dann wie oft diese bestimmte „Gruppe“ in den Daten auftauchte. Der Code wure dadurch viel einfacher und leichter zu verstehen und mit dieser (grundlegend alles veraendernde) Modifikation brauchte das dann nur noch 15 Minuten anstatt 2 Tage.
Das mit der Matrix ist ja eigentlich eine naheliegende Idee und da haette ich auch gleich drauf kommen kønnen. Aber als ich anfing hatte ich noch keine klare und eindeutige Vorstellung davon, was ich eigentlich untersuchen wollte. Also ich hatte das schon, aber „nur“ in Worten. Mein Geist brauchte ein paar Tage um das intern zu mathematisieren. Aber dann ging’s fix :) … also zumindest das Datensammeln. Zu interpretieren was ich da eigentlich sehe dauerte dann noch einige Tage mehr.

Und so sieht das aus fuer alle (!) Seiten die ein bzw. zwei Mal (schwarze und rote Punkte) zitiert wurden und fuer die zwei Seiten mit den Relevanzwerten von 5694 bzw. 5695 (lila und blaue Punkte):

ACHTUNG: Die Linien sind nur zur Orientierung (der Richtung)! Es gibt keine Werte zwischen den ganzen Zahlen. Aber aufgrund der logarithmischen Abzsisse kann die Null nicht dargestellt werden und deswegen benøtigt es eine Orientierung der Richtung fuer den Verlauf vom Relevanzwert 1 zum Relevanzwert 0.
Fuer diese vier Beispiele sieht man, dass alle Seiten vor allem von „nicht relevanten“ Seiten zitiert werden. Fuer die selber „nicht relevanten“ Seiten bedeutet das mglw., dass die sich „im Kreis zitieren“. Sozusagen wenn Hintertupfingen Vordertupfingen zitiert, weil’s das Nachbardorf ist (und umgekehrt), aber beide von keiner anderen Seite zitiert werden.
Interssant ist, dass Seiten mit einem Relevanzwert von 1 vor allem von Seiten mit einem Relevanzwert von 0 zitiert werden, also von Seiten die ihrerseits NICHT zitiert werden.
Uebrigens tut das nix zur Sache, dass der høchste lila Punkt (von der am zweitmeisten zitierten Seite) deutlich høher ist als der høchste blaue Punkt. Das Integral unter der Kurve entspricht der Anzahl aller Zitierungen und die blauen Punkte sind zu groszen Relevanzwerten hin immer ueber den lila Punkten. Das sieht man aber in der linearen Darstellung nicht, weil die Werte unter 1000 liegen.
Die schwarzen und roten Punkte liegen da uebrigens nochmal drueber, denn alle Seiten die ein mal zitiert wurden sind ja viel mehr als die (buchstaeblich) zwei meistzitierten Seiten … oder anders: Kleinvieh macht auch Mist.

Bemerkenswert ist nun, dass auch die zwei meistzitierten (und damit die zwei relevantesten) Seiten am haeufigsten von „nicht relevanten“ Seiten zitiert werden. Wait! What? Das wuerde doch bedeuten, dass die nur deswegen relevant sind weil sie von „nicht relevanten“ Seiten zitiert werden! Was im Umkehrschluss bedeutet, dass die ganze Relevanzdiskussion fuer’n Arm ist, weil es die einen nicht ohne die anderen geben kann.

Aber das sind nur vier Beispiele. Fuer die Gueltigkeit dieser Aussage muss ich das fuer alle (oder zumindest die Mehrheit) der relevanten Seiten zeigen. Nun weisz ich aber aus Erfahrung, dass man nix mehr erkennt, wenn man fast 5700 Kurven darstellt. Ich kann das aber als Falschfarbenbild darstellen. Dazu aber mehr beim naeachsten Mal  … … … Na gut … hier schon mal ein Spoiler … tihihi:

Keine Sorge, das wird noch spannend :) .