2021-04-23 ist das Datum des allerersten Beitrags in dieser Kevin-Bacon-Megamaxiserie. Das Projekt begann aber Monate vorher, denn ich musste ja erstmal darueber nachdenken wie ich die benøtigten Daten aus der Wikipedia herauskitzeln kann. Leider habe ich den Tag des wirklich wahren Anfangs nicht aufgeschrieben; aber 2021-01-08 ist das Datum an dem die Datei mit der dekomprimierten Wikipedia auf meiner Festplatte zum ersten Mal erstellt wurde.
Dem ersten Artikel folgten in der originalen Analyse, mit allen Ablenkungen und Kommentaren und so, 131 weitere Artikel. In der Reproduktionsphase schrieb ich (inklusive diesem hier) ganz genau 50 weitere Beitraege. Zwei abschlieszende (geheime) stehen noch aus … wobei ich mit genauen Zahle diesbezueglich vllt. nicht so voreilig sein sollte. Kevin hat schlieszlich immer wieder gezeigt, dass’s unerwartet mehr wird.
Ich konnte dem inneren Drang alle Wørter zu zaehlen nicht widerstehen. Die nachfolgenden Zahlen sind nicht alle exakt aber zumindest vernuenftig gerundet. Dennoch sind sie vermutlich etwas zu genau ist, denn ich habe nur ’ne grobe Analyse vorgenommen. Vereinfachend gesagt habe ich alle Texte an den Leerzeichen getrennt und dann nur die Anzahl der einzelnen Elemente hergenommen.
Das wiederum bedeutet, das Bindestrichkonstrukte wie „das-ist-ein-Beispiel“ nur als ein Wort zaehlen. Andererseits zaehlt ein “ :) “ auch als ein Wort; ebenso der slash in „foo / bar“. Und Zitate zaehlen die enthaltenden Wørter nocheinmal. Mein Bauchgefuehl sagt mir aber, dass’s insgesamt schon passen sollte. Nu aber Butter bei die Fische.
Alle Zahlen beinhalten auch den vorliegenden Beitrag. Insgesamt brachte ich ungefaehr 168-tausend Wørter in diesen Artikeln zu „Papier“. Das entspricht zwei Erstlingsromanen (die im Durchschnitt ca. 75-tausend Wørter lang sind).
Im Mittel hat ein Artikel 915 Wørter und mit einem Wert von 891 Wørtern hat der Median im Wesentlichen den gleichen Wert. Die Standardabweichung betraegt 421 Wørter.
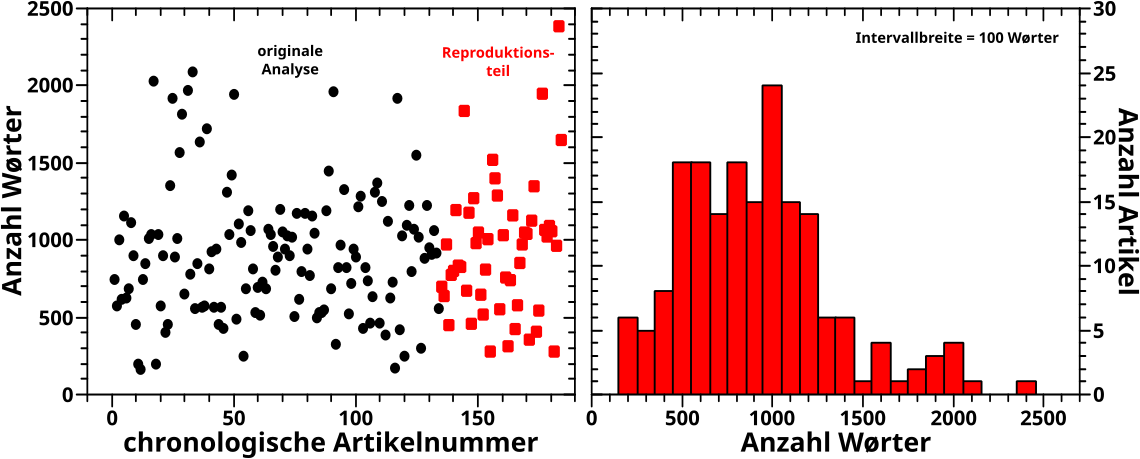
Der Geburtstagsbeitrag vom letzten Mal ist der Høhenrekord mit 2,387 Wørtern, waehrend ich beim Tiefenrekord nur 159 Wørter schrieb (dieser wurde fruehzeitig gesetzt). Zu jeder Zeit kamen immer mal wieder andere Artikel (fast) an diese Zahlen ran … ich habe das (natuerlich) mal diagrammisiert:
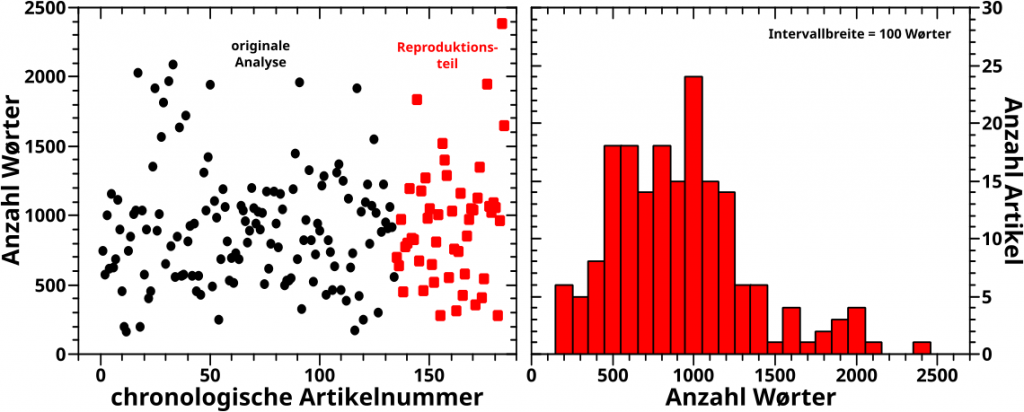
Im linken Bild sieht man fuer jeden Artikel die Anzahl der Wørter; farblich kodiert habe ich die zwei Teile des Projekts. Die (Daten)Punkte scheinen sich ziemlich gleichmaeszig zu verteilen auf den ersten Blick. Das wuerde passen mit den recht aehnlichen Werten fuer Durchschnitt und Median. Auf den zweiten Blick hingegen, nachdem man geistig einen Balken um den oben erwaehnten Mittelwert reinlegt, scheint’s dann aber ein paar mehr Punkte unterhalb des Mittelwerts als oberhalb davon zu geben. Deswegen gibt’s das Histogramm dazu auf der rechten Seite.
Die Intervallbreite betraegt 100 Wørter und der „dicke Klotz“ links des 900 Wørter-Balkens macht den Eindruck, dass dort mehr liegt. Von der Anzahl der Artikel ist das tatsaechlich so. Und wuerde man nur 7 Intervalle um den Mittelwert zulassen, dann wuerde das gleiche bzgl. der Wortzahl gelten. Aber die zwølf besonders wortreichen Artikel mit mehr als 1600 Wørtern vereinen ueber 23-tausend Wørter auf sich und das zieht den „Schwerpunkt“ der Wortzahl zu etwas høheren Werten … so funktioniert der Mittelwert halt und ich erwaehnte den Nachteil des darin liegenden Informationsverlust neulich.
Ich schaute mir auch mal die Worthaeufigkeiten an, da kam aber (fast) nix bei rum. Die ueblichen Verdaechtigen sind wie immer ganz oben dabei; also Worte wie „die“ (ca. 5,700 mal), „der“ (ca. 4,500 mal), „das“ (ca. 4.000 mal), „und“ (ca. 3,600 mal), „ist“ (ca. 2,500 mal), „nicht“ (ca. 1,900 mal), „aber“ (ca. 1,900 mal), „dass“ (ca. 1,700 mal) etc. pp.
Das erste interessante das auftritt ist dann auch gar kein Wort sondern das Sonderzeichen “ … “ , welches (inklusive diesem hier) 1,544 mal auftritt. Von weiterem Interesse war das Wort „Seite“ (auch im Zusammenhang wie „Kettenseite“ oder natuerlich „Wikipediaseiten“) und das tritt mehr als 1700 mal auf. Das Wort „Links“ tritt ca. 1000 mal auf. Im Gegensatz dazu erscheinen „Zitate“ (schon zusammen mit den „Zitierungen“ gezaehlt) nur knapp 350 mal. Und als allerletztes sei noch „Linklevel“ erwaehnt, welches ungefaeher 600 mal auftritt.
Apropos Linklevel, ich habe hier mal aufgetragen, wie oft die Abkuerzungen LLi in Abhaengigkeit von “ i “ zu sehen sind:
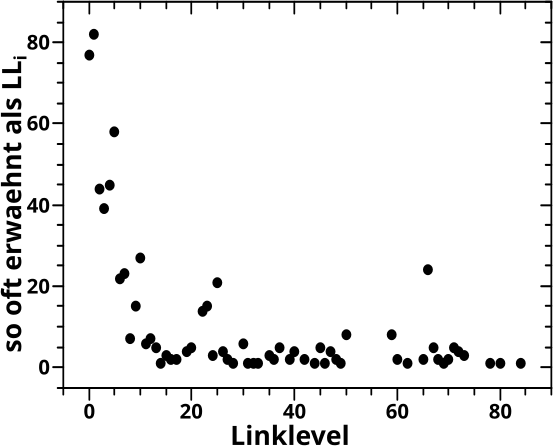
Das ist alles erklaerbar. LL0 & LL1 sind reichlich zu Erklaerungen herangezogen worden. Bis ungefaehr LL10 passiert ziemlich viel und ich habe das oft im Detail untersucht. LL23 tritt so haeufig auf, weil ich das gerne als „zufaelliges“ Linklevel nehme (dito fuer LL5) und LL25 habe ich nicht selten als Grenze fuer „hier-ist-jetzt-definitiv-ein-anderes-Verhalten-als-vorher“ genommen. Wenn ich mich richtig erinnere ist LL66 das Linkevel an dem die ersten Seiten anfangen „auszusteigen“; entsprechend oft wird das genannt worden sein.
Kurios ist die Kluft zwischen LL50 & LL59 … aber da passiert halt nuescht … andererseits passiert auch nuescht zwischen LL25 und LL50 aber dort habe ich trotzdem Datenpunkte … mhmmmmm.
Der einzige Punkt den ich nicht auf Anhieb erklaeren kann, ist LL22. Andererseits tritt das (inklusive diesem hier) dann doch nur 14 mal auf und das ist jetzt in 2 ganzen Romanen die Zeuch auf Linkleveln beschreiben wo irgendwie doch was in dem Bereich passiert (siehe die Bemerkung zu LL25) dann mglw. doch nicht soooo haeufig.
Soweit dazu … das waren aber nur die Wørter in den Artikeln. Dazu kommt noch der Code … das ist aber etwas komplizierter. Am einfachsten ist noch die generelle (zugegeben, oft sehr spezifische) Dokumentation der Programme an sich. Da schrieb ich ca. 48-tausend Wørter … ach du Schreck.
Der Code wird weiter unterteilt in Python und C. Und da gebe ich natuerlich auch die Anzahl der Linien an … weil … das macht man halt so.
Insgesamt sind’s 21,073 Linien von denen 19,081 auf Python und 1,992 auf C entfallen. Davon sind aber insgesamt 9,643 Linien Kommentare (Python: 8,673 / C: 970); das entspricht ca. 45 %. Weitere ungefaher 25 % sind leere Zeilen, damit der Code leichter zu lesen und dessen Struktur besser zu erkennen ist und ueberhaupt, dass es nicht wie Querbeet aussieht; das entspricht 5,426 Linien (Python: 4,968 / C: 458).
Der Rest sind der eigentliche Code und ich komme da insgesamt auf genau 6,004 Linien (Python: 5,440 / C: 564).
Insbesondere auf die nur 564 C-Zeilen bin ich recht stolz. Ich denke, dass das Programm an und fuer sich relativ komplex ist, insb. mit dem was „unter der Haube“ passiert (Zeuch auf das ich an dieser Stelle nie im Detail eingegangen bin) … und ich hab’s trotzdem so klein halten kønnen.
Ueberhaupt zeigt das recht eindrucksvoll, wieviel man aus derart schlanken Programmen herausholen kann, wenn die relativ spezifischen Aufgaben gewidmet sind.
Und nun zur Anzahl der Wørter in den Kommentaren und dem Code an sich. Die Kommentare sind einfach, denn das ist „plain old english“ und im Wesentlichen gelten die gleichen Limitierungen wie zu den Artikeln.
Ich komme insgesamt auf ca. 65-tausend (Python) + ca. 7,500 (C) = ca. 72,500 Wørter insgesamt in den Kommentaren … ach du Schreck. In nicht unbetraechtlichen Teilen ist das nochmal Zeuch was schon in der Dokumentation steht (weil’s zum Verstaendniss der Strukturen und Details im Code beitraegt … hoffe ich). Es beinhaltet aber natuerlich auch sehr viel „operativen Kram“ (wie die Erklaerung warum man in einer Liste das erste Element weglaeszt oder warum eine Schleife nicht ganz bis zum Ende zaehlt etc. pp.) und einfach nur „beschreibenden Text“, der das Lesen und verstehen erleichtern soll.
Beim Code an sich ist das etwas uneindeutiger. Denn viele Zeichen wie “ <= “ oder “ { “ werden als Wort gezaehlt bei meiner einfachen Zaehlweise. Und natuerlich gibt’s urst viele „if“, „then“, „continue“, „for“ etc. pp. und auch einen guten Anteil Zaehlvariablen (meistens einfach nur ein “ i „). Dann wiederum wird sowas wie line.strip().split('\t')[1:] nur als ein einziges „Wort“ gezaehlt. Wieauchimmer, ich komme auf ca. 22-tausend (Python) + ca. 1,500 (C) = ca. 23,500 Wørter (oder „Wørter“) insgesamt, die sich nur im Code befinden. Das selbe was ich oben zu den Linien im C-Code sagte kønnte ich hier wiederholen … ich denke, dass ich da zu Recht durchaus stolz auf mich sein kann.
Summa summarum betraegt die Anzahl der Wørter im Code und in der Dokumentation ungefaehr 145-tausend. Also zwei weitere Buecher … krass … insb. wenn man bedenkt, dass das was am meisten Spasz macht (der Code an sich, ohne Kommentare oder Dokumentation) davon nur ca. 15 % ausmacht … und der Teil der am meisten Freude brachte (besagter C code) sogar gerade mal nur ein Prozent.
So … nun wird das noch mit den Wørtern in den Weblogartikeln zusammengezaehlt und ich komme auf insgesamt ungefaehr 310-tausend Wørter … krassomat!
Das war’s aber noch nicht … ein bisschen habe ich noch. Das geht aber schnell, denn es handelt sich dabei um die Anzahl der Bilder. Ich erstellte ueber eintausendzweihundert Bilder und Diagramme … wow! Gezeigt habe ich aber weniger als 500, denn ein nicht unbetrechtlicher Teil ist (mehr oder weniger) versteckt in den „bewegten“ Bilder (aber jeder „Frame“ musste ja einzeln erstellt werden).
Und das war er dann jetzt wirklich … der letzte ordentliche Artikel und die letzten Diagramme im groszen Kevin Bacon Projekt, was mich und euch, meinen lieben Leserinnen und Leser, fast 5 1/2 Jahre lange begleitete.
Viel wurde gesehen, viel wurde ausprobiert, viel wurde verstanden, viel wurde geschrieben (s.o.) und oft genug hatte ich keine Lust mehr. Aber ich habe es vollendet und nun ist’s offiziell dann doch vorbei … ich gebe ehrlich zu: endlich. Ich muss auch zugeben, dass’s sich noch nicht „ganz echt“ anfuehlt; ein mir nicht unbekannter „Zustand“, kenne ich das doch vom Diplom und den zwei Doktorgraden. Grosze Projekte haben das vermutlich so an sich.
Ganz im Geiste des Kevin Bacon Projektes kommt natuerlich doch noch was. Naemlich die zwei erwaehnten (immer noch) geheimen Artikel. Die sind aber nix „handfestes“ mehr, dort wird nix analysiert, modelliert, simuliert oder kommentiert und Diagramme gibt’s darin auch nicht.
Aber weil das der letzte „richtige“ Artikel ist, møchte ich sagen: toll war’s! Ich habe so viel gelernt und ich bin froh, dass ich damals Ende 2020 die Idee hatte mir das mal anzuschauen … auch wenn ich dachte, dass ich das ganze in ca. 6 Artikeln abarbeiten kann … tja … so kann man sich taeuschen … aber die „Taeuschung“ war gut, denn ich (als Søren) fuehle mich durch das Kevin Bacon Projekt tatsaechlich bereichert.