Archive for the ‘Kevin Bacon’ Category

Beim letzten Mal kuendigte ich eine Untergruppenanalyse an … natuerlich mit Blick auf die Frage wieviele Schritte eine Seite im Durchschnitt machen muss um eine andere Seite zu erreichen.

Bzgl. der Untergruppen schrieb ich zunaechst was von „wichtigen“ und „unwichtigen“ Seiten, aber das sind natuerlich schwer (bzw. gar nicht) zu quantifizierende Begriffe.
Hier kommt mir nun zu Hilfe, dass ich mich bereits an einem aehnlich schwer zu quantifizierenden Begriff, naemlich der Relevanz, abgearbeitet habe. Dort nahm ich einen „Umweg“ ueber die Anzahl der Zitate die eine Seite erhielt um dieser dann einen „Relevanzwert“ zuzuordnen. Ungefaehr so mache ich das hier auch.

Wie in den letzten beiden Artikeln dargelegt muss die Frage aus zwei „Richtungen“ beantwortet werden; wie schnell erreicht eine Seite andere Seite und wie schnell erreichen andere Seiten (die) eine Seite.
Die Zugehørigkeit einer Seite zu einer bestimmten Gruppe laeszt sich dann durch die Anzahl der Links die die Seite hat bzw. die Zitate die diese (direkt) von anderen Seiten bekommt bestimmen. Anstatt Gruppen fuer „unwichtige“, „mittelwichtige“ und „wichtige“ Seiten habe ich nun also Gruppen fuer Seiten mit „wenigen“, „mittelvielen“ und „vielen“ Links bzw. Zitaten.

Wieviele Links bzw. Zitate das jeweils sein muessen scheint zunaechst immer noch subjektiv zu sein, aber ich versuche heute darzulegen inwieweit das „objektiviert“ werden kann (um mich dann beim naechsten Mal der eigtl. Untergruppenanalyse zu widmen).
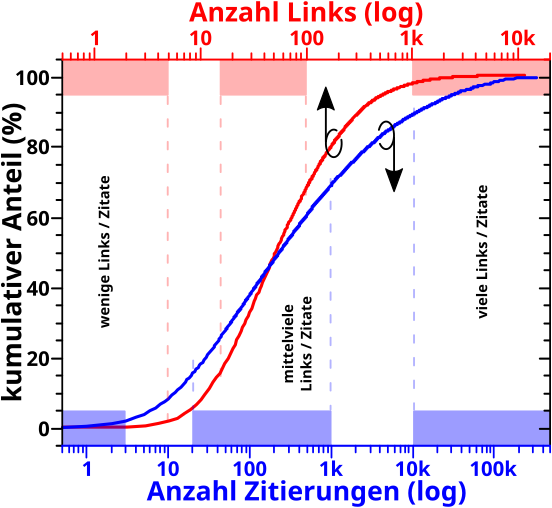
Dazu nehme ich zwei vorhergehende Resultate zu Hilfe: die Kurven der kumulativen Links / Zitate per Seite in (logarithmischer) Abhaengigkeit von der Anzahl eben diesen Links / Zitate.

Zur Erinnerung: die Kurven berechnete ich aus den Histogrammen. Bei Letzteren war die Anzahl der Links pro Seite bzw. Zitate die eben diese erhielt auf der Abzsisse abgetragen, waehrend die Ordinate nur „zaehlte“, wie oft eine Seite mit so vielen Links / Zitaten in der Wikipedia vorkommt.
Fuer die „kumulativen Kurven“ wird die Abzisse beibehalten. Fuer jeden Wert auf der Abzsisse rechnete ich dann zunaechst das Produkt aus diesem Wert (also die Anzahl der Links / Zitate) mit dem entsprechenden „Zaehler“ des Histogramms aus. Das Produkt deswegen, weil bspw. 23 Seiten mit jeweils 10 Links zum kumulative-Links-Signal 230 „Punkte“ beitragen. Wie fuer kumulative Kurven ueblich, addierte ich schlussendlich die Werte von links (also null) beginnend auf und nach „Normierung“ auf 100 % hatte ich die entsprechenden Diagramme.

Von Interesse ist jetzt die S-Form der Kurven (bei logarithmischer Abzsisse). Es gibt drei deutlich unterscheidbare Bereiche.
– Einen Anfang, bei dem trotz der hohen Anzahl von Seiten das Signal nur sehr langsam ansteigt, weil diese nur sehr wenige Links / Zitate haben.
– Einen mittleren Bereich, in dem die Kurve linear ansteigt. Weil die Abzsisse logarithmisch ist, bedeutet das, dass „in Echt“ der Anstieg der Kurve URST KRASS ist, trotzdem die Anzahl der Seiten nach einem maechtigen Gesetz abnimmt … obige Multiplikation ist dafuer verantwortlich.
– Ein Ende, in dem trotz der hohen Anzahl an Links / Zitaten das Signal (wieder) nur sehr langsam waechst, weil es da nur sehr wenige Seiten gibt die so viele Links / Zitate haben. Also die umgekehrte Situation zum Anfang.

Diese drei Bereiche entsprechen den oberen Gruppen … wobei das Adjektiv „mittelviele“ unguenstig gewaehlt ist … aber mir faellt kein anderes ein. Das folgende Diagramm verdeutlicht die Situation und macht (hoffentlich) klar, dass man die obige (zunaechst) subjektiv erscheinende Situation „objektivieren“ kann (man beachte die unterschiedlichen Abzsissen):

Die Tabelle enthaelt die „Kennwerte“ fuer die drei gewaehlten Bereiche (wenige, mittelviele, viele) die dann in nochmal zwei Untergruppen (Anzahl Links oder Zitate) unterteilt sind:

Gruppe||AbkuerzungLinks von … bisumfasst so viele Seiten||AbkuerzungZitierungen von … bisumfasst so viele Seiten
"wenige"||U(ntergruppe) W(enige) L(inks) = UWL0 … 5778,958 (13.43 %)||U(ntergruppe) W(enige) Z(itate) = UWZ0 … 32,198,825 (37.92 %)
"mittelviele"||UML16 … 1002,515,857 (40.9 %)||UMZ20 … 1k1,149,358 (18.95 %)
"viele"||UVL1k … Schluss2,380 (0.04 %)||UVZ10k … Schluss703 (0.01 %)

Am Diagramm und den Zahlen in der Tabelle sieht man, dass die Gruppen NICHT identisch sind, ja deutliche Unterschiede aufweisen. Das fetzt, macht es das ganze naemlich interessant.
Natuerlicherweise befinden sich viele der Seiten die nach der Anzahl der Links eingruppiert wurden auch in der gleichen Gruppe bezueglich der Zitate. Der Grund liegt im „maechtigen Zusammenhang“ zwischen der Anzahl der Links und der Anzahl der Zitate.
Genauer gesagt sind 562,474 der Seiten in der Gruppe mit wenigen Links auch in der Gruppe mit wenigen Zitaten. In den Gruppen mit den „mittelvielen“ Links / Zitaten sind es 863,304 Seiten. Allerdings sind es nur 33 Seiten in der Gruppen mit den vielen Links / Zitaten. Letzteres erklaert sich daraus, dass in diesem Bereich der oben erwaehnte „maechtige Zusammenhang“ fuer viele (die meisten?) der sich dort befindenden Seiten nicht mehr gilt.

Das Verhalten dieser sechs Gruppen wird beim naechsten Mal jeweils paarweise analysiert. Die Statistik fuer die ersten beiden sollte gut genug sein, sodass ich dort trotz der Unterschiede nur geringe Diskrepanzen erwarte, was die „Richtung“ der Beantwortung der Frage angeht.
Augrund des geringen Ueberlapps wuerde mich bei den Gruppen mit den vielen „Links / Zitaten unterschiedliche Resulte nicht verwundern … ich kønnte mir sogar denken, dass die relativ grosz sind … aber das dann erst beim naechsten Mal.

Zur Wiederholung: beim letzten Mal formulierte ich die Frage …

[…] wieviele „Schritte“ braucht man im Durchschnitt von irgendeiner Seite zu irgendeiner anderen Seite?

… und nahm die (kumulative) Anzahl der neuen Links zur Hilfe um diese zu beantworten. Aber das war nur eine Haelfte der Antwort, denn die neuen Links zeigen nur,

[…] wieviele Schritte […] eine [Urpsrungs]Seite im Durchschnitt machen [muss] um irgendeine andere Seite zu sehen […].

Die andere „Haelfte“ der Antwort muss schauen,

[…] wieviele Schritte […] ANDERE Seiten machen [muessen] um die eine Seite zu sehe.

Da sollte im Durchschnitt das Gleiche bei rauskommen, aber im konkreten Fall muss dem nicht so sein. Ich gab beim letzten Mal ein Beispiel und erwaehnte bereits, dass ich fuer die zweite Haelfte der Antwort die Linkfrequenz nutzen werde,

denn diese misst auf welchem Linklevel eine gegebene Seite von anderen Seiten gesehen wird […].

Leider wird bei der Linkfrequenz ein groszer Teil der urspruenglichen Information „verlustbehaftet komprimiert„, denn diese misst nur, OB eine Seite von einer anderen Seite (auf einem gegebenen Linklevel) gesehen wird. Weder beinhaltet die Linkfrequenz Information darueber wie oft die andere Seite die eine Seite (auf einem gegebenen Linklevel) sieht, noch ob die andere Seite die eine Seite bereits auf einem vorherigen Linklevel gesehen hat. Ersteres ist im hiesigen Zusammenhang nicht schlimm, denn das interessiert mich nicht. Letzteres ist fuer obige Frage allerdings von allergrøsztem Interesse.

Oder anders: in der Linkfrequenz einer Seite kommt es zu Mehrfachzaehlungen durch „Mehrfachsichtungen“. Bspw. kann die andere Seite die eine Seite sowohl auf LL5 als auch auf LL23 sehen. Die zweite Sichtung duerfte ich in Anbetracht dessen das was ich hier beantworten will NICHT mehr mitzaehlen. Aber eben genau diese Information, dass (im Beispiel) mindestens ein „Punkt“ des Wertes auf LL23 eine „wiederholte Sichtung“ ist, fehlt.

Mehrfachsichtungen sollten i.A. keine all zu grosze Rolle spielen auf sehr kleinen Linkleveln. Das liegt daran, weil bei kleinen Linkleveln, die zitierten Seiten thematisch nahe an der Ursprungsseite liegen. Da kommt es dann zwar bestimmt zu Mehrfachsichtungen „thematisch naher“ Seiten, das sind aber im Groszen und Ganzen nur ein paar Seiten und alle anderen Seite der Wikipedia tauchen noch gar nicht auf.
Andererseits verzweigt sich das Linknetzwerk extrem schnell und schon nach ein paar wenigen Linkleveln sieht man nicht mehr nur Seiten zu einem Thema, sondern zu sehr sehr sehr vielen Themen (und die Linkfrequenzen der entsprechenden Seiten gehen um eins hoch). Viele von diesen Seiten sieht man dann auf den darauffolgenden Linkeveln nochmal (auch wenn man dem Link nicht nochmal folgt) und deren Linkfrequenz geht (fuer das entsprechende Linklevel) wieder um eins hoch. Letzteres liegt einfach an der schieren Menge an gleichzeitig erreichten Seiten, welche schonmal gesehene Seiten (wieder) zitieren.

Eine wichtige Schlussfolgerung aus dem eben Gesagten ist, dass der (durchschnittliche) kumulative Anteil der Linkfrequenz nach genuegend Linkleveln die 100 % (deutlich) uebersteigen (sollte). Das wiederum hat eine weitreichende Konsequenz, denn anders als bei den neuen Links kann ich nun nicht mehr das Integral unter der (Summen)Kurve benutzen um den durchschnittlichen (nicht kumulativen) Anteil pro Linklevel auszurechnen.

Das bereitete mir zunaechst Kopfzerbrechen, aber letztlich kam ich dann auf die folgende, hoffentlich plausible Methode um eben diesen durchschnittlichen Anteil (pro Linklevel) auszurechnen (und daraus dann den kumulativen Anteil).
In kurz: das Summensignal der Linkfrequenz muss auf jedem Linklevel zwei Mal (!) durch die Anzahl aller Seiten geteilt werden.

Fuer die etwas laengere Erklaerung denke man sich zunaechst die Linkfrequenz EINER Seite auf einem sehr niedrigen Linklevel (bspw. LL1). Diese Seite kann prinzipiell von allen (fast) 6 Millionen anderen Seiten gesehen werden. Um den durchschnittlichen Anteil der Seiten zu bekommen die diese Seite auf dem Linklevel sehen, muss ich die erste Division durch (fast) 6 Millionen ausfuehren.
Das Summensignal ist nun aber die Summe (Doh!) der Linkfrequenzen ALLER ((fast) 6 Millionen) Seiten. Daher die zweite Division.
Aber Achtung (kurzer Einschub): wenn man nur bestimmte Untergruppen (z.B. vielzitierte Seiten) betrachtet, dann ist der Nenner bei der zweiten Division natuerlich NICHT (fast) 6 Millionen sondern NUR durch die Anzahl der Seiten in der Untergruppe. Die Situation bzgl. der erste Division aendert sich bei Untergruppen nicht. Ich greife damit aber vor und das wird erst im naechsten (oder vllt. uebernaechsten) Artikel wichtig; ich wollte das nur hier schon erwaehnen, damit es erledigt ist.

Diese ganze Huette ist der Grund, warum ich das Thema mit den neuen Links angefangen habe; bei denen ist das alles viel einfacher zu verstehen und ich musste nicht lang und breit erklaeren, wie ich die Information von Interesse aus den Daten gepolkt habe. Die Linkfrequenz ist aber nicht aus Unueberlegtheit mit „Informationsverlust“ konzipiert worden. Vielmehr stand ich vor dem Dilemma, dass das Datenvolumen der Resultate der Linknetzwerkanalyse ohne diese „verlustbehaftete Komprimierung“ der Information mindestens etliche hundert Terabyte (mich duenkt gar im niedrigen Petabyte Bereich) betragen haette.
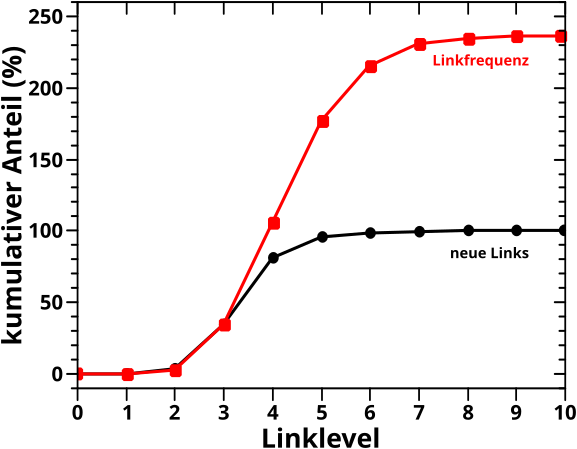
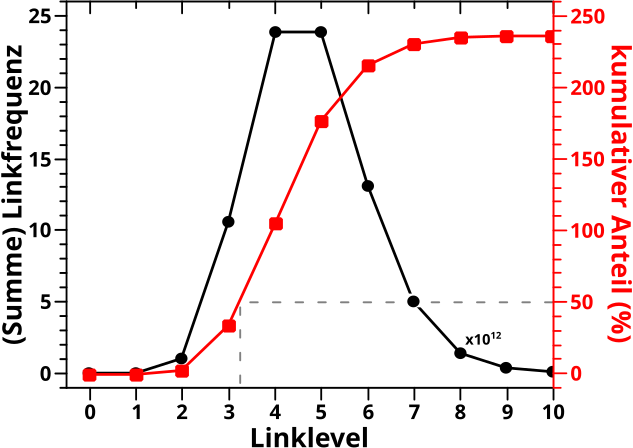
Aber nun ist alles zum Verstaendniss wichtige gesagt und ich kann das gleiche Diagramm wie beim letzten Mal zeigen; die Summe aller Linkfrequenzen fuer kleine Linklevel und der durchschnittliche kumulative Anteil der Seiten die eine andere Seite bis zum gegebenen Linklevel gesehen haben:

Wie beim letzten Mal gilt, dass die schwarze Kurve mit einer Billion multipliziert werden muss. Aber auch heute ist die nicht wirklich von Interesse, denn die wurde bereits hier besprochen (das ist uebrigens kein Plateau, das sieht nur so aus, weil da so wenig passiert).
Wieauchimmer, die rote Kurve zeigt die Groesze die hier von Interesse ist und die Form ist die selbe „S“-Kurve wie beim letzten Mal. Ebenso wie beim letzten Mal (und wie erwartet) wird der 50 % Anteil zwischen dem 3. und 4. Linklevel ueberschritten. Und letztlich, wie erwaehnt, fuehren die Mehrfachzaehlungen dazu, dass der endgueltige kumulative Anteil 100 % uebersteigt; genauer gesagt wird im Durchschnitt jede Seite (fast) zweieinhalb Mal von jeder anderen Seite gesehen.

Jetzt ist noch von Interesse, inwieweit die Ergebnisse vom letzten Mal mit den Ergebnissen von heute uebereinstimmen. Wie gesagt, das sollte im Durchschnitt (!) das Gleiche sein (bis der Einfluss von Mehrfachzaehlungen zu grosz wird und einen Vergleich nicht mehr zulassen). Deswegen habe ich das hier mal zusammen aufgetragen:

Ich muss sagen, dass mir ein Stein vom Herzen gefallen ist, als ich sah, dass beide Kurven bis LL3 (beinahe) deckungsgleich sind. Ich haette naemlich nicht gewusst, wie eine signifikante Diskrepanz zu erklaeren ist.

So … damit ist die implizite Frage des ersten Beitrags beantwortet. Ich bin aber noch nicht fertig, denn zwischen dem allerersten und diesem Beitrag habe ich viel gelernt ueber die Wikipedia. Eine der wichtigsten Erkenntnisse war, dass nicht alle Seiten gleich sind und die Dynamik von ein paar wenigen Seiten absolut dominiert wird (siehe bspw. hier, das zieht sich aber durch etliche Beitraege).
Oder anders: es gibt „wichtige“ und „unwichtige“ Seiten … und mglw. auch „mittelwichtige“ … womit sich die Frage stellt, ob das Ergebniss fuer alle Seiten gleich aus sieht? Mein Bauchgefuehl sagt erstmal nein … aber dann will mein Bauch auch gerne wissen ob er richtig liegt und wie die Unterschiede aussehen.

Lange Rede kurzer Sinn: im Durchschnitt ist alles fertig und die Frage beantwortet, ich werde aber das Verhalten von Untergruppen noch naeher untersuchen. Dazu werde ich beim naechsten Mal zunaechst drei Untergruppen definieren (Spoiler: das hat rein GAR NIX mit „wichtig“ oder „unwichtig“ zu tun) um mir deren Verhalten beim uebernaechsten Mal genauer anzuschauen.
Aufgrund der bereits geleisteten Vorarbeit wird das dann auch alles mit weniger Geschreibe zu erledigen sein (hoffe ich).

Da schrieb ich beim letzten Mal, dass …

[i]ch […] mich darauf [freue], diese Maxiserie nach fast drei Jahren abzuschlieszen

und prompt faellt mir auf, dass im allerersten Beitrag nur eine einzige Frage konkret … nun ja … nicht gestellt wird, sondern ich sag jetzt mal im Raum haengt und ich die nie behandelt habe.
So ziemlich alles was ich behandelte „erzaehlten“ mir die Daten selbst und ich musste die zu den Antworten gehørenden Fragen oft genug erstmal finden. Was natuerlich erklaert, warum ich besagte Frage bisher nicht behandelt habe, denn ich stellte sie ja nicht konkret und die Antwort dazu ist bisher nicht „aus den Daten gefallen“.

Worueber rede ich eigentlich? Nun ja, im ersten Beitrag gab ich an, wie man von Trondheim zu Kevin Bacon gelangt und tue das sogleich als wenig von Interesse ab:

[f]uer so ein paar konkrete Fragen war dieses Spielzeug ganz nett.

Vielmehr …

[…] wollte [ich] wissen, wie alles mit allem anderen zusammenhaengt.

Die im Raum haengende, nicht gestellte, konkrete Frage ist dann natuerlich: wieviele „Schritte“ braucht man im Durchschnitt von irgendeiner Seite zu irgendeiner anderen Seite?
Und ich muss sogleich sagen, dass ich diese Frage NICHT direkt (!) beantworten kann, denn dafuer habe ich die Daten nicht.

Fuer eine direkte Beantwortung waere es fuer jede Seite nøtig zu wissen, wann diese von jeder anderen Seite gesehen wird. Theoretisch kann man diese Information sammeln, das wuerde aber ein (dreidimensionales) Datenfeld der Grøsze 6 Millionen zum Quadrat mal 100 erfordern … jede Seite zu jeder anderen Seite mal die Anzahl der erwarteten Linklevel.
Das ist der technische Grund gewesen, warum ich die Linkfrequenz einfuehrte (die sich spaeter auf verschiedenste Weisen als extrem erfolgreich herausstellte). Bei der Linkfrequenz handelt es sich um eine Art „Projektion“ (mit (gewaltiger) Informationsminderung) des originalen 3D-Datenfeldes auf nur 2 Dimensionen, was die benøtigte Grøsze um mehr als sechseinhalb Grøszenordnungen vermindert (nur noch 6 Millionen mal 100). Dennoch erfordert das immer noch ca. 2 GB Arbeitsspeicher … womit man sich ausrechnen kann, dass die originale Idee ungefaehr 10 Petabyte (!) RAM braucht. Sportlich, nicht wahr.
Jaja, man kønnte das originale Problem immer nur eine Seite auf einmal machen, dann reichen auch 2 GB RAM … aber das Ergebniss will ja auch gespeichert werden zur nachfolgenden weiteren Analyse … und da braucht man dann doch wieder die 10 Petabyte (nur nicht als RAM sondern auf der Festplatte).

Wieauchimmer, ich kann die Frage gluecklicherweise indirekt angehen und meiner Meinung nach auch zufriedenstellend beantworten. Dafuer sind endlich mal die neuen Links pro Linklevel von Interesse (die ja bisher eher weniger „fruchtbar“ waren) und (wieder einmal) die Linkfrequenz. Aber wie immer ist das zumindest in Teilen nicht so einfach.

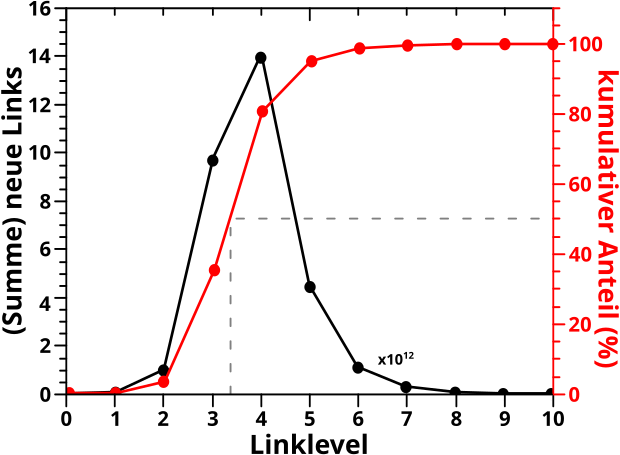
Ich beginne mit der Anzahl der neuen Links pro Linklevel. Korrekter: mit der Summe dieser Grøsze ueber alle Seiten und das Ganze per Linklevel. Das wurde hier schonmal gezeigt und die diagrammisierte das bis LL10 mit linearer (linker) Ordinate in diesem Bild als schwarze Kurve nochmals (man beachte das schwarze (!) „x1012„, welches ausdrueckt, dass die Werte fuer die schwarze Kurve damit multipliziert werden muessen um die (tatsaechliche) Anzahl der neuen Links (pro Linklevel) zu erhalten … das ist aber im hiesigen Zusammenhang eher eine Formalitaet, da mich der Wert an sich ja gar nicht weiter interessiert):

Zur Erinnerung: von einer Urpsrungsseite ausgehend, druecken die neuen Links auf jedem Linklevel aus, wieviele von allen Links die ich auf dem gegebenen Linklevel sehe, auf keinem vorherigen Linklevel auftauchten. Das (bestimmte) Integral unter dieser Kurve ergibt dann die Anzahl aller Wikipediaseiten (unabhaengig von der Ursprungsseite). Das Integral der obigen schwarzen Kurve ist dann also die Anzahl aller Wikipediaseiten zum Quadrat (da die Kurve ja das Summensignal ueber alle Seiten ist).

Kurzer Einschub und Achtung: ich lasse in allen Betrachtungen diesbezueglich die Archipele auszer acht … die haben natuerlich ein grøszeres Integral weil die ja zumindest Teile des Archipels UND das grosze „Gesamtnetzwerk“ sehen, wohingegen die Seiten im Gesamtnetzwerk keine Archipelseiten sehen. Das sollte aber keinen all zu groszen Unterschied machen.

Wenn ich nun besagtes Summensignal durch das Integral unter der Kurve teile, dann erhaelt man den durchschnittlichen Anteil der Wikipediaseiten die eine Seite auf einem Linklevel NEU sieht. Wenn man das dann von einem Linklevel zum naechsten aufaddiert, so sagt dieser kumulative Anteil ganz direkt und ohne Umschweife aus, wieviel Prozent aller Wikipediaseiten im Durchschnitt bis zu dem gegebenen Linklevel gesehen wurden.

Dieser kumulative Anteil ist in der roten Kurve dargestellt und der geht natuerlich bis 100 % (mehr als alle Seiten sehen geht nicht). Fuer die (nicht gestellte) Frage des allerersten Beitrags von Interesse ist, wenn dieser kumulative Anteil 50 % ueberschreitet; wenn es also einem Muenzwurf entspricht, ob bei einer gegebenen Ursprungsseite eine andere Seite schon erreicht wurde.

An der roten Kurve kann man ablesen, dass das im Durchschnitt zwischen dem dritten und vierten Linklevel passiert. Wobei der Wert auf LL3 mit 35 % bereits recht grosz ist und meine Stichproben aus dem allerersten Beitrag …

[…] nach mehreren Versuchen [habe ich] immer drei Verbindungen (in seltenen Faellen zwei oder vier) [erhalten] …

… zu bestaetigen scheint.

Kurzer Einschub: sixdegreesofwikipedia.com benutzt die gesamte Wikipediaseite um die Wege zwischen zwei Seiten zu finden zu finden; also auch die langen Listen mit oftmals nichtmal relatierten Links die am Ende einer Wikipediaseite auftauchen. Ich hingegen schmeisze insbesondere (aber icht nur) Letztere bei meiner Analyse raus, weil mich nur die „Konversation“, also der eigentliche Text, interessiert. Das hat zur Folge, dass der kumulative Anteil „meiner“ Wikipedia ein bisschen nach rechts verschoben sein sollte, weswegen die rote Kurve auf LL3 erst 35 % hat, waehrend mir die Stichproben das Gefuehl geben, dass ich schon ueber 50 % lag.

So weit so gut. Das ist aber nur die eine Richtung; wieviele Schritte muss eine Seite im Durchschnitt machen um irgendeine andere Seite zu sehen. Im Durchschnitt sollte das auch andersrum gelten, also wieviele Schritte muessen ANDERE Seiten machen um die eine Seite zu sehen …

… aber fuer spezifische Seiten gilt das nicht zwangslaeufig. So braucht man drei Schritte um von Magdeburg nach Pencil zu gelangen, aber man schafft den Rueckweg mit nur zwei Schritten

Hier kommt nun die Linkfrequenz ins Spiel, denn diese misst auf welchen Linklevel eine gegebene Seite von anderen Seiten gesehen wird (also der „Rueckweg“ der Situation die den neuen Links entspricht). Leider schlaegt die oben erwaehnte Informationsminderung (die vonnøten war um eine derartige Grøsze ueberhaupt zu messen) hier voll zu. Die Interpretation der Daten scheint zwar einfach und „geradeaus“, aber das muss im Detail betrachtet werden, damit man auch wirklich versteht, warum das rauskommt, was rauskommt.
Weswegen ich das auf das naechste Mal verschiebe.

Auf Seite 109 in seiner Wissenschaftliche[n] Selbstbiographie schreibt Max Planck das Folgende:

[…] exact science demands more than a gift of intuition and willingness to work hard. It demands also very involved, painstaking, tedious attention to details […].

Gleich darauf folgt:

[…] when the pioneer in science sends forth the groping feelers of his thoughts, he must have a vivid intuitive imagination, for new ideas are not generated by deduction, but by an artistically creative imagination.

Und das erinnerte mich zum Ersten an den einen kleinen Balken in einem Wald von Balken der ein bisschen høher war als erwartet und wo mein Magengefuehl mir sagte, dass da was sein muss. Aber erst ein „tedious attention to details“ gekoppelt mit „a vivid intuitive imagination“ brachte die „Archipele“ zum Vorschein.
Ich wollte da zunaechst mit dem beruehmten „zehn Prozent Fehler“ drueberbuegeln und mich nicht weiter beschaeftigen … zum Glueck gewann der Wissenschaftler in mir die Oberhand.

Zum Anderen gilt das Gleiche bzgl. des (damals so bezeichneten) São Paulo FC-Artefakts. Dieses war letztlich nur der Anfang fuer meine (sicher oftmals) ermuedende Aufmerksamkeit fuer Details und befeuerte (spaeter) meine Fantasie welche dann die „Familien“ sichtbar machte.

Das sind nur die zwei grøszten (mglw. gar besten) Beispiele. Insgesamt sind diese beiden Mechanismen bei so ziemlich allen Sachen, die ich innerhalb der Kevin Bacon Maxiserie behandel(t)e (aber nicht nur da), am Werk gewesen. Natuerlich in unterschiedlicher Auspraegung und ich vermute (befuerchte), dass (leider?) die Detail“verliebtheit“ viel haeufiger in den Beitraegen auftritt als die Phantasie.

Bei den linklevelabhaengigen Verteilungen der totalen Links hatten wir einen Fall, bei dem die „integrierten log-log-Plots“ nicht so „funktioniert“ haben wie ich das bei allen anderen Beispielen gesehen habe. Aber das war erwartet, weil schon bei den urspruenglichen Untersuchungen nix rum kam. Im Allgemeinen konnte man sehen, dass dieser Ansatz zu mehr oder weniger guten Geraden fuehrt und (mit sinnvollen Abstrichen) haut das schon ganz gut hin.

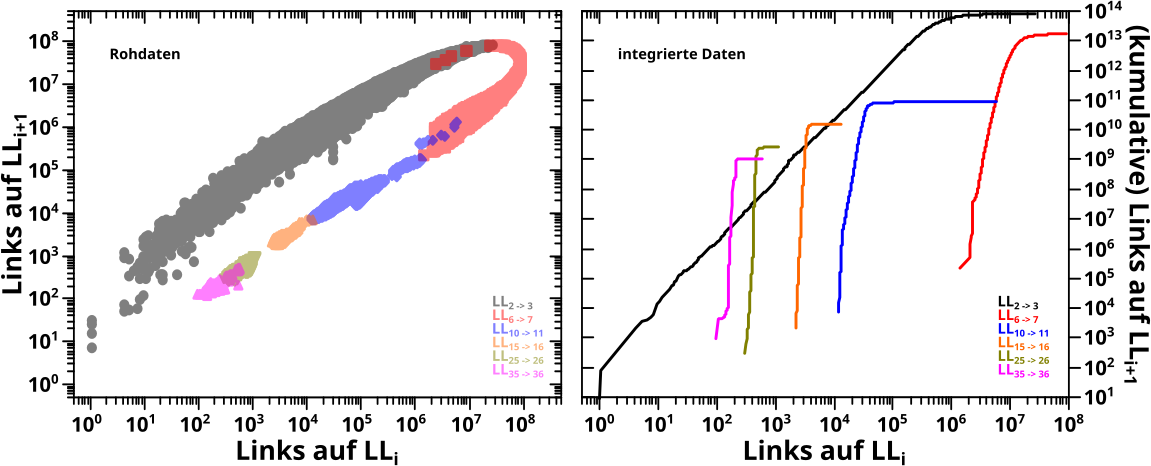
Ein unerwartetes, im Wesentlichen nichts hergebendes Ergebniss erhaelt man mit dieser Methode, wenn man sich die Links auf LLi+1 in Abhaengigkeit von den Links auf LLi anschaut:

Im linken Diagramm sind, wieder in blassen Farben, die urspruenglichen (Roh)Daten und die wichtige (und ueberraschende) Information war hier, dass diese einen „Orbit“ beschreiben … DAS sieht man nun ueberhaupt nicht bei den integrierten Daten im rechten Diagramm.
Zunaechst kønnte man das ja mglw. darauf schieben, dass ja NUR die Ordinate integriert ist, aber mglw. muesste man das auch fuer die Abzsisse machen. Da tritt man dann zwar in ein „konzeptuelles Wespennest“, aber das hat mich nicht davon abgehalten mich damit mal ein paar Stunden zu beschaeftigen … das Resultat: das ist zwar anders als im rechten Diagramm, ist diesem aber aehnlich und hat auch keinen „Orbit“ zur Folge.
Auf den ersten Blick sieht es auch so aus, dass man hier nicht mal die Anstiege aus den Integralen richtig raus bekommt (aus dem Bereich vor den jeweiligen Plateaus). Wobei das aber hier bei den (totalen) Links vermutlich letztlich auch wieder nur daraus folgt, was ich zum ganz zuerst verlinkten Thema schrieb … das gehørt schlieszlich zusammen.

Interessant ist, dass das was ich hier im rechten Diagramm zeige, (mit Abstrichen) bei den Selbstzitierungen funktioniert. Das war so wenig ueberraschend, dass ich dazu beim letzten Mal nicht mal ein Bild zeigte und das in drei Saetzen schnell abhandelte.
Wenn man mal drueber nachdenkt, dann ist das aber nicht weiter verwunderlich, denn die Selbstreferenzen sind nicht von sich selber, sondern von der Anzahl der (totalen) Links abhaengig. Bei Selbigen hingegen ist die Anzahl direkt von sich selbst abhaengig … ach das ist alles kompliziert und vermutlich hat das auch gar nix miteinander zu tun … was einer der Gruende ist, warum ich das oben als „konzeptuelles Wespennest“ darstelle … jemand der schlauer ist als ich, kann das mathematisch sicherlich alles herleiten, ich will mir aber darueber nicht weiter den Kopf zerbrechen

Lange Rede kurzer Sinn: hier bringt der „Integralansatz“ nix.

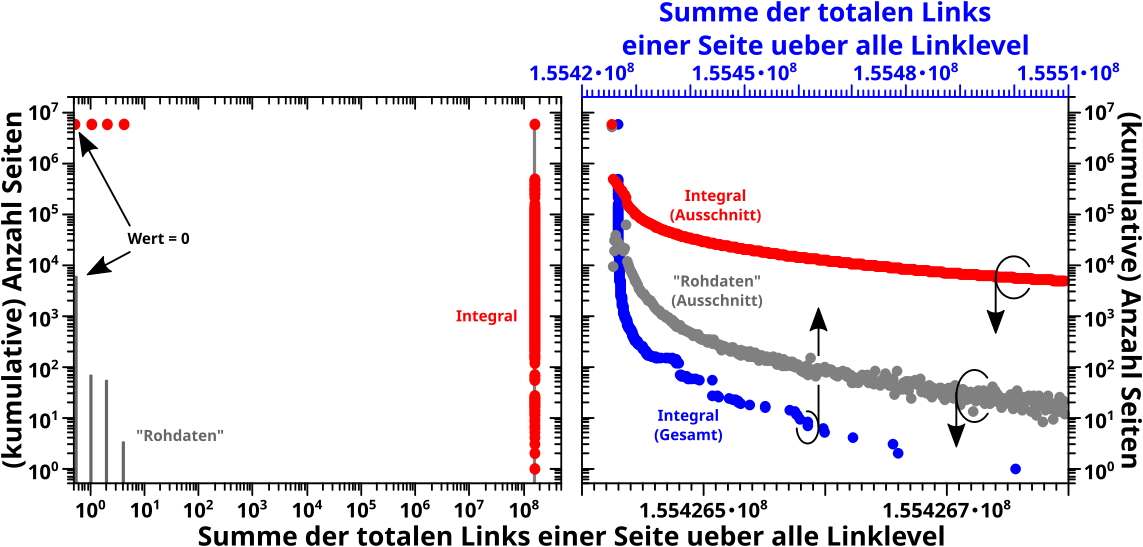
Dann war da noch die Summe der totalen Links einer Seite ueber alle Linklevel:

Achtung: im rechten Diagramm ist die untere Abzsisse fuer die grauen und roten Daten und zeigt nur einen Ausschnitt der gesamten (integrierten) Daten (blaue Punkte). Fuer Letztere gilt die obere, blaue Abzsisse.
Und JA, auch im rechten Diagramm sind die Abzsissen logarithmisch. Hier draengt sich aber alles so sehr zusammen, dass das irrelevant ist.

Ich muss hier nicht viele weitere Worte drueber verlieren, denn es ist ziemlich eindeutig, dass hier auch mit dem „Integralansatz“ nix zu holen ist. Das gilt auch dann, wenn man die Grenzen des Integrals invertiert oder die ersten vier (dominierenden) Datenpunkte weg laeszt bei den Betrachtungen (ich hab’s naemlich versucht).

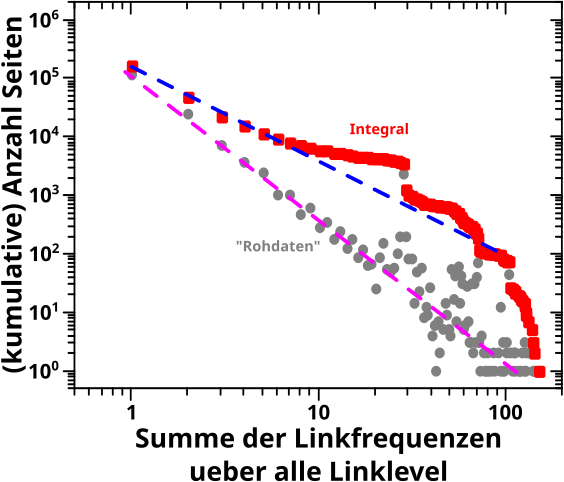
Als naechstes war da die Summe der Linkfrequenzen ueber alle Linklevel, von dem nur der „Archipelteil“ interessant war:

Das sieht ja erstmal knorke aus, ABER hier muss man vorsichtig sein … der Reihe nach.

Die gestrichelten Geraden sind wieder von Hand reingelegt und die Anstiege sind ca. 2.25 fuer die Rohdaten und ca. 1.125 fuer die integrierten Daten. Das haut also ganz gut hin.
Aufgrund von Diskrepanzen zwischen realen Daten und reiner Mathematik fallen die integrierten Daten bei Summenwerten von ueber 100 so stark ab. Wie schon vormals (nicht im Detail) diskutiert, liesze sich das „reparieren“ und dann liegen die auch auf der (gestrichelten, blauen) Gerade. Das ist also nur ein kleinerer Grund fuer die Vorsicht
Wichtiger ist, dass die „Huegel“ in den Rohdaten (auf der Abzsisse bei Werten von ca. 25 und 50) zu deutlichen Abweichungen von der Regressionsgeraden im integrierten Signal fuehren. Auch vormals gab es Abweichungen von der Geraden, aber waren das dann „glatte“ Kurven mit mehr oder weniger starker Kruemmung und ich meinte dann, dass man die Abweichungen parametrisieren (a.k.a. wegdiskutieren“ kønnte).

Lange Rede kurzer Sinn: der „Integralansatz“ ist zwar durchaus … ich sag jetzt mal: erfolgreich. Aber wenn man das genau macht, dann darf man bei solchen Faellen die (abrupten und signifikaten) Abweichungen vom Erwartungsbild nicht einfach in einen „Parameter“ packen, sondern muss das ordentlich betrachten und diskutieren … was ich hier nicht mache, weil ich keine Lust mehr habe.

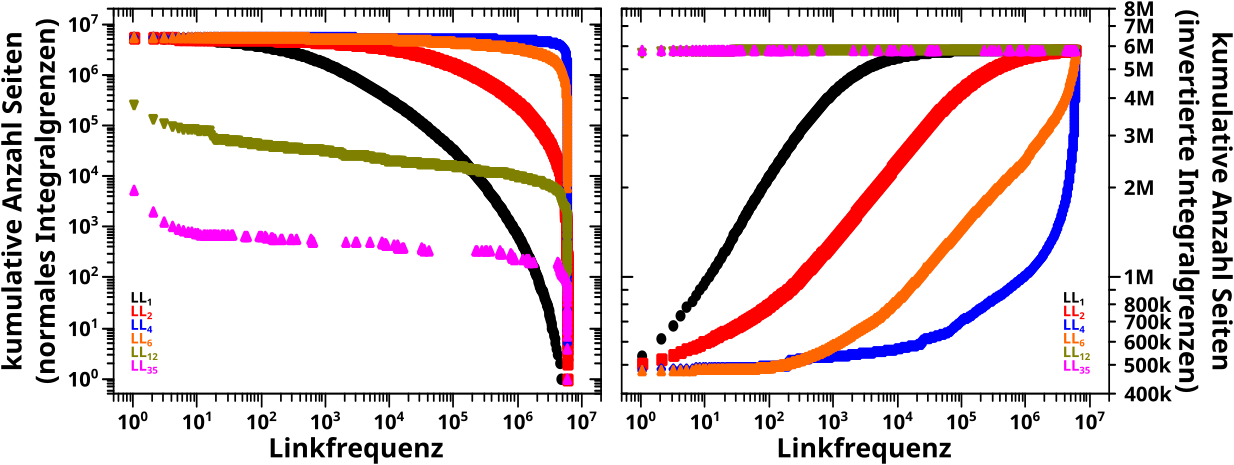
Als Letztes dann noch ein paar Beispiele fuer die linklevelabhaengigen Histogramme bzgl. der Linkfrequenz pro Seite:

Zu meiner Ueberraschung ist hier (auf den ersten Blick) nuescht linear; weder bei normalen (linkes Diagramm) noch bei invertierten Grenzen (rechtes Diagramm) des Integrals.
Naja, bei invertierten Integralgrenzen gibt es zumindest fuer die ersten paar Linklevel mglw. lineare Teilbereiche, aber viel ist da nicht „zu holen“.
Auszerdem ist die Dynamik  im rechten Diagramm echt klein; die zugehørige Ordinate geht gerade mal ueber ein bisschen mehr als eine Grøszenordnung.
Lange Rede kurzer Sinn: der „Integralansatz“ kann hier vllt. ein paar Resultate liefern, die kønnen aber nicht auf den ganzen Datensatz verallgemeinert werden.

So, das soll genug sein fuer heute und mit dem „Integralansatz“. … … … Da hat es die letzten zwei Beitraege dann doch noch geklappt mit den …

[…] Artikel mit Bildern und (meist) nicht ganz so viel Text […]

… naja, fast … viel Text ist’s immer noch, aber ich handle ja doch recht viel ab in nur zwei Artikeln; relativ gesehen ist‘ also wenig Text … tihihi.

Ich bin ueber den „Integralansatz“ erst im Laufe der Maxiserie gestolpert und habe mir das erst jetzt zum Ende alles nochmal damit angeschaut. Es ist beruhigend, dass ich damit hauptsaechlich meine vorherigen Ergebnisse bestaetige (und ein paar neue Erkentnisse erhalte). Aber wie mehrfach erwaehnt, wollte ich nicht alles nochmal im Detail machen. Ich habe naemlich wirklich keine Lust mehr und freue mich darauf, diese Maxiserie nach fast drei Jahren abzuschlieszen.
Aber keine Sorge, Letzteres passiert noch nicht heute, denn ich møchte nochmal auf alles zurueck schauen und das wird dann mindestens noch ein (vllt. zwei) Artikel.

Da ich viele Phaenomene schon ausfuehrlich diskutiert habe, kann ich heute ein paar Sachen zu den Selbstzitierungen kurz abhandeln.

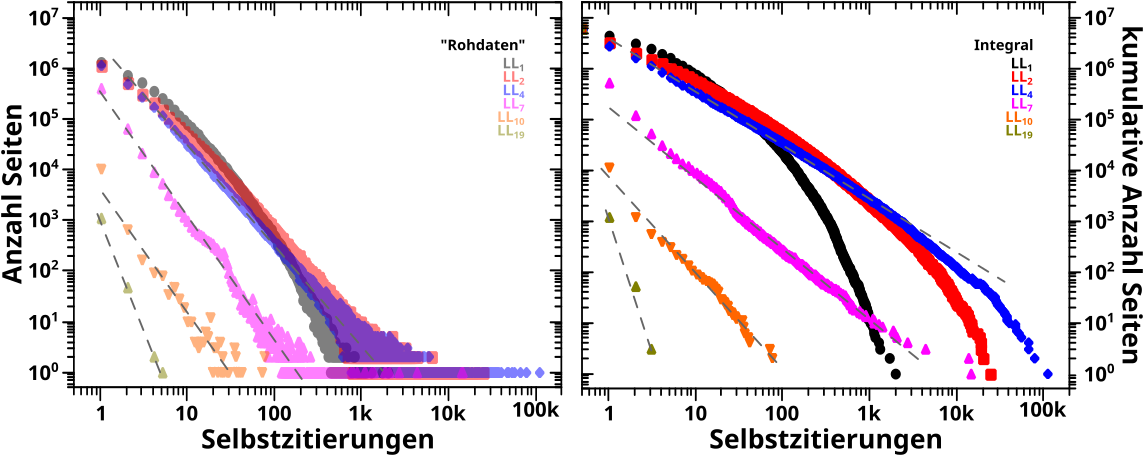
Auch wenn es vorher schon los ging, so ist hier erst dieser vorherige Beitrag relevant, in dem ich linklevelabhaengige doppellogarithmischen Histogramme systematisch zeigte. Das muss ich nicht nochmal im Detail wiederholen und zeige in diesem Diagramm …

… nur ein paar repraesentative (integrierte) Histogramme. Links (mit den blassen Farben) zur Wiederholung die „Rohdaten“ und rechts die integrierten Daten.

Eigentlich gibt’s hier nichts weiter zu sagen, denn wieder bestaetigen die integrierten Daten die vormaligen Resultate mit høherer Genauigkeit.
Ich hatte damals besprochen, dass bei den ersten Linkleveln der lineare Zusammenhang nicht all zu gut ist; hier sieht man, dass es gut genug ist mindestens ab LL4.
Ich habe die Anstiege nicht nochmal „vermessen“ (was ja vormals zu diesem ganz wunderbaren Resultat fuehrte), aber das sieht schon richtig aus und am wichtigsten ist ohnehin, dass die Anstiege mit zunehmendem Linklevel auch hier steiler werden.
Als Letztes ist noch zu sagen, dass man auch mittels Integralen nix machen kann, wenn da nix ist. Siehe die Daten zu LL19.

Danach hatte ich den Startpunkt fuer die Simulation mit den realen Daten verglichen. Das war damals sehr gut und ist auch bei den Integralen sehr gut. Ich habe da zwar ein Diagramm, aber der Informationsinhalt ist so trivial, dass ich das nicht nochmal zeigen muss.

Aehnlich schnell und ohne Diagramm kann ich abhandeln, wie die integrierten Daten der durchschnittlichen Anzahl der Selbstzitierungen auf LLi+1 in Abhaengigkeit von LLi aussehen. Wieder bestaetigen die integrierten Daten vorherige Resultate. Es liegt aber die gleiche Situation wie bei den durchschnittlichen Links pro Zitat vor. Deswegen muss ich das nicht nochmal im Detail besprechen und das zugehørige Diagramm ist auch nicht so spannend.

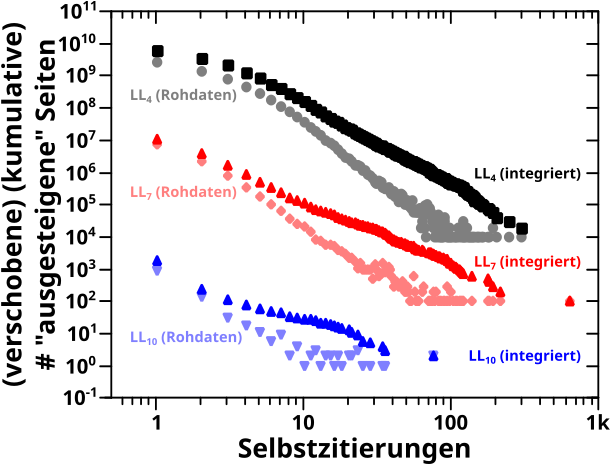
Als Letztes zu den Selbstreferenzen noch drei repraesentative Beispiele bzgl. der Seiten die von einem Linklevel zum naechsten „aussteigen“ aus der „Selbstreferenzkette“:

Die Daten sind gegeneinander verschoben und die „Rohdaten“ sind die Punkte mit den blassen Farben. Da man nur Phaenomene die bereits mehrfach besprochen wurden sieht, habe ich mir nicht mal mehr die Muehe gemacht „Regressionsgeraden“ von Hand rein zu legen … ich wollte das schlieszlich nicht alles nochmal machen, sondern nur gucken, was eine Integration zur Folge hat und das hier sieht alles gut und wie erwartet aus.

Das ging ja ausnahmsweise _wirklich_ mal schnell heute … fetzt ja.
Beim naechsten Mal schliesze ich die log-log-Plots ab und zeige ein paar Beispiele, bei denen eine Integration der falsche, oder zumindest ein nicht nuetzlicher Ansatz ist.

OIOIOI! Was fuer ein tolles Weihnachtsgeschenk, denn das hier heute ist sooo geil! Der Integralansatz hat naemlich bei der Verteilung der Grøsze der Archipele zu mehreren neuen Erkentnissen gefuehrt. Aber der Reihe nach.

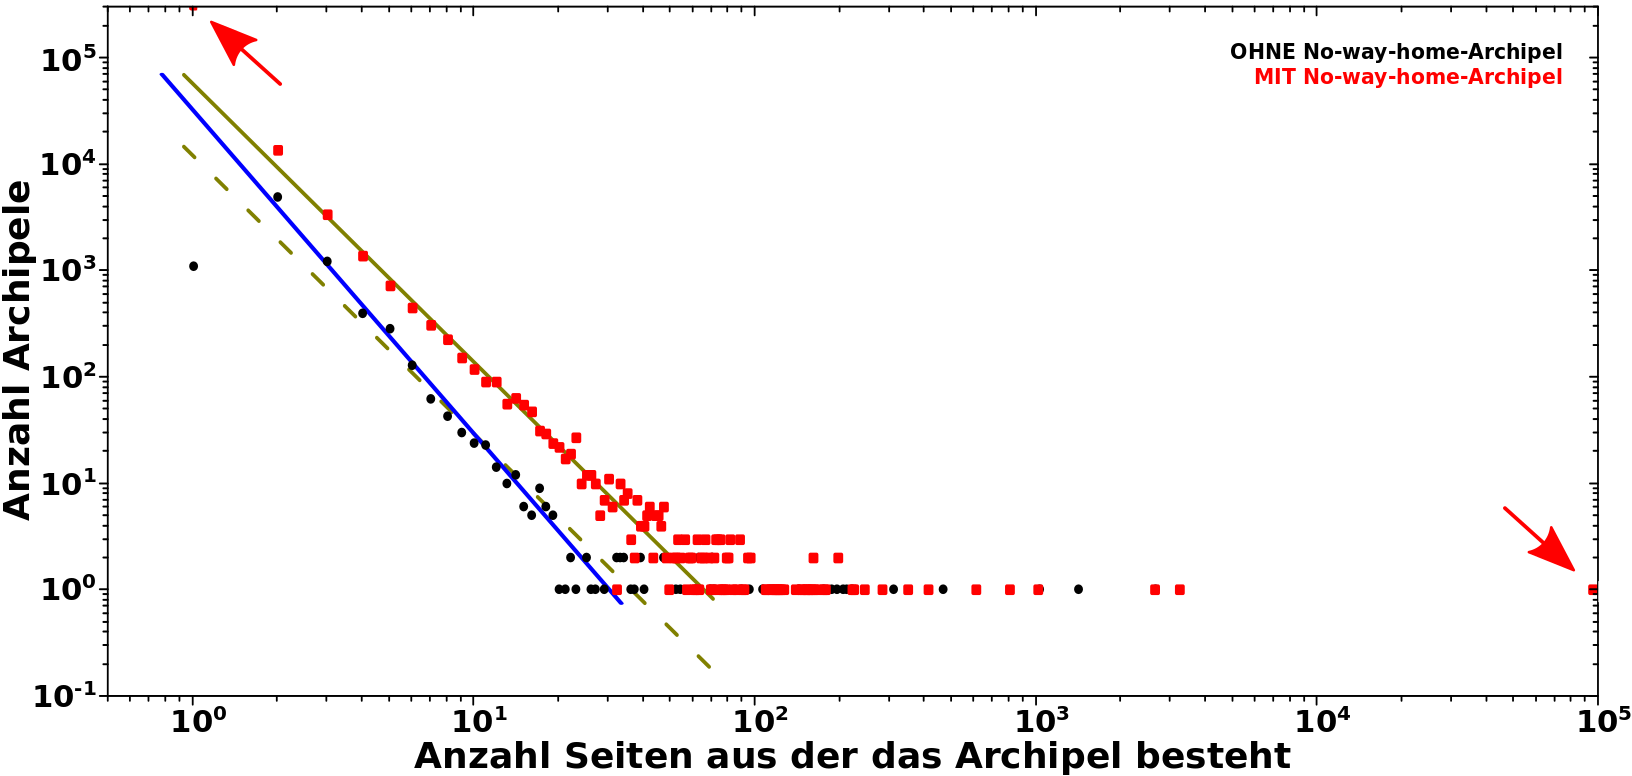
Zur Erinnerung nochmal das Diagramm von damals:
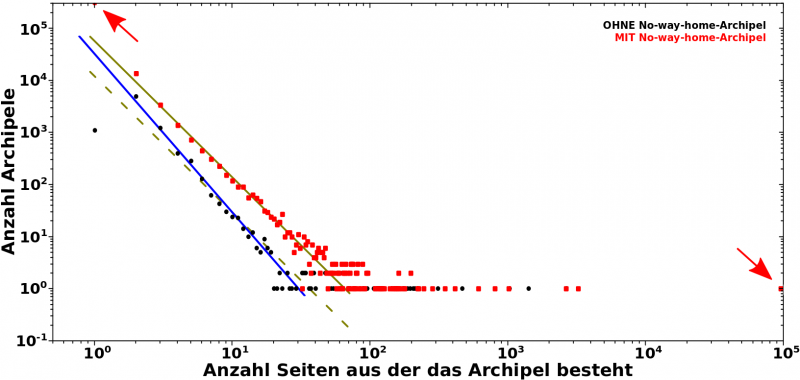
Das sind erstmal wieder „nur“ zwei „Histogramme mit Schwanz“. Damals unterschied ich zwischen der Verteilung bei der das No-way-home-Archipel (in kurz: nwhA) auszen vor gelassen wurde (schwarze Punkte) und der wo das mit drin war. Achtung: auch wenn ich hier die Einzahl benutze, so besteht das nwhA eigtl. aus mehreren No-way-home-ArchipelEN; inklusive mehreren zehntausend einzelnen Seiten.
Ich berechnte nie die Anstiege (der von Hand hereingelegten Linien), aber fuer die schwarzen Punkte (blaue Linie) ist selbiger ungefaehr -3.3 und fuer die roten Punkte (Linie in oliv) ca. -2.5. Das ist ein deutlicher Unterschied, aber aufgrund der Datenlage wollte ich nicht aussschlieszen, dass die linearen Bereiche der beiden Histogramme den gleichen (wenn nicht gar den selben) Anstieg haben — siehe die (parallel verschobene) gestrichelte Linie in oliv, welche die schwarzen Punkte nicht unbedingt viel schlechter beschreibt.

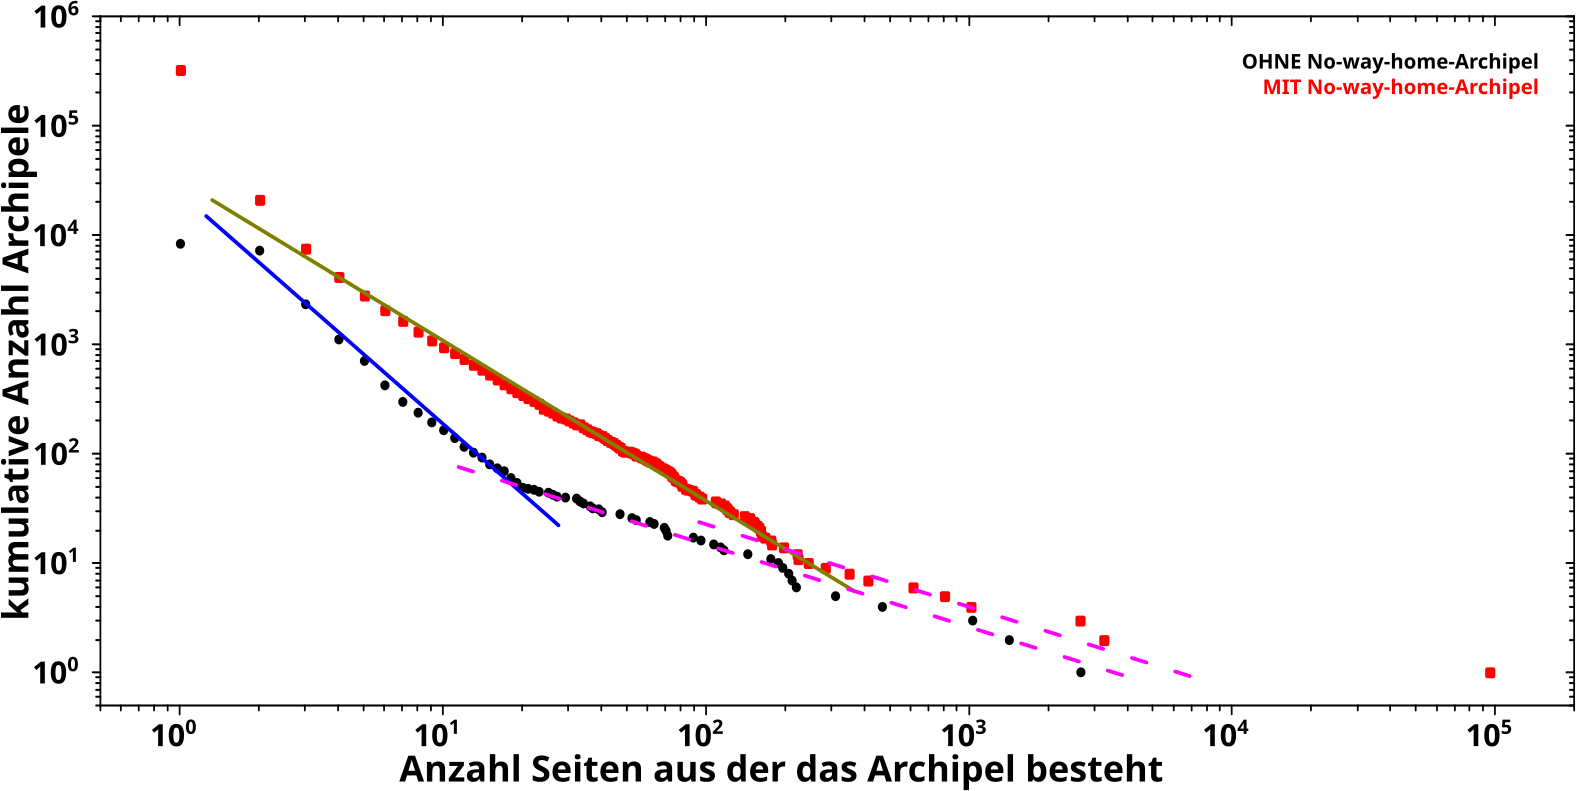
Die integrierten Daten (normale Integralgrenzen) sehen nun so aus:
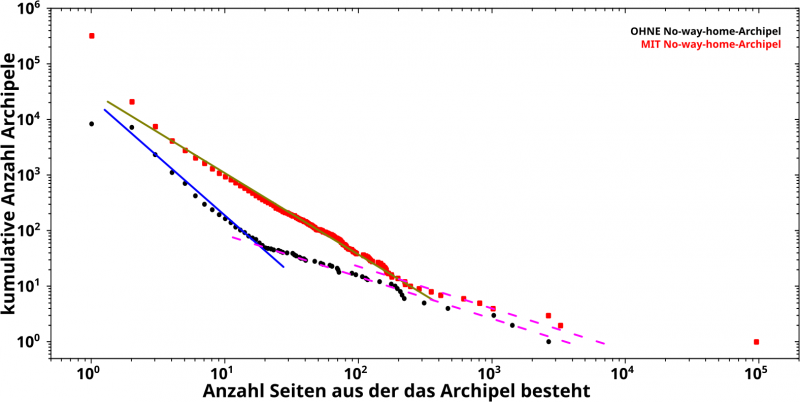
OIOIOIOIOI! Das fetzt ja! Denn auf einmal treten mehrere Sachen deutlich hervor.

Zum Ersten sieht man, dass die Histogramme aus ZWEI Abschnitten mit unterschiedlichen Anstiegen bestehen. Diese Information war im obigen Diagramm komplett im „Zappelschwanz“ versteckt. Toll wa!
Ich bezeichne den (jeweiligen) linken Abschnitt als „normale“ Archipele und den (jeweiligen) rechten Abschnitt als „grosze“ Archipele.

Zum Zweiten sind besagte Abschnitte ganz klar mittels vier Geraden (in doppellogarithmischer Darstellung) zu beschreiben. Aber Achtung: die zwei Geraden der jeweils ersten Abschnitte (die blaue und olive Linie) haben unterschiedliche Anstiege waehrend die der jeweils zweiten Abschnitte hingegen den gleichen Anstieg haben (die lila, gestrichelten Linien) … nun ja, innerhalb des Fehlers interpretiere ich das als den gleichen Anstieg; mathematisch betraegt der Unterschied aber nur ca. 0.1 und das habe ich bei allen vorhergehenden Untersuchungen immer als „das ist schon irgendwie das Gleiche“ durchgehen lassen.
Wieauchimmer, da faellt (fast) nix aus der Reihe mit einer Kruemmung oder groszen „Ausreiszern“

Aus diesen Beiden folgt das Dritte: die Seiten die die Daten der ersten Abschnitte ausmachen unterliegen jeweils anderen Potenzgesetzen, waehrend fuer die groszen Archipele der zweiten Abschnitte nur EIN Potenzgesetz gilt. Das ist nicht ungewøhnlich, dass fuer Daten-am-Ende-und-irgendwie-weit-auszerhalb-der-normalen-Verteilung andere Gesetze gelten und das tritt (relativ) haeufig auf; kurioserweise gelten (in anderen Zusammenhaengen) fuer solche Daten oft maechtige Gesetze waehrend das oft nicht den Rest (und Groszteil) der Messungen beschreiben.
Wieauchimmer, vom Bezuhgsrahmen ist abhaengig wann „grosze Archipele“ beginnen.

Viertens folgt aus dem kleineren Anstieg der zweiten Abschnitte, dass es deutlich mehr grosze Archipele gibt als es geben sollte im Vergleich mit den normalen Archipelen; das untermauert die Vermutung eines anderen Mechanismus fuer grosze Archipele.
Ich denke NICHT, dass diese Aussage (eines anderen zugrundeliegenden Mechanismus) fuer die ersten Abschnitte gilt, obwohl diese auch unterschiedliche Anstiege haben. Weiter unten erklaere ich warum.

Diese vier Sachen sind so fetzig, weil das ueberhaupt nicht ersichtlich ist im urspruenglichen Diagramm.

Fuenftens stimmen die Anstiege der Geraden der ersten Abschnitte mit -2.5 fuer die schwarzen Punkte (blaue Linie) bzw. -1,6 fuer die roten Punkte (Linie in oliv) „mathematisch (fast) perfekt“ mit den frueheren Ergebnissen ueberein. Dadurch werden diese (wieder mal) untermauert, aber (wieder mal) mit grøszerer „Sicherheit“.

Das wiederum fuehrt zu Sechstens: der obige erwaehnte Unterschied im Anstieg der beiden Verteilungen ist echt. Hier kann man das nicht mehr mit „innerhalb des Fehlers kønnte das auch gleich sein“ wegdiskutieren. Wenn man das No-way-home-Archipel auszen vor laeszt scheint ein anderer Mechanismus am wirken zu sein … zumindest war das meine erste Vermutung. Die bereitete mir aber aber „Bauchschmerzen“ denn auch wenn ich das fuer „grosze Archipele“ akzeptieren konnte (s.o.) so sind die schwarzen Punkte ja bei den roten Daten mit drin und ich konnte mir nicht erklaeren warum Seiten (in Archipelen) auszerhalb des nwhA sich anders verhalten sollten als wenn ich alles zusammen betrachte.

Diese Unstimmigkeit liesz mich (wieder einmal) nicht los und ich gruebelte (wieder einmal) tagelang darueber nach, wie das erklaert werden kønnte. Ich muss ganz ehrlich sagen, dass ich stolz auf mich bin, dass ich eine møgliche Erklaerung fand.
In kurz: das Phaenomen der Archipele kann _nur_ in seiner Ganzheit betrachten werden und sollte NICHT in das nwhA und Archipele auszerhalb desselbigen unterteilt werden.

Aber der Reihe nach und zunaecht muss man sich erinnern, dass ich („historisch“ gesehen) zuallererst das nwhA gefunden habe. Das reichte aber nicht aus um die damals untersuchte Diskrepanz zu erklaeren und ich stellte weitere Ueberlegungen an, bei denen ich das nwhA zunaechst auszen vor liesz und erst am Ende wieder alles verknuepfte. Die schwarzen Daten oben sind nun die Daten bei denen das nwhA NICHT mit dabei ist und die roten Punkte bei denen alles verknuepft ist.
Ich erwaehnte damals, dass das nwhA viele Verbindungen mit Archipelen hat welche in besagten (hier) „schwarzen Daten“ dargestellt sind; aber das sieht man NUR, wenn man wieder alles verknuepft.
Das muss man im Hinterkopf behalten bei den folgenden Erklaerungen, aber bevor ich zu denen komme, muss ich noch auf etwas anderes hinweisen.

Fuer die folgenden Ueberlegungen gilt, dass mich NUR der Anstieg und NICHT die „Amplitude“ der Kurven interessiert. Oder anders: die schwarzen Daten gehen schneller nach unten, aufgrund besagten (staerkeren) Anstiegs und das interessiert mich. Gleichzeitig sind sie auch nach unten „verschoben“ einfach weil die Anzahl der Archipele die in den roten Daten enthalten sind viel grøszer ist als die Anzahl der Archipele welche die schwarze Daten ausmachen. Diese absolute Verschiebung interessiert mich NICHT und fuer das was ich hierunter schreibe, nehme ich an, dass die „Amplituden“ gleich grosz sind.
Auszerdem rede ich im folgenden immer nur ueber die ersten Abschnitte in den obigen (integrierten) Daten.

Die schwarzen Daten unterliegen einem Potzengesetz welches schneller abfaellt als das Potenzgesetz welches die roten Daten beschreibt. Wenn besagte Gesetze nun in der Wahrscheinlichkeitsinterpretation betrachtet werden (mit dem was ich eben schrieb bedeutet dies Aussage, dass man sich denken soll, dass beide Verteilungen insgesamt gleich viele Archipele enthalten), dann heiszt das, dass die Wahrscheinlichkeit fuer ein „schwarzes Archipel“ der Grøsze 4 so grosz ist wie ein „rotes Archipel“ der Grøsze 6. Oder ein „schwarzes Archipel“ der Grøsze 10 ist so wahrscheinlich wie ein „rotes Archipel“ der Grøsze 18. Man sieht das, wenn man einfach zwei gleiche Funktionswert fuer die schwarzen bzw. roten Daten anschaut und vergleicht welche Archipelgrøszen dazu gehøren.
Oder anders: die blaue Linie ist von der roten Linie gesehen nach links „verschoben“ … aber nicht parallel verschoben (denn dann waeren die Anstiege ja gleich), sondern abhaengig vom Wert der Archipelgrøsze unterschiedlich, mit zunehmenden Unterschied je grøszer das Archipel … das ist also eher eine Rotation nach links, wobei die Kurve beim Archipelgrøszenwert zwei festgehalten wird (das ist also der „Drehpunkt“).

Ich schreibe das hier auf, als ob das das natuerlichste von der Welt waere. Ich brauchte aber eine ganze Weile bevor ich da drauf gekommen bin und verfolgte ein paar „Sackgassen“ bevor ich diesen Durchbruch hatte.
Und wenn man mal drueber nachdenkt, dann ist das schon erstmal komisch; warum sollte die Verschiebung vom Wert auf der Abszisse abhaengen. Ich komme darauf zurueck, aber um zu verstehen warum das sinnvoll ist, muessen wir wieder zu den Archipelen und den Seiten aus denen diese bestehen zurueck kommen.

Zunaechst das nwhA und davon sind fuer das zugrundeliegende Prinzip das ich beschreiben will nur die …

[…] „Einwohner“ der (isolierten) „Insel der […] Unzitierten“ […]

… von Interesse; also nur die Seiten, welche nach „drauszen“ zitieren aber nicht zitiert werden. Dieser Satz nach dem Semikolon ist wichtiger als er aussieht, denn diese Seiten zitieren auch zu den nicht-nwhA-Archipelen. Den Prozess „sehe“ ich aber nicht in den „schwarzen Daten“, denn selbige habe ich dadurch erhalte, indem ich die Seiten aus denen das nwhA besteht auszen vor gelassen habe. Oder anders: „Einwohner“ der „Insel der Unzitierten“ sind sowas aehnliches wie die „Anhaenger“ im Zusammenhang mit „Kettenseiten“, nur dass der „Zitierpfeil“ andersrum ist.
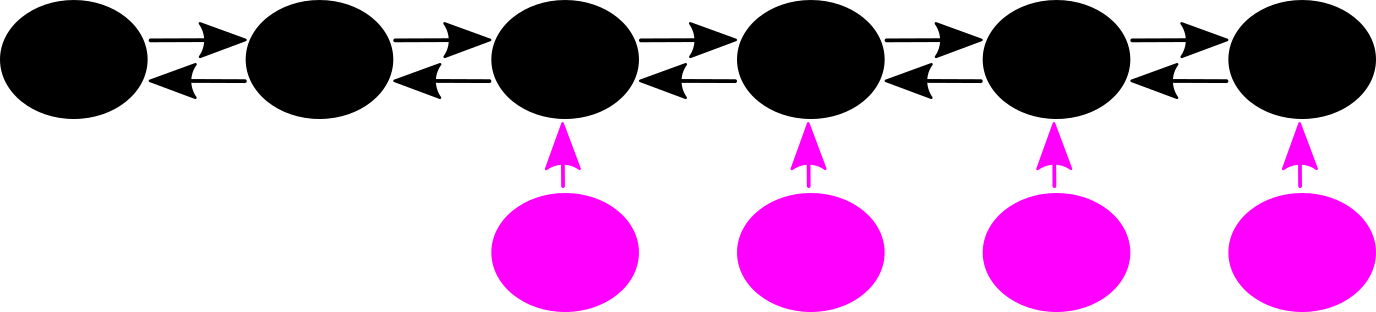
Ein Bild sagt oft (aber nicht immer) meht als 1000 Worte:
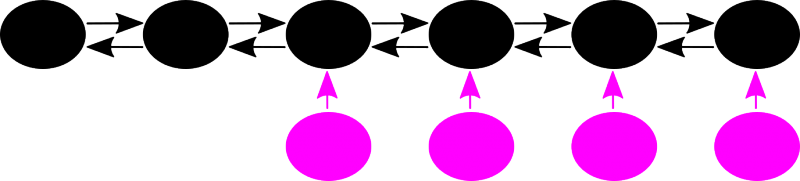
Schwarze Kugeln mit Doppelpfeilen gehøren zu einem NICHT-nwhA-Archipel, die lila Kugeln mit einem Pfeil hin zu Ersterem sind „Einwohner“ der „Insel der Unzitierten“.
Was wir hier sehen ist das was ich oben schrieb und was in den roten Daten ausgedrueckt ist: man darf nur alles zusammen betrachten. Die „schwarzen Daten“ sind Teil eines grøszeren Verbunds (die „roten Daten“), aber dieser Verbund ist „abgeschnitten“ wenn die Grøsze der Archipele bei den „schwarzen Daten“ bestimmt wurde.
Oder anders: wenn ein NICHT-nwhA-Archipel die Grøsze 6 hat, so ist dem nur scheinbar (!) so, denn eigentlich „kleben“ an vier Seiten dieses Archipels noch jeweils ein „Einwohner“ der „Insel der Unzitierten“ dran und die eigentliche Grøsze des gesamten Archipels ist 10.
Die ersten beiden schwarzen Punkte haben kein „Anhaengsel“, denn die sind ja der „Drehpunkt“.

TADA! Das ist die Erklaerung dafuer, warum die „schwarzen Daten“ KEINEM anderen Mechanismus unterliegen als die „roten Daten“ (denn das waere nicht sinnvoll), warum die aber dennoch durch ein anderes Potenzgesetz beschrieben werden.
Der Unterschied zwischen einem Anstieg von -2.6 und -3.3 wird genuegend gut durch (etwas-mehr-als)-eine-gruene-Kugel-pro-schwarzer-Kugel beschrieben. Das habe ich durchgerechnet. In Wahrheit ist das natuerlich oft komplizierter, wenn mal zwei (oder auch mal keine) Exraseite an eine schwarze Kugel „angeklebt“ wird.  ABER die „Insel der Unzitierten“ besteht aus ca. 320k „Einwohnern“ und dominiert das nwhA zu 90 Prozent. Solche komplizierteren Gegebenheiten kønnen in diesem einfachen Bild also ohne Beschraenkung der Allgemeinheit (oder so … ich habe das jetzt bestimmt nicht richtig gebraucht) auszen vor gelassen werden.

Gibt’s einen „Beweis“ dafuer?
Nun ja, keinen Beweis, denn dafuer muesste ich nachverfolgen, welche Seite wo „dranklebt“. Aber meiner Meinung nach starke Indizien, welche obiges Modell unterstuetzen.
Zum Einen verweise ich wieder auf die „Anhaenger“ bei den Kettenseiten. Einzelne Seiten die einfach an ’nem ausgedehnteren Konstrukt „dranhaengen“ sind ein bereits etabliertes Phaenomen.
Zum Zweiten sieht man es zwar nicht im Diagramm (wg. der logarithmischen Komprimierung), aber es „fehlen“ bei den „roten Daten“ bei der Archipelgrøsze 1 ca. 22-tausend Archipele. Das sind keine 320k (plus 1k aus den „schwarzen Daten“) sondern nur 299-tausend Archipele an der Stelle.
Zugleich sind es nur ca. 15-tausend Seiten die sich auf allen NICHT-nwhA-Archipelen „tummeln“ … das kønnte einem so vorkommen, als ob sich …

[…] (etwas-mehr-als)-eine-gruene-Kugel-pro-schwarzer-Kugel […]

… an diese ca. 15-tausend Seiten „ranklebt“. Fetzt wa!

Fuer diese zugrundeliegende „atomistische“ Erklaerung kann man in der Natur Beispiele finden (ich nenne mal nur Kohlenwasserstoffe) und deswegen klingt das Modell fuer mich durchaus plausibel. und ich hoffe, das war alles halbwegs verstaendlich erklaert.
Wie gesagt, bin ich voll stolz auf mich (und freu mich auch sehr dolle), dass ich das rausgefunden habe.

Ach so, das erklaert auch, warum der „Knick“ zu „groszen Archipelen“ bei den schwarzen Daten viel eher kommt als bei den roten Daten; die Archipele sind im eigentlich Verbund schon viel grøszer und damit in einem Bereich der wirklich einem anderen Mechanismus unterliegt.

Nochmal ach so: die „schwarzen Daten“ gibt es nur deshalb, wie ich das ganze urspruengliche Thema nach und nach „explorativ“ bearbeitet habe und nach und nach verschiedene Dinge entdeckte. In der Wissenschaft erzaehlt man dann am Ende alles halb „rueckwaerts“ und laeszt diese vorantastenden Schritte des langsamen Verstehens weg. Dadurch wird alles kuerzer und logischer und ergibt ein konsistentes Bild. Das ist aber nicht der Prozess des Forschens, den ich in dieser Maxiserie ja (mit Absicht) explizit darstelle.

Wieauchimmer, der Integralansatz ist hier sehr fruchtbar und das Alles sollte weiter untersucht werden … aber nicht von mir.

Das soll genug sein fuer heute. Mal schauen, was es naechstes Mal wird und ich wuensche erholsame Feiertage :)
Hier schaute ich mir zum ersten Mal linklevelabhaengige Verteilungen einer Grøsze (in dem Fall der totalen Links) an. Ich gehe hier nicht weiter drauf ein, denn auch wenn ich da viel zu schrieb, kam am Ende nicht viel bei rum (auszer, dass das „São Paulo Artefakt“ dadurch mehr Aufmerksamkeit erhielt … aber „entdeckt“ wurde dieses schon eher).

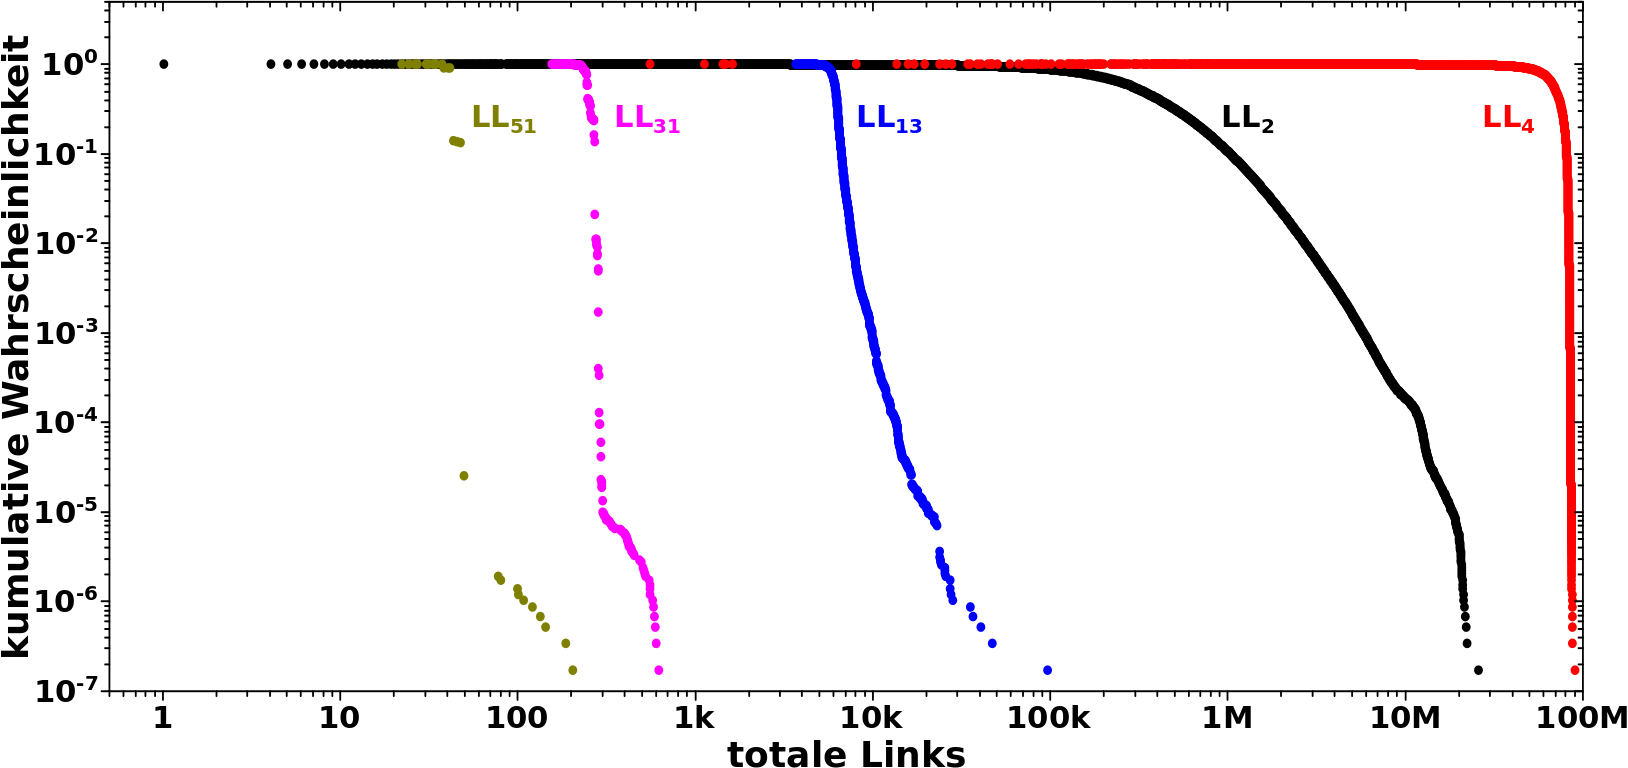
Wieauchimmer, bei diesen vielen Histogrammen kam damals schon nix bei rum und wenn ich das als Integral betrachte …

… dann aendert sich daran wenig (Achtung: die Ordinate ist hier kein Zaehler fuer absolute Zahlen, sondern als kumulative Wahrscheinlichkeit (mit normalen Integralgrenzen) dargestellt).
Die fuenf Beispiele sind repraesentativ und selbst wenn man in den „Uebergang“ rein zoomt sieht man nix Spannendes.

Weil bei den neuen Links pro Linklevel im Wesentlichen die gleiche Situation vorliegt, schaue ich mir die dazugehørigen Verteilungen nicht nochmal als Integral an. Waere ja albern, denn das habe ich damals beim ersten „Durchgang“ auch nicht gemacht.

Und das soll’s fuer heute schon gewesen sein … ausnahmsweise ging’s schnell.

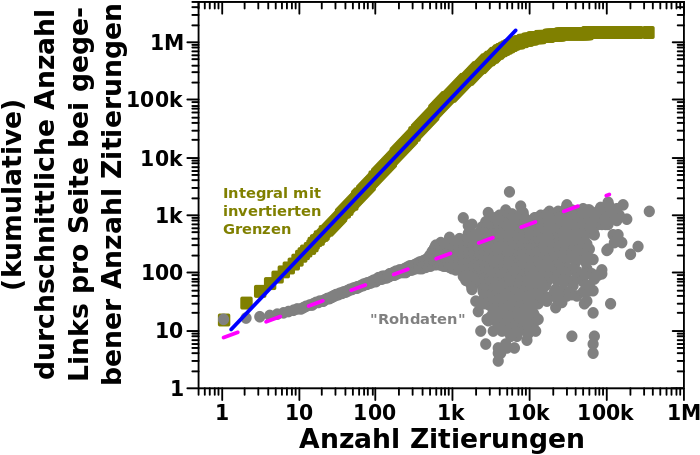
Hier schaute ich zum mir ersten Mal die Abhaengigkeit der Links einer Seite von der Anzahl der Zitate die diese erhaelt an. Es war ein „Blob“. Dann berechnete ich die durchschnittliche Anzahl an Links ueber alle Seiten die eine gegebene Anzahl an Zitaten erhalten hatten und der Blob verschwand und ich erhielt das erste wahrhaft ueberraschende Ergebniss in dieser Maxiserie: der Zusammenhang folgt auch einem maechtigen Gesetz. Besagtes Ergebnis ist in diesem Diagramm nochmals in grau wiedergegeben …

… und die (von Hand reingelegte) Regressionsgerade (lila, nicht durchgehende Linie) fuehrt zu einem Exponenten von +0.5.

Weil es „aufwaerts“ geht, muessen die Grenzen fuer das Integral invertiert werden um etwas Vernuenftiges zu erhalten (wie beim vorletzten Mal gezeigt) und besagtes Integral sind die Rechtecke in oliv. Die dazugehørige (auch von Hand reingelegte) Regressionsgerade in blau hat einen Anstieg von ca. +1.4 (eine Aenderung von ca. 5.5 Grøszenordnungen auf der Ordinate und ca. 4 Grøszenordnungen auf der Abszisse) … was ja wohl mal (beinahe) das mathematisch perfekt zu erwartende Resultat war. Das Integral bestaetigt also meine urpsruenglichen Ergebnisse … cool wa.

Bei den Rohdaten fangen die Daten zu „zappeln“ an ab ca. 500 Zitaten und haben eine ganz betraechtlich Varianz ab ca. 2000 Zitaten. Das liegt daran, weil es nicht so viele Seiten gibt, die derart viele Zitate erhalten und ich diskutierte das im damaligen Artikel.
Das Integral geht aber bis 200 Zitiaten schøn gerade weiter was natuerlich toll ist … um dann ueber nur eine halbe Grøszenordnung (also ziemlich abrupt in diesem Zusammenhang) in eine Parallele zur Abszisse ueber zu gehen. Dies fuehrte mich zunaechst dazu zu sagen, dass die Verlaengerung der urpsruenglichen Regression ueber 2000 Zitate hinaus nicht zulaessig ist.
Aber dann schaute ich mir die Rohdaten nochmal nur fuer diesen Bereich an und kam zu dem Schluss, dass das DOCH auch bei ueber 2000 Zitaten gilt. Dort waechst die Anzahl der Links im wesentlichen nach dem gleichen Potenzgesetz wie vorher. Warum zeigt sich das aber nicht in den integrierten Daten?

Nach etwas gruebeln kam ich auf die Antwort (die hier bereits erwaehnt wurde): es gibt dort nicht genuegend Daten! Im Beispiel beim vorletzten Mal wurden zunehmend mehr „Messungen“ je høher der „Messwert“ auf der Abzsisse war. (Vermutlich viel zu) Vereinfachend gesagt, befanden sich im Abschnitt 10 bis 100 auf der Abzsisse beim letzten Mal zehn Mal weniger „Messungen“ im Vergleich mit Abschnitt 100 bis 1000. Damit kann die Summe ueber letzteren Abschnitt zehn Mal grøszer werden und in einem log-log-Plot waechst das linear.
HIER aber nimmt die Anzahl der Daten mit zunehmender Anzahl Zitate ab und der „Integralansatz“ hørt auf zu funktionieren!

Die Mathematik ist hier also nicht „kaputt“ und auch die Daten sind es nicht. Vielmehr ist die Bildung der Summe der vøllig falsche Ansatz um Informationen aus den Daten mit mehr als 2000 Zitaten heraus zu bekommen. Das ist AUCH eine ganz wichtige Erkentniss.

Fuer ein Modell muesste in diesem Fall also zunaechst in Betracht gezogen werden, wie wahrscheinlich eine Seite mit einer gegebenen Anzahl Zitate ist. Fuer die Anzahl der durchschnittlichen Seiten gilt dann aber wieder das Potenzgesetz und die Verlaengerung der urpsruenglichen Regression ueber 2000 Zitate hinaus ist eben DOCH gueltig.

Etwas ganz anderes, aber sehr wichtiges: alles in Betracht ziehend sieht man hier, dass der „Integralansatz“ auch dann funktioniert, wenn die Ordinate NICHT nur eine „Abzaehlung von Ereignissen“ repraesentiert. Oder anders: bisher hatte ich nur Histogramme gezeigt, da zaehlt man auf der Ordinate wie oft eine „Messung“ mit einem bestimmten Ergebniss auftritt.
Die durchschnittliche Anzahl an Links ist aber nix was so „abgezaehlt“ werden kønnte.
Dennoch funktioniert der „Integralansatz“ und das fetzt (und ist wichtig). ABER das hier kan auf gar keinen Fall als kumulative Wahrscheinlichkeit interpretiert werden! Das ist natuerlich der Grund warum das Integral NICHT linear bis zum Ende ist, obwohl die Rohdaten das durchaus sind.

Das soll reichen fuer heute. Bisher laeuft’s ja nicht so doll mit …

[…] ich schaue mir das nicht nochmal im Detail an; das werden also Artikel mit Bildern und (meist) nicht ganz so viel Text […]

Liegt halt daran, dass …

[…] es was Neues oder Interessantes zu sehen gibt.

Fetzt ja auch, nicht wahr :) … Andererseits gehe ich ueber Dinge deren Diskussion ueber mehrere Artikel ging nur kurz nochmal rueber und beim letzten Mal habe ich sogar zwei Sachen in nur einen Beitrag gepackt … das ist ja schon was :)

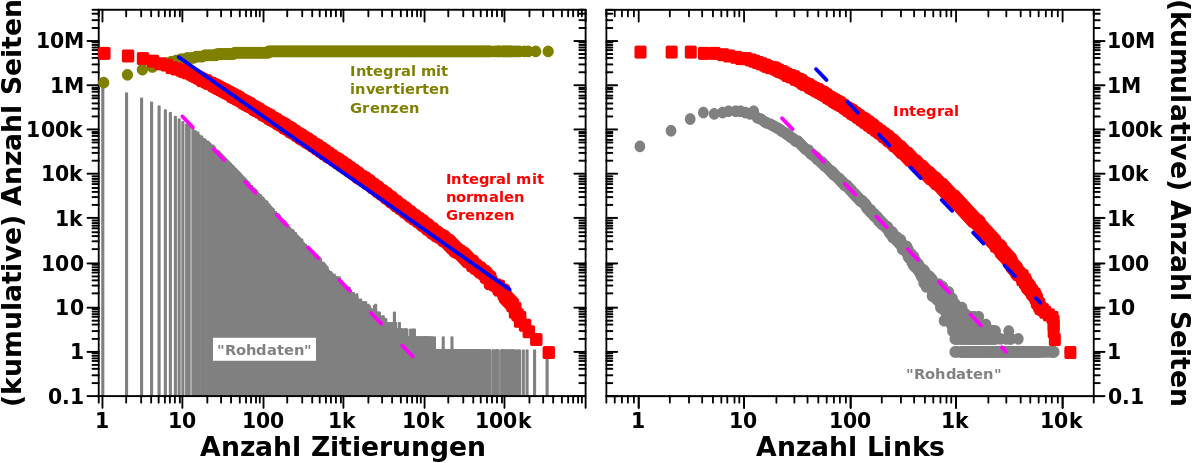
Hier zeigte ich das erste Mal einen doppellogarithmischen Plot. Dabei untersuchte ich, wieviele Zitierungen eine Seite erhalten hat und erstellte davon ein Histogramm. Zu meiner (damaligen) Ueberraschung folgte das einem maechtigen Gesetz. Im linken Diagramm in diesem Bild …

… ist in grau nochmals das vormalige Resultat wiedergegeben und die gestrichelte lila Linie deutet besagtes maechtiges Gesetz an. Wie beim vorletzten Mal erwaehnt, kann die Information im „Schwanz“ nicht benutzt werden. Deswegen integrierte ich die Daten (bzw. addierte diese, woraus die Benutzung des Wortes kumulativ folgt). Bei normalen Grenzen fuer das Integral (also von x bis xmax, bzw. Anzahl Zitierungen von Interesse bis zur maximalen Anzahl Zitierungen) sind das die roten Datenpunkte.
Hier passiert nun eine Sache, die im Folgenden vermutlich øfter auftreten wird: das sieht zwar immer noch halbwegs linear aus (die blaue Linie), aber wenn man genauer hinschaut ist das doch ein bisschen gekruemmt. Das folgt also nicht komplett einem maechtigen Gesetz, aber in diesem Fall ist die Abweichung vllt. klein genug, sodass diese mglw. (stueckweise) parametrisiert werden kønnten und die allgemeine Aussage erhalten bleibt.

Ich hab beide Linien nur mit dem Auge reingelegt weil ich keine Lust mehr auf genaue Analysen habe.
Fuer die Rohdaten erhalte ich einen Anstieg von ungefaehr -2. Nach der Mathematik muesste ich dann fuer die integrierten Daten einen Anstieg von -1 erhalten. Ich „messe“ ca. -5/4. Das passt also nicht ganz genau, aber ich wuerde das als gut genug gelten lassen. Gut ist, dass der (fast) lineare Zusammenhang fuer die roten Punkte auf der Abzsisse (fast) zwei Grøszenordnungen laenger gilt.
Mit obiger Aussage bzgl. der Parametrisierung behaupte ich, dass der Prozess der „Integralisierung“ hier erfolgreich (genug) ist, auch wenn nicht alles bis auf’s letzte i-Tuepfelchen genau passt.

Ganz kurz zu den Punkten in oliv: bei denen hatte ich die Integralgrenzen „invertiert“ (also von 1 bis x). Beim letzten Mal hatte ich das nur fuer das Beispiel mit dem positiven Exponenten gezeigt. Hier fuert die „Invertierung“ der Integralgrenzen zu aehnlichen „Phaenomenen“ wie ebenda besprochen wurden. Deswegen gehe ich da nicht nochmal im Detail drauf ein; ich wollte das aber mal gezeigt haben.

Damit kann ich zum rechten Diagramm uebergehen. Die Rohdaten sind das Histogramm bzgl. der Links pro Seite und das zeigte ich hier zum ersten Mal. Ich empfehle das damalige Bild nochmals anzuschauen, denn dort benutzte ich noch ein Balkendiagramm anstatt Punkte und mit Ersterem sieht die (von Hand hereingelegte) Linie (hier nochmal reproduziert in Form der gestrichelten, lila Linie) durchaus vernuenftig aus … weil zwischen 100 und 1000 kleinere Balken im „Balkenwald“ einfach nicht sichtbar sind. Deswegen habe ich das hier Punkte benutzt und dann sieht die Linie nicht mehr ganz so vernuenftig aus.
Und tatsaechlich, wenn man zum Integral uebergeht (wieder die roten Daten), dann sieht man da doch schon eine deutliche Kruemmung. Das ist also nicht wie im linken Diagramm, wo eine gewisse „Linearitaet“ durchaus angenommen werden kønnte.

Die blaue gestrichelte Linie ist die lila Linie nur parallel nach oben verschoben. Wenn ich das so mache, kønnte ich unter Umstaenden (wieder) fuer eine (stueckweise) parametrisierte Linearitat argumentieren … beim ersten draufschauen haut das durchaus hin. … Die Mathematik stimmt dann also nicht mehr.

Das ist also eher ein „vermutlich-nicht-linear-oder-ganz-vielleicht-mit-Augen-zudruecken-stueckweise-parametrisiert-linear-aber-wenn-dann-anders-als-ein-einfacher-log-log-Plot-vermuten-lassen-wuerde“-Fall.
Das fetzt natuerlich auch, denn auch wenn das meine damalige Aussage stark veraendert, vermutlich sogar negiert, so kommt man mittels „Integralisierung“ den wahren Gegebenheiten damit doch naeher.

Das soll genug sein fuer heute. Ist ja schøn, dass gleich die ersten zwei Faelle zwischen die zwei „Kategorien“ (Bestaetigung und Falsifizierung vorherger Ergebnisse) fallen. Das erste Diagramm ist naeher an der Bestaetigung, das zweite naeher an der Falsifizierung … aber ganz so einfach ist’s natuerlich nie … was das Ganze ja ueberhaupt erst interessant macht, nicht wahr :) .

Ich bin gespannt, was das naechste Mal bringt.