Archive for the ‘Kevin Bacon’ Category

Ich war schon dabei zusammen zu packen, als ich ueber diese Seite (mglw. muss man nach dem klicken auf den Link die Seite nochmal refreshen um das zu sehen, was man sehen sollte) stolperte, auf der man fuer jede Wikipediaseite schauen kann, wie oft die pro Tag angeschaut wurde. Mein erster Gedanke war: das fetzt ja! Mein zweiter Gedanke war: moment Mal, damit kann ich doch direkt schauen, ob meine Annahme, dass Seiten mit mehr (Wikipedia internen) Zitaten populaerer sind, stimmt. Das konnte ich vorher naemlich nicht, weil diese Information nicht Teil des Wikipedia Quelltextes ist.

Das dortige Interface ist zwar fein, wenn man mal mit ein paar wenigen Seiten rumspielen will, aber ich wollte natuerlich die Daten fuer alle Seiten haben. Dies brachte mich (wieder) zu einer Seite, die ich bereits gaaaaanz am Anfang dieses Projekts vorstellte und dort gibt es einen Direktlink zu den Analytics data files. Von dort geht es dann weiter zu „Pageview complete“ … um dort dann mit zwei verschiedenen Rohdatenquellen konfrontiert zu werden: alte Daten und neue Daten.
Um eine etwas kompliziertere Angelegenheit kurz zu machen: es dauerte eine kleine Weile, bis ich da durchgeschaut hatte und die Datenlage ist etwas uneinheitlich und von Artefakten geplagt.

Dies hier ist ein Beispiel fuer ein unnatuerliches Artefakt (und indirekt eine Mthodenaenderung), in dem man die Klickzahlen fuer Cat und Dog fuer Juli und August 2017 sehen kann. Bei den Hunden ist alles knorke; eine im wesentlichen flach verlaufende Kurve mit ein paar Spitzen in denen ca. 2 1/2 mal so viele Leute sich fuer Hunde interessieren. Letzteres erregt mein Misstrauen erstmal nicht, denn ein Faktor von 2.5 passiert schon mal, gerne auch mehrfach. Das lohnt sich meistens nicht weiter zu untersuchen, denn vllt. gab’s da ’n Artikel ueber ’n Hund in ’ner Lokalzeitung irgendwo, oder eine Netflix-Dokumentation und solche Sachen.
Bei den Katzen hingegen sieht man einen massiven Ansteig um 1 1/2 Grøszenordnungen (!) an nur einem einzigen Tag. Es stellte sich heraus, dass Bots regelmaeszig die Wikipedia durchqueren und dann sowas verursachen. Mal mit mehr, mal mit weniger starken (aber immer deutlich herausstechenden) Klickzahlen.
Solche unnatuerlichen Peaks sind also im Wesentlichen bei allen Seiten dabei … … … bis die Wikipedia eine Methode gefunden hat die Bots zu erkennen und seitdem sind die NICHT mehr mit dabei.

Ein Beispiel fuer ein natuerliches (!) Artefakt ist der Film Tenet. Heutzutage liegt der taegliche Zaehler bei ein paar Tausend Klicks. Als der Film rauskam zeigt dieser aber bis zu ca. 50 Mal so viel an. Ist ja ganz natuerlich (insb. fuer diesen Film) und logisch, beschreibt aber nicht das normale Verhalten.

Ein weiteres Beispiel einer Methodenaenderung sind Nutzer von unterschiedlichen Hardwareplattformen. Am Anfang gab’s keine Mobilfunkversion, dann wurde das nicht unterschieden und alles nur in eine Zahl gepackt und in den neuesten Daten haben Nutzer der „mobilen Wikipedia“ ihre eigenen Klickzaehler.

Ich versuchte Artefakte in den Daten zu erkennen und „rauszurechnen“ … aber das ist alles nicht so eindeutig und fuer das was ich damit erreichen will war es mir zu viel Aufwand. Deswegen beschloss ich davon auszugehen, dass die unnatuerlichen Artefakte sich im Mittel gleich ueber alle Seiten verteilen bzw. im Groszen und Ganzen nicht weiter auffallen.
Ersteres ist durchaus eine plausible Annahme, muesste streng genommen aber nachgewiesen werden. Letzteres ergibt sich daraus, dass unnatuerliche Artefakte selten auftreten (eine weitere Annahme, die eigtl. geprueft werden muesste, aber wenn die oft auftreten wuerden, dann waeren die Statistiken prinzipiell unbrauchbar) und sich ueber’s Jahr gesehen im Mittel … øhm … herausmitteln … bzw. im „Fehler verschwinden“. Im Wesentlichen gilt das Gleiche (das Selbe?) auch fuer natuerliche Artefakte.
Probleme gibt es nur bei Seiten die erst seit kurzem existieren, denn da stellen potentielle (natuerliche) Artefakte einen signifikanten Anteil der Daten und hatten noch keine Zeit sich „rauszumitteln“. Andererseits habe ich ca. 6 Millionen Seiten insgesamt und pro Monat gibt’s nur … … … ja wie viele neue Seiten gibt’s denn eigentlich pro Monat?

Zum Glueck kann man das aus diesen Daten extrahieren, wenn man die zwei folgenden (wieder: durchaus plausiblen) Dinge annimmt. Eine neue Seite hat vor dem Tag ihrer „Geburt“ null Klicks. Am Erstverøffentlichungstag wird die Seite mindestens ein Mal angeklickt; naemlich vom Schøpfer selbst. Ersteres muss man nicht mal nachpruefen, denn das geht nicht anders. Bei Letzterem bin ich mir unsicher, es fuehlt sich aber richtig an; die Wikipedia ist ja nicht mein Weblog, bei dem Artikel im Voraus geschrieben um dann am Tag der Verøffentlichung nicht gelesen zu werden. Falls nicht, dann kønnte man argumentieren, dass ’ne Seite eben erst dann „wirklich geboren“ wird, wenn der erste Leser drauf klickt.
Und hier sieht man die Anzahl der neuen Seiten pro Monat seit Beginn der verfuegbaren Daten (minus ein Monat, denn als Ende 2007 die allerersten Klickzahlen registriert wurden, gab es bereits ca. 3.5 Millionen Seiten):
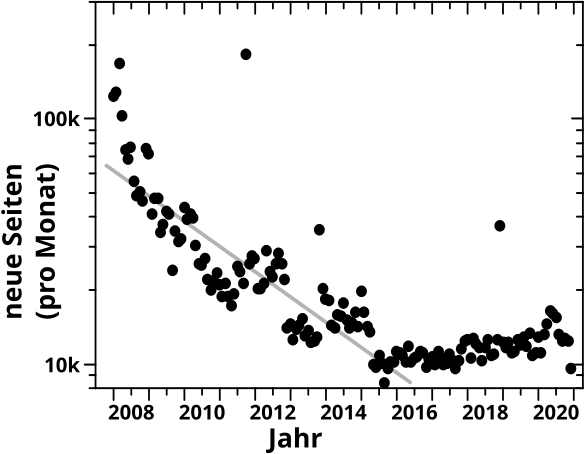
Die groszen Abszissenstriche kennzeichnen den Januar eines Jahres und die kleinen Abzsissenstriche liegen genau in der Mitte (also zwischen Juni und Juli). Die Jahreszahl ist auf die Mitte eines Jahres zentriert. Auszerdem habe ich natuerlich NUR die Seiten betrachtet, welche in die Kevin Bacon Analysen der letzten Jahre eingeflossen sind.

Was man im Diagramm sieht ist, dass die Anzahl neuer Seiten pro Monat _drastisch_ abgenommen hat. Die Gerade habe ich nur zum Vergleich reingelegt und bei logarithmischer Ordinate entspraeche die einem exponentiellen Abstieg … und wenn man genau hinschaut, ist das tatsaechliche Gefaelle schneller! An dem laengerfristigen Trend konnten auch die Schreibspurts (die pløtzlich auftretenden Spitzen) nur relativ kurzfristig was aendern. Bis Mitte ca. 2015 setzte sich der Trend fort und stabilisierte sich dann auf ca. zehntausend neue Seiten pro Monat, mit _ganz_ leicht steigender Tendenz (ca. 13k pro Monat Ende 2020).

Mit Blick auf Artefakte in neuen Seiten ist im Wesentlichen nur das letzte Jahr relevant. Wir reden hier also von nicht mehr als ca. 150-tausend Seiten oder ungefaehr 2.5 Prozent der ca. 6 Millionen Seiten die in meine Betrachtungen eingflossen sind. Jut … muss ich mir also keine Sorgen deswegen machen.

Das soll reichen fuer heute. Beim naechsten Mal zeig ich dann das, was ich eigtl. zeigen wollte.
Beim letzten Mal fasste ich meine Erlebnisse mit den Selbstzitierungen zusammen und lande damit heute dann endlich bei der letzten untersuchten Grøsze, der Linkfrequenz.

Im ersten Kapitel dazu (XLII) fuehrte ich etablierte Analysen durch und bereits hier stellte sich heraus, dass die Resultate anders sind, als bei den anderen Grøszen. Oder anders: mehr Raetsel die es zu løsen galt. Und auch gleich hier machte sich ein „alter Bekannter“ — das „São-Paulo-FC-Artefakt“ — nicht nur nach langem „Schnueffeln“ sondern sofort und unmittelbar bemerkbar … zusammen mit anderen „Artefakten“, bei denen es schien, dass diese vom allgemeinen „Verhalen“ verdammt aehnlich Ersterem waren.

Das war nicht unerwartet, aber um das erklaeren zu kønnen, widmete ich Kapitel XLIII zunaechst dem besseren Verstaendnis des „Originals“. Diese Vorarbeit erlaubte es mir dann in Kapitel XLIV und XLV ohne weitere Umschweife die Betrachtungen auf die anderen „Artefakte“ zu erweitern.

Letztlich muendete all das in Kapitel XLVI (Teil 1 … oder A … oder wie ich das sonst immer kennzeichnete, denn hier unterliesz ich eine Zaehlung der (zwei) Teile und gab denen nur andere Titel) in einer neuen Betrachtungsweise der Daten, die ich bisher nicht unternommen hatte: das Histogramm der Integrale unter den Kurven der Seiten. Bei den totalen und neue Links bzw. den Selbstreferenzen kam da nicht viel bei rum. Wenn man weisz, wonach man gucken muss und die Erklaerung schon kennt, dann sieht man bei den totalen (und neuen) Linsk bereits das Archipel im „Schwanz“ der Histogramme. Aber das geht flieszend ineinander ueber und wenn man die Erklaerung noch nicht kennt, dann ist das schwer auseinander zu popeln.
Bei der Linkfrequenz hingegen trennt sich das Archipel ganz eindeutig vom Rest der Seiten und die neue Betrachtungsweise erlaubte eine vorherige Frage viel leichter zu beantworten (und damit das vormals erhaltene Ergebnis zu bestaetigen): welche Seiten gehøren zum Archipel? Dem widmete ich dann Teil 2 des selben Kapitels.

Danach ging es in Kapitel XLVII weiter mit einer weiteren (mittlerweile) Standardanalyse: wie sehen denn die vielen einzelnen Verteilungen aus? Das war aber schwer zu interpretieren und ich betrachtete in den zwei Teilen von Kapitel XLVIII die Idee einer „kollektiven Wanderung“ etwas genauer. Das war zwar durchaus interessant, aber da kam aber nicht wirklich viel bei raus.
Das Gleiche kann gesagt werden bzgl. der Abhaengigkeit des Wertes der Linkfrequenz auf einem Linklevel vom Wert auf dem vorherigen Linklevel, dem ich mich in Kapitel XLIX widmete. Das legte „nur“ eine weitere „Kuriositaet“ dar, die man bei linearen Skalen in den entsprechenden Diagrammen deutlich sah, aber nicht mit den sonst oft ueblichen doppellogarithmischen Skalen. Mal davon abgesehen, dass ich sowas immer verstehen møchte, widmete ich der „Kuriositaet“ nicht nur Kapitel L sondern auch Kapitel LI, denn es illustrierte so schøn die Wichtigkeit unterschiedlicher Ordinaten- und Abzsisseneinteilungen und wie solche unterschiedliche Informationen zu Tage førdern. Auszerdem gab mir die Beschaeftigung mit dieser „Kuriositaet“ die entscheidende Idee, wie ich weitere „Artefakte“ in den Daten aufstøbern kann.

Das ging ich dann sehr ausfuehrlich in den sechs Teilen des Kapitels LII an und das wichtigeste Ergebnis war, dass die „Artefakte“ gar keine Artefakte sind, sondern ein reales und oft (genug) auftretendes Phaenomen sind … auch wenn das nicht sofort zu erkennen ist und man das erstmal aus den Daten rauspolken muss. Ich nannte das dann „Familien“.
Dies kam dann entsprechend dem supertollen Erlebnis der Entdeckung der Archipele nahe … nur nicht ganz, weil ich besagtes Phaenomen schon lange erwartet hatte, aber vorher nicht wusste, wo ich da „ran komme“. Dafuer musste ich erst die erforderlichen „Werkzeuge“ (in Form der richtigen Analysen) „entwicklen“.

Das alles fuehrte mich dann doch nochmal auf die viel frueher bereits untersuchte, dann aber sogleich verworfene, Idee eines Phasenuebergangs innerhalb des Wikipedialinknetzwerks zurueck. Da ich nun alles viel besser verstand und von mehr „Seiten“ betrachtet hatte, konnte ich die Idee in den Kapiteln LIII bis LVII, nochmals angehen. Diesmal sehr viel erfolgreicher, denn ich fand sogar Groeszen, die als Ordnungsparameter angesehen werden kønnen. Ich bin da zwar sehr zufrieden mit meiner Arbeit (und mir), aber letztlich konnte ich damit leider nicht viel weiter mit anfangen.

Kapitel LVIII diente dann nur noch einem „Ueberbleibsel“ bzgl. der Linkfrequenz; einer bis dahin noch nicht durchgefuehrten Standardanalyse. Eine kleine Abweichung in dem Ergebnis betrachtete ich in Kapitel LIX (wieder einmal) sehr detailliert.

Das war’s dann mit der Linkfrequenz und ich dachte, dass es das dann auch im Groszen und Ganzen mit Kevin Bacon war. Aber in den vielen Monaten seit ich angefangen hatte, wurde ich mit einer (fuer mich) neuen „Diagrammart“ vertrau: doppellogarithmischen Plots bei denen die Ordinate den aufsummierten Wert der entsprechenden Grøsze darstellt. Damit schaute ich mir alle vorhergehenden Ergebnisse nochmal an und Kapitel LX wurde dadurch acht Teile lang.
Von einer Ausnahme abgesehen, kam dabei nichts total Bemerkenswertes  heraus. Das ist aber auch gut, denn es waere doch sehr peinlich gewesen und haette mich in Erklaerungsnot gebracht, wenn die „neuen“ Diagramme all zu hohe Abweichungen von den ersten Ergebissen aufgewiesen haetten. Vielmehr wurden diese bestaetigt, in vielen Faellen sogar (weit) ueber den vorher als gueltig akzeptierten Bereich hinaus.
Die Ausnahme waren nur die Archipele, bei denen diese Art von Diagramm etwas Neues zutage førderten. Letztlich lag das aber „nur“ an der verminderten Unsicherheit durch die neue Art der Betrachtung und ich fand recht schnell eine Erklaerung.

Und dann dachte ich schon wieder, dass ich fertig war … nur um zu merken, dass ich die einzige … zugegeben, nicht direkt gestellte, aber implizit gegebene … Frage aus dem allerersten Beitrag noch gar nicht beantwortet hatte:

[W]ieviele „Schritte“ braucht man im Durchschnitt von irgendeiner Seite zu irgendeiner anderen Seite?

Auf die Beantwortung der Frage „warf“ ich mich dann nochmal mit groszem Elan und betrachtete das sehr detailliert. Deswegen besteht Kapitel LXI auch aus acht Teilen.

Das war’s dann aber wirklich (fast) … und mit diesem Beitrag ist’s nun auch tatsaechlich genau drei Jahre her, dass die Kevin Bacon Maxiserie los ging. Inklusive diesem hier verøffentlichte ich 136 Artikel unter dem Kevin Bacon Titel … Das ist ein „sportliche“ Abweichung von meiner ersten Abschaetzung, dass ich wohl nach sechs Artikeln fertig bin.

Damit kann Kevin Bacon als abgeschlossen angesehen werden … aber noch nicht als zu Ende, denn wie erwaehnt, war’s das noch nicht ganz … es folgt ein Anhang, mit Sachen die mir waehrend des Schreibens der Zusammenfassung untergekommen und noch interessant sind … aber … wait for it … das sollen nur ein paar wenige Artikel werden … tihihi.

Beim letzten Mal stoppte ich die Zusammenfassung genau vor dem Beginn zu den Untersuchungen bzgl. der sog. Selbstzitierungen (pro Linklevel) … also auf welchem Linklevel die Ursprungsseite einer Linknetzwerkanalyse (von anderen Seiten) wie oft zitiert wird. Bevor ich damit anfing dachte ich nicht, dass da all zu viel zu holen sei und Kapitel XXVIII und XXIX schienen das zunaechst zu bestaetigen.
Doch dann schaute ich mir in Kapitel XXX ein relativ kleines Detail genauer an; buchstaeblich nur ein einziger Balken in einem Balkendiagramm voll mit Balken, der etwas høher war als erwartet … und das war der Anfang eines (intellektuell) wunderbaren Abstechers, denn dadurch wurde ich auf ein komplett neues, bisher vøllig verstecktes Phaenomen im Linknetzwerk der Wikipedia aufmarksam: Wissensarchipelen.

Ich wollte die Diskrepanz in der Høhe des oben erwaehnten Balkens erklaeren kønnen und den Mechanismus der dazu fuehrt aufklaeren. Ich begann die Entdeckungsreise mit der einfachsten Idee, dass es Seiten gibt die nicht vom Rest der Wikipediaseiten zitiert werden. Diese allererste „Insel“ des „Archipels“ erfuhr unmittelbar eine Erweiterung um solche Seiten, die zwar auch nicht von „auszen“ zitiert werden, aber sehr wohl von besagter ersten Insel.
Mit diesem einfachen Mechanismus konnte ich ueber 95 % der Diskrepanz des Balkens erklaeren. Ich ueberlegte ernsthaft, ob ich mich dem Rest widmen sollte, denn das faellt doch alles in den 10-Prozent-Fehler. Aber da packte mich die Entdeckerlust noch mehr und ich erweiterte das einfach Archipelmodell erheblich.
Ich bin bis heute stolz auf die Ideen und auch (wieder) die Diagramme, denn noch einmal sind diese eine so schøne Illustration, wie wissenschaftlicher Erkentnissgewinn zustande kommt: eine kleinen Diskrepanz weckt die Kuriositaet der Forscherin welche sich das mal genau anschaut um dann zunaechst einfache Ideen „daran“ auszuprobieren, welche im Verlauf der Untersuchungen weiterentwickelt werden. Und am Ende ist die Diskrepanz erklaert, aber das eigentlich coole ist nicht die Erklaerung an sich, sondern dass man etwas vøllig Neues und Unerwartetes entdeckt hat, von dessen Existenz man vorher nichts ahnte.

Ich baute dann noch ein schøn rekursives Programm, mit dem ich alle Inseln des Archipels finden konnte und schwuppdiwupp … war nicht nur die Gueltigkeit des erheblich erweiterten Archipelmodells nachgewiesen, sondern (nach ein paar weiteren, einfacheren Ueberlegungen) die Diskrepanz zu 99.996788 % erklaert … Hurrah … Wait! What? … 15 Seiten die zur Diskrepanz beitragen entzogen sich den Erklaerungen und ich benøtigte einen Spaziergang um eine Idee zu bekommen was das fuer Seiten sein kønnten … die Idee stellte sich zum Glueck als richtig heraus … Spaziergaenge sind voll fetzig und regen mein Gehirn oft an :) .

Das war’s dann mit der Aufklaerung des Diskrepanz in der Høhe eines Balkens und das einzige Mal, bei dem ich mich nicht nur mit einer Erklaerung zufrieden gab die gut genug ist, sonder alles bis auf die letzte Zahl genau untersuchte.
Aber das das war’s noch nicht mit den Archipeln. Denn nach deren Entdeckung habe ich natuerlich deren Eigenschaften untersucht und mir eine zugehørige Kuriositaet angeschaut.

Dies alles zaehlt definitiv zu den schønsten Dingen die mir im Laufe des Kevin Bacon Projektes passiert sind … und der Besprechung dieser Erfahrung widmete ich einen eigenen Weihnachtsbeitrag :) .

Zu den Selbstreferenzen schloss ich in Kapitel XXXII ein paar lose Enden ab und dachte das war’s dann … um genau dort festzustellen, dass die einzelnen, linklevelabhaengigen Verteilungen der Selbstreferenzen sich vøllig anders verhalten als bei den totalen (oder neuen) Links.

Das fuehrte mich auf eine weitere laaange Abschweifung, denn ich hatte deswegen die Idee, dass man dieses Verhalten ja mglw. mittels relativ einfacher Formeln und nur ein paar wenigen Parametern simulieren kønnte.
Deswegen untersuchte ich zunaechst ab Kapitel XXXIII die Eigenschaften dieser Verteilungen um besagte Parameter naeher zu bestimmen. Dabei entdeckte ich, dass das Sprichwort „Vom Hundertsten ins Tausendste kommen“ eine empirische Grundlage hat und sogar quantifizierbar ist … und erstellte das vllt. schønste Diagramm der ganzen Maxiserie.
In Kapitel XXXVI Teil 3 und Teil 4 fand dann endlich die Simulation statt, die eigtl. recht ordentlich ist. Gruende fuer Abweichungen von den Messungen diskutierte ich in den Kapiteln XXXVII und XXXVIII.
Das war zwar alles ganz nett und ich habe viel Zeit damit verbracht, aber ich bin selber nicht so richtig zufrieden mit dem Ganzen. Das ist aber nicht falsch zu verstehen. Ich bin zufrieden, dass das klappte und die Ergebnisse ganz gut sind. Aber es stellte sich kein so supertolles Entdeckergefuehl ein wie bei den Archipelen zuvor. Aber so ist das ja oft, man kann nicht immer nur und jederzeit das Allerfetzigste machen.

Die Selbstreferenzen schloss ich in Kapitel XXXIX mit dem Blick auf (mehr) Kuriositaten ab um in Kapitel XL nochmal kurz auf die totalen (und neuen) Links zurueck zu kommen. Letzteres geschah, weil ich im Zuge der vorherigen Betrachtungen eine Untersuchung der Daten durchfuehrte, die mir vorher nicht in den Sinn kam. Das ist ja nur natuerlich und sollte noch øfter passieren. Dabei kam aber nicht viel raus … bis auf Kapitel XLI, in dem ich wieder einmal (die Ursache von) Fehler(n) genauer betrachtete.

So … nun ist auch dieser Beitrag schon wieder so lang … ich dachte, dass ich die Zusammenfassung in nur einem (wenn auch etwas laengeren) Beitrag packen kønnte … aber das ist fuer Herr Bacon ja nix Neues, dass es mal (deutlich) laenger als erwartet dauert und laenger wird. Deswegen geht’s beim naechsten Mal mit den Untersuchungen zur letzten Grøsze, der sog. Linkfrequenz weiter. Und vielleicht bin ich dann ja auch beim naechsten Mal mit der Zusammenfassung fertig.

Beim letzten Mal fasste ich die Geschehnisse in der Kevin Bacon Maxiserie bis dahin zusammen, dass alles am Platz war um mich der eigentlichen Aufgabe zu widmen, mit der das hier alles startete: wie entwickelt sich das Wikipedialinknetzwerk, gesehen ueber ALLE Wikipediaseiten.

Zunaechst widme ich in den Kapitel XVIII bix XXV meine Aufmerksamkeit der Entwicklung der Anzahl aller Links die eine Seite (pro Linklevel) sieht. Dabei stiesz ich unmittelbar auf die Beobachtung, dass sich das ueberhaupt nicht so verhaelt, wie ich das mit „durchschnittlichen Ueberschlagsrechnungen“ erwartet haette. Die genauere Untersuchung førderte letztlich ganz klar zu Tage, wie krass ein paar wenige Seiten die anfaengliche Dynamik ganz massiv beherrscht. Wie bereits beim letzten Mal geschrieben, konnte dieser Fakt …

[…] im weiteren Verlauf der Maxiserie immer wieder zur Erklaerung anderer Phaenomene herangezogen [werden].

Ebenso erhielt ich im Zuge dieser Untersuchungen eins der schønsten Resultate insgesamt: ein maechtiges Gesetz an einer Stelle an der ich das nicht erwartete. Das musste (sehr viel) spaeter etwas modifiziert werden … aber auf logische Weise und letztlich wurde besagtes schøne Resultat damit sogar ueber die urspruenglich sicheren Grenzen bestaetigt.

Kapitel XXI widmete ich dann zum Ersten Mal einer detaillierten Fehlerbetrachtung. Dort (also allgemein bei allen Fehlerbetrachtungen, nicht nur in diesem konkreten Kapitel)  ging ich insb. auch auf von „mir verursachte“ Unzulaenglichkeiten in den Erklaerungen ein bzw. inwiefern meine Erklaerungen unzulaenglich sind. Von „mir verursacht“ ist in Anfuehrungszeichen, weil ich gewisse Dinge in den Daten nicht mit Absicht herbeifuehrte. Diese kamen aber durch die von mir durchgefuehrte Vorbereitung der Daten vor der Linknetzwerkanalyse zustande (bzw. den Code der dieser Vorbereitung zugrunde liegt). In allen Faellen haette ich dagegen gar nichts unternehmen kønnen, da ich von den Umstaenden die letztlich zu den Unzulaenglichkeiten fuehrten nix wissen konnte. Das deswegen, weil die dazugehørenden Phaenomene nicht oft genug auftreten, als dass es mir bei den wenigen tausend Wikipediaseiten die ich mir im Detail anschaute untergekommen waere. Sollte das nochmal gemacht werden, sind das aber natuerlich vermeidbare Fehlerquellen; ein weiterer (und wichtiger) Grund Fehlerbetrachtungen durchzufuehren und (intellektuell / wissenschaftlich) ehrlich zu bleiben.
Solche Fehlerbetrachtungen kamen im Laufe der Maxiserie ein paar Mal vor und liegen mir durchaus am Herzen. Dies nicht weil ich so toll bin, sondern viel mehr im Gegenteil, weil ich’s nicht bin. So ziemlich jedes Mal wenn ich die durchfuehrte haderte ich zunaechst mit mir ob ich das jetzt wirklich aufschreiben soll. Zum Einen, weil ich ungern Fehler zugebe. Zum Zweiten, weil die diskutierten Dinge in Bezug auf die Gesamtheit aller Daten ohnehin in den „10-Prozent-Fehler“ fallen. Und zum Dritten, weil das vermutlich niemandem aufgefallen waere, ich diese Niemandin aber mit der extra Betrachtung drauf aufmerksam mache.
Weil ich es aber schaffte meine (intellektuellen / emotionalen) Unsicherheiten zu ueberwinden liegen mir diese Betrachtungen so nah am Herzen … mal davon abgesehen, dass es (nicht nur) aufgrund der oben genannten Gruende sehr wichtig ist, dass man sowas macht.

In Kapitel XXII schaute ich mir „Kuriositaeten“ an … viel zu holen gab’s bei denen weder hier, noch wenn ich das spaeter fuer andere Grøszen machte. Letztlich sind es Einzelfaelle deren Besonderheiten sich zwar individuell erklaeren lassen, die aber (deutlich) aus dem allgemeinen Muster (und damit meinem Interesse) heraus fallen.

Kuriositaten stehen im Gegensatz zu (wenn auch oft seltenen, aber) systematisch auftretenden Diskrepanzen. Auf eine gewisse Art und Weise trifft dies auf die Untersuchungen zum Ende des Linknetzwerks aller Seiten in Kapitel XXIII zu. Ich schreibe das deswegen, weil ich durch diese zum allerersten Mal ueber das (erst viel spaeter wichtig werdende) “ São-Paulo-FC-Artefakt“ stolperte.
Doch zunaechst bemuehte ich mich in Kapitel XXIV darum, eine Zustandsaenderung in den Daten zu sehen, weil das die Beobachtungen auf coole und interessante Weise erklaert haette. Auch diese Idee wurde spaeter nochmal wichtig, aber zu dem Zeitpunkt stellte sich noch waehrend des Schreibens und Untersuchens heraus, dass ich das beobachtete Phaenomen streng (und auch weniger streng) genommen so nicht erklaeren sollte. Das Kapitel endete also mit einer „Negierung“ all dessen worueber es handelte.
Letzteres war aber nicht so schlimm, denn zum Ersten verdeutlichte es doch meinen obigen, allgemeinen Punkt (zur Fehlerbetrachtung). Zum Zweiten bin ich immer voll zufrieden mit mir, wenn ich nach langen, detaillierten und durchaus muehsamen Untersuchungen eine bessere Erklaerung fuer eine Beobachtung finde. Zum Dritten hatte es einige der fetzigsten Diagramme (eins davon sogar bewegt!) in der ganzen Maxiserie zur Folge. Auf die bin ich bis heute stolz. Natuerlich sehen sie cool aus und es steckt ’ne Menge Arbeit drin, aber viel mehr verdeutlichen sie so schøn den ganzen Weg von einer Beobachtung, ueber die Realisierung (und Visualisierung) zum Teil sehr abstrakter Ideen, hin zum Erkentnissgewinn. Auch das wird innerhalb der Serie mehrfach geschehen und voll fetzige Erkentnisse zur Folge haben.
Ach ja, besagte abstrakte Ideen konnten (sehr viel) spaeter mittels einer anderen Betrachtung der Daten deutlich weniger abstrakt verallgemeinert werden.

In Kapitel XV beendete ich denn (endlich) die Untersuchungen zur Anzahl aller Links pro Linklevel und begann mit der Untersuchung der Entwicklung der neuen Links pro Linklevel. Das ging bis Kapitel XXVIII und war eher „unfruchtbar“. Das ist auch nicht zuletzt darin sichtbar, dass es fuer diese Kapitel keine Unterkapitel gibt. Ich sah eben nix Neues, musste nix wirklich Unerwartetes erklaeren und die Beobachtungen benøtigten keine intellektuell reizenden (wenn auch mglw. eher abstrakten) Ideen zur Erklaerung.

Fuer mich war zu dem Zeitpunkt ziemlich genau ein Jahr vergangen, seit ich mit dem ganzen Projekt angefangen hatte. Aufgrund der enttaeuschenden Ergebnisse bzgl. der neuen Links dachte ich, dass ich wohl bald zum Ende kommen werde. Ich konnte ja nicht ahnen, dass sich diese Einschaetzung mit der Analyse der Selbstzitierungen als fulminant falsch heraus stellen sollte … aber darin steckt so viel Tolles, dass es den Rahmen dieses Beitrags sprengen wuerde und ich es auf’s naechste Mal verschiebe.

Mit dem vorigen Beitrag møchte ich die „formalen“ Betrachtungen in der Kevin Bacon Maxiserie nach (heute auf den Tag genau) zwei Jahren und elf Monaten abschlieszen. Aber keine Sorge, die drei Jahre kriege ich sicherlich noch voll, denn zwei zu Kevin Bacon gehørende Sachen habe ich noch. Die kommen aber in den „Anhang“, denn bzgl. des Wikipedialinknetzwerkes werde ich nix Neues anfangen.

Zum Einen bin ich vor kurzem auf eine Datenquelle gestoszen, in der fuer jede Seite die tatsaechlichen „so-oft-wurde-ich-angeschaut“-Zahlen zu finden sind. Damit kann ich schauen ob meine Vermutung, dass die Anzahl der (internen) Zitate die eine Seite erhaelt (wie oft diese also auf andenen Seiten verlinkt ist), mit der „Beliebtheit“ (oder auch „Wichtigkeit“) korreliert, stimmt.

Zum Anderen muss ich schauen, ob die Resultate i.A. reproduzierbar sind. Dafuer habe ich mir zum Einen die Wikipedia nochmal beschafft (das war schon im Dezember, also ziemlich genau drei Jahre spaeter). Auszerdem gehe ich gerade durch die vielen (Analyse)Programme welche ich im Zuge dieses Projektes schuf durch und schreibe die nochmal neu aber (hoffentlich) klarer, strukturierter und allgemeiner (oder spezifischer, falls gegeben) … also i.A: besser (hoffentlich). Ebenso verpasse ich den Programmen eine ausfuerhliche Dokumentation. Damit ich das dann auch mal der Welt zur Verfuegung stellen kann.
Beides zusammen genommen ist also eine gute Gelegenheit den neuen Code auf seine Richtigkeit und die vorherigen Ergebnisse auf ihre Reproduzierbarkeit zu ueberpruefen. Das werde ich dann aber i.A. nur noch kurz zeigen à la „Hier ist alt, hier ist neu, passt schon“.

Wieauchimmer, das ist Zukunftsmusik. Der heutige Beitrag soll die Serie „im Geiste“ abschlieszen mittels eines zusammenfassenden Rueckblicks.

Los ging alles mit einer fixen (und definitiv NICHT konkreten) Idee und ich dachte damals, dass das Ganze in sechs Beitraegen fertig wird … HAHA!
Die fuer die Realisierung der Idee nøtigen Rohdaten waren schnell gefunden und in den Beitragen III bis VII sortierte ich all den Kram raus, der fuer die Analyse irrelevant war. Am Ende blieben 5,798,312 Seiten zur Analyse uebrig und so schnell ging’s (mehr als) sechs Beitraege zu schreiben. Dabei hatte ich noch nicht mal angefangen mich damit zu beschaeftigen, womit ich mich urspruenglich beschaeftigen wollte. Auszerdem konnte hier zum ersten Mal ein Phaenomen beobachtet werden, welches im weiteren Verlauf der Maxiserie mit schøner Regelmaeszigkeit auftauchte: eine weitere Unterteilung der „Kapitel“, wenn ein Thema zu viel wurde fuer einen einzigen Beitrag.

Aber dann ging’s endlich richtig los … ich „sprang“ in die Daten um zu schauen, was die mir so erzaehlen … und wurde sofort abgelenkt vom urspruenglichen Ziel, denn ich schaute mir zunaechst an, was man machen kann ohne dass man das Linknetzwerk aller Seiten „abschreitet“.

Die Analyse der Laenge der Titel fand zwar alles unter dem selben rømischen Numeral statt, umfasste aber sechs Beitraege … und brachte mir sogar eine „Superabschweifung“ in Form eines Geburtstagsbeitrags ein :) .

Bei der Analyse wie oft eine Seite (intern) von anderen Seiten zitiert machte mich sofort auf zwei Phaenomene aufmerksam, welche im weiteren Verlauf der Maxiserie immer wieder zur Erklaerung anderer Phaenomene herangezogen wurden. Zum Einen, dass ein paar wenige Seiten urst krass viel øfter zitiert werden als die „durchschnittliche Seite“. Zum Anderen, dass es Seiten gibt die kuenstlich aufgeblaeht sind, einfach weil jemand bspw. zu allen „Dørfern“ eines Landes eine Wikipediaseite mit zwei Saetzen erstellt hat, welche dann immer das lokale Wort fuer „Dorf“ verlinken. Die Wichtigkeit dieser Beobachtungen war mir zu dem Zeitpunkt aber natuerlich noch nicht bewusst.
Desweiteren traten bereits hier doppelllogarithmischer Diagramme und (ein) maechtige(s) Gesetz(e) auf … deren Bedeutsamkeit sich durch die ganze Serie zog und nicht unterschaetzt werden darf!
Unter rømisch zehn tat ich das Gleiche fuer die Anzahl der Links und sehr aehnliche Resultate.

Was mich auf die Idee brachte dies „zusammen zu ziehen“ und die „Relevanzdiskussion“ mal mit Zahlen anzugehen weisz ich nicht mehr. Dabei traten aber zwei Dinge zutage, welche sich ebenso mehr als ein Mal bemerkbar machen sollten.
Zum Einen, dass die Analyse und das Verstaendniss der Daten oft relativ grosze Abstraktionsgrade erfordert. Der Sprung von der Anzahl der Zitate einer Seite zum (lueckenlosen) „Relevanzwert“ einer Seite war da noch recht einfach … was mglw. fuer die kurz darauf folgende „komprimierte Relevanz“ nicht mehr gesagt werden kann.
Zum Anderen, dass es Anomalien in den Daten gibt, die gesonderte, detaillierte Betrachtungen erfordern um sie erklaeren zu kønnen. Zum Glueck bin ich so „gestrickt“, dass mir sowas keine Ruhe laeszt und derartige, oft (eigtl. immer) zeitaufwaendige „Abschweifungen“ von der Masse der Daten hin zu „Minoritaeten“, sollte mir im Weiteren Verlauf der Serie die besten Erlebnisse und Entdeckungen bescheren … wenn auch oftmals nach vielem Haareraufen.

Dann ging es aber endlich weiter … naja … nicht so richtig, denn das Linknetzwerk musste ja erstmal „abgeschritten“ werden, bevor ich mich der urspruenglichen Idee widmen konnte. Dafuer „mathematisierte“ ich von „Kapitel“ XII bis XV das Problem und der einzige „technische“ Artikel der ganzen Serie ist dem „Geniestreich“ gewidmet, der das „Abschreiten“ (und damit die Realisierung der Idee) ueberhaupt erst møglich machte.

Das wahrhaft technische habe ich euch, meinen lieben Leserinnen und Lesern, gar nicht „angetan“ und „versteckte“ es in nur einem einzigen Beitrag. Ich wollte aber wenigstens einen Beitrag haben bzgl. der tatsaechlichen Umsetzung des „Geniestreichs“ in funktionierenden Code, war es doch das, was mir in diesem langen Projekt die grøszte Zufriedenheit brachte. Ich musste naemlich so viele Sachen lernen, von denen ich vorher nicht die geringste Ahnung hatte um sehr spezifische, sehr technische Probleme zu løsen von denen ich vorher noch nicht mal wusste, dass es die gibt. Der Weg zum besagten, nicht nur funktionierenden, sondern auch praktikabel schnellen (!) Code war so befriedigend, dass ich ernsthaft ueberlegte, das Projekt an der Stelle zur Ruhe zu legen … dachte ich doch, dass das nicht getoppt werden kønnte … damit lag ich zwar richtig, aber zu dem Zeitpunkt konnte ich natuerlich noch nichts von den Entdeckungen (und weiteren, zu ueberkommenden Problemen) ahnen, welche mir fast genausoviele intellektuelle Orgasmen bescheren sollten :) .

Ach ja, an der Stelle sollte ich nochmal erwaehnen, dass erst dieser Code die praktische Durchfuehrbarkeit des Projektes ermøglichte. Der „Geniestreich“ machte es prinzipiell møglich, aber erste Implementierungen haetten ein halbes Jahrhundert gebraucht um zu Ergebnissen zu gelangen. Durch besagten Code konnte das auf ca. vier Monate Gesamtrechenzeit reduziert werden (und ca. 2 Monte tatsaechliche Rechenzeit, weil ich mehr als einen Laptop 24/7 damit beschaeftigt hielt).
Und ja, ich bin da bis heute maechtig stolz auf mich … meiner Meinung nach durchaus berechtigt denn bevor ich damit anfing dachte ich immer, dass ich gewisse erwartete Probleme nie im Leben løsen kønnte, weil ich dafuer nicht genug Kompetenz habe … und dann hab ich mir die Kompetenz zu eigen gemacht und das doch geschafft … toll wa :) .

Bevor es dann mit den Untersuchungen der Resultate des „Abschreitens“ des Linknetzwerks aller Wikipediaseiten los gehen konnte, stellte ich in Kapitel XVII die Grøszen vor, deren Entwicklung bei besagter Linknetzwerkanalyse ueberhaupt untersucht wurden. Am schwierigsten … oder eher abstraktesten war dabei die Grøsze, die ich „Linkfrequenz“ nannte. Spaeter stellte sich heraus, dass es sehr gut war, dass ich das mit untersuchte, denn war diese doch sehr sehr „fruchtbar“.

An dieser Stelle breche ich fuer heute ab und fuege dem (urspruenglichen) Titel ein „rømische I“ hinzu. Wie so oft gibt’s mehr zu erzaehlen als in einen Artikel passt … aber es war ja auch (bzw. ist immer noch) eine sehr langanhaltende Serie.

In den vorherigen Beitraegen habe ich untersucht, wie schnell man (im Durchschnitt) von den spezifischen Seiten einer Untergruppe zu irgendeiner (!) anderen Seite kommt … u.U.

Eine Sache die von Interesse ist kann ich leider nicht untersuchen: wie schnell kommt man von den spezifischen Seiten einer Untergruppe zu den spezifischen Seiten einer anderen Untergruppe … u.U. Ich wuerde bspw. vermuten, dass ich am schnellsten von Seiten mit vielen Links zu Seiten mit vielen Zitaten komme.
Die dafuer nøtige Information faellt bei der Netzwerkanalyse an. Die konnte aber leider nicht gespeichert werden, denn das wuerde ca. 100 TB erfordern. Ich hatte schon angefangen und das programmiert, denn ich hatte ein paar Ideen, wie man die Information verlustfrei (!) komprimieren kønnte … ich habe mir also meinen eigenen „Zip“-Algorithmus ueberlegt. Ich war maechtig stolz auf die Ideen die ich hatte, aber leider ist die Entropie in den entsprechenden Daten so grosz, dass ich das Datenvolumen auf maximal 1/3 reduzieren kønnte. Ungefaehr 30 TB sind immer noch zu viel. Dies insb. im Lichte dessen, dass erstens die Ergebnisse vermutlich nicht viel mehr Erkentnissgewinn zur Folge gehabt haetten, als das was ich mittels der neuen Links und der Linkfrequenz herausbekommen habe, ich zweitens nicht gewusst haette, was ich sonst noch mit den Daten machen soll, und dass ich drittens dann die gesamte (mehrmonatige) Netzwerkanalyse nochmal haette durchlaufen lassen muessen.

Anstatt dessen schau ich heute mal, wie ein „Nutzererlebniss“ aussieht, denn das ist ja doch anders als die abstrakten Betrachtungen vorher … naja … abstrakt bleibt es vermutlich, denn ich zeige immer noch Diagramme.

Da ich ein Nutzer der Wikipedia (meist mehrfach pro Tag) und ganz normal[Citation needed] bin, nehme ich meine eigene Erfahrung diesbezueglich als repraesentativ an.
Zunaechst ist dann zu sagen, dass ich praktisch gesehen die meistzitierten Seiten nie aufrufe. Klar, die laenderspezifischen Seiten sind sicherlich interessant fuer Millionen von Schulkindern pro Jahr, aber danach schauen die auch nie wieder drauf. Sicher, Japan schaute ich mir an im Zuge der Vorbereitung auf meine grosze Reise im Jahre 2023; aber Letztere war auszergewøhnlich und ich habe die Seite nie in einem anderen Zusammenhang besucht.
Desweiteren schaue ich mir nie die am wenigsten zitierten Seiten an … auszer im Rahmen dieses Projekts, da habe ich buchstaeblich tausende von denen gesehen. Aber ansonsten wuerde ich nie im Leben drauf kommen mich ueber Bacon in Ohio zu informieren.

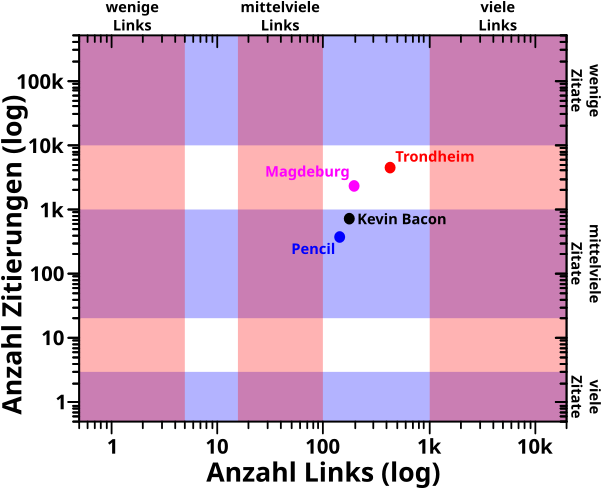
Vielmehr schaue ich als Nutzer nach „normalen“ Seiten … hier ’ne Stadt … dort ’ne Person … und ab und zu mal ein Dingens (sehr weitgefasst). Beispielhaft dafuer nehme Kevin Bacon (wen auch sonst), das durch Monty Python beruehmt gewordene Trondheim, das Erzbistum Magdeburg und den guten alten Bleistift.

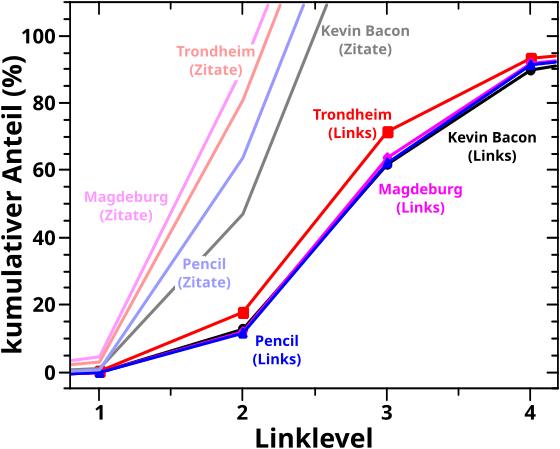
In diesem Diagramm zeige ich mittels der farbigen Baender nochmals die Bereiche der sechs Untergruppen und wie sich die vier Beispiele dazu verhalten:

Interessant! Ich haette nicht erwartet, dass Trondheim so beliebt ist.
Wieauchimmer, man sieht, dass die von mir als „normal“ empfundenen Seiten das zumindest teilweise mglw. gar nicht sind. Pencil und Kevin Bacon liegen bzgl. der Anzahl der Zitate von andere Seiten in der „mittelvielen“ Gruppe (die ich unterbewusst als „normal“ betrachte … hier sieht man aber einen der Gruende, warum ich fuer den Namen der Gruppen dieses Adjektiv nicht benutzen wollte). Man kønnte argumentieren, dass sie nahe genug an der gleichen Gruppe bzgl. der Anzahl der Links liegen, denn prinzipiell kønnte man da auch etwas (mehr) Spielraum einraeumen, wenn man die Grenzen fuer die Gruppen festlegt. Diese Argumentation kønnte man auch fuer Magdeburg vornehmen (auch bzgl. der Zitate), aber definitiv nicht fuer Trondheim. Letzteres liegt genau zwischen zwei Gruppen bzgl. beider Charakteristika.

Ganz schøn viele „kønnte“ in obigen Saetzen. Letztlich ist das aber nicht so wichtig. Fuer mich sind das „normale“ Seiten und ich wollte nur mal schauen wo die liegen. Von Interesse sind die kumulativen Anteile:

Bemerkung: mit „Zitate“ meine ich natuerlich die Linkfrequenz, aber das ist so viel zu schreiben und ich wollte es nicht abkuerzen … und das Diagramm war schon fertig … und so schlimm ist das nicht, denn Letztere kommt ja wegen Ersteren zustande.

OI! … alle vier Beispiele werden ungefaehr ein Linklevel „schneller“ von anderen Seiten gesehen (kumulativer Anteil Zitate, helle Kurven), als dass sie andere Seiten erreichen (kumulativer Anteil neue Links, nicht-helle Kurven) … *kurzer Blick auf das erste Diagramm* … das sollte mich eigtl. nicht verwundern, denn alle Beispiele haben (signifikant) mehr als Links als Zitate.

Wenn wir mal zur Analyse der Untergruppen zurueck schauen, so liegt der „50-Prozent-Uebergang“ der Beispiele bzgl. der Links an ca. der Stelle der Untergruppen mit den vielen Links / Zitaten. Das ist interessant, denn einige der obigen „das kønnte man auch dort und dort einordnen“ tendierten eher zur Untergruppe mit den „mittelvielen“ Links. Andererseits sprechen wir hier von vier Beispielen im Vergleich zu einer Gruppe mit ueber 2 Millionen Seiten.
Bzgl. des kumulativen Anteils der Linkfrequenz liegen die Beispiele zwischen den Untergruppen mit vielen bzw. mittelvielen Zitaten; Kevin Bacon und Pencil liegen naeher an Letzterer waehrend Trondheim und Magdeburg naeher an Ersterer liegen … was dem Erwartungsbild (nach dem ersten Diagramm) entspricht.

Alles in allem erwartete ich bei den vier Beispielen nix fundamental Unerwartetes und das ist dann auch eingetreten.

SO … nun aber … jetzt bin ich wirklich durch und beim naechsten Mal fang ich tatsaechlich (und endlich?) an „zusammen zu packen“.

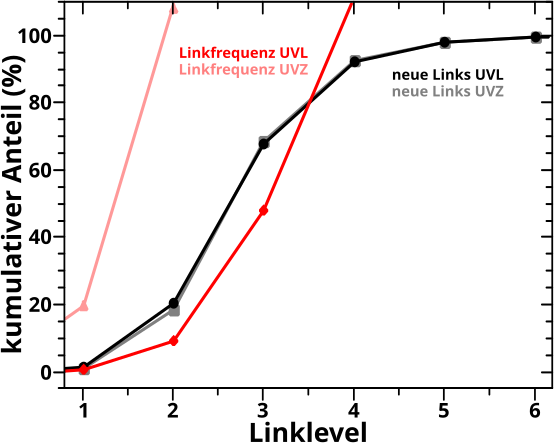
Nach den langen Erklaerungen vom vorletzten und letzten Mal kann ich heute die Betrachtungen bzgl. der Inter- und Intragruppenunterschiede der kumulativen Kurven der Untergruppen mit den vielen Links / Zitaten (UVL / UVZ) …

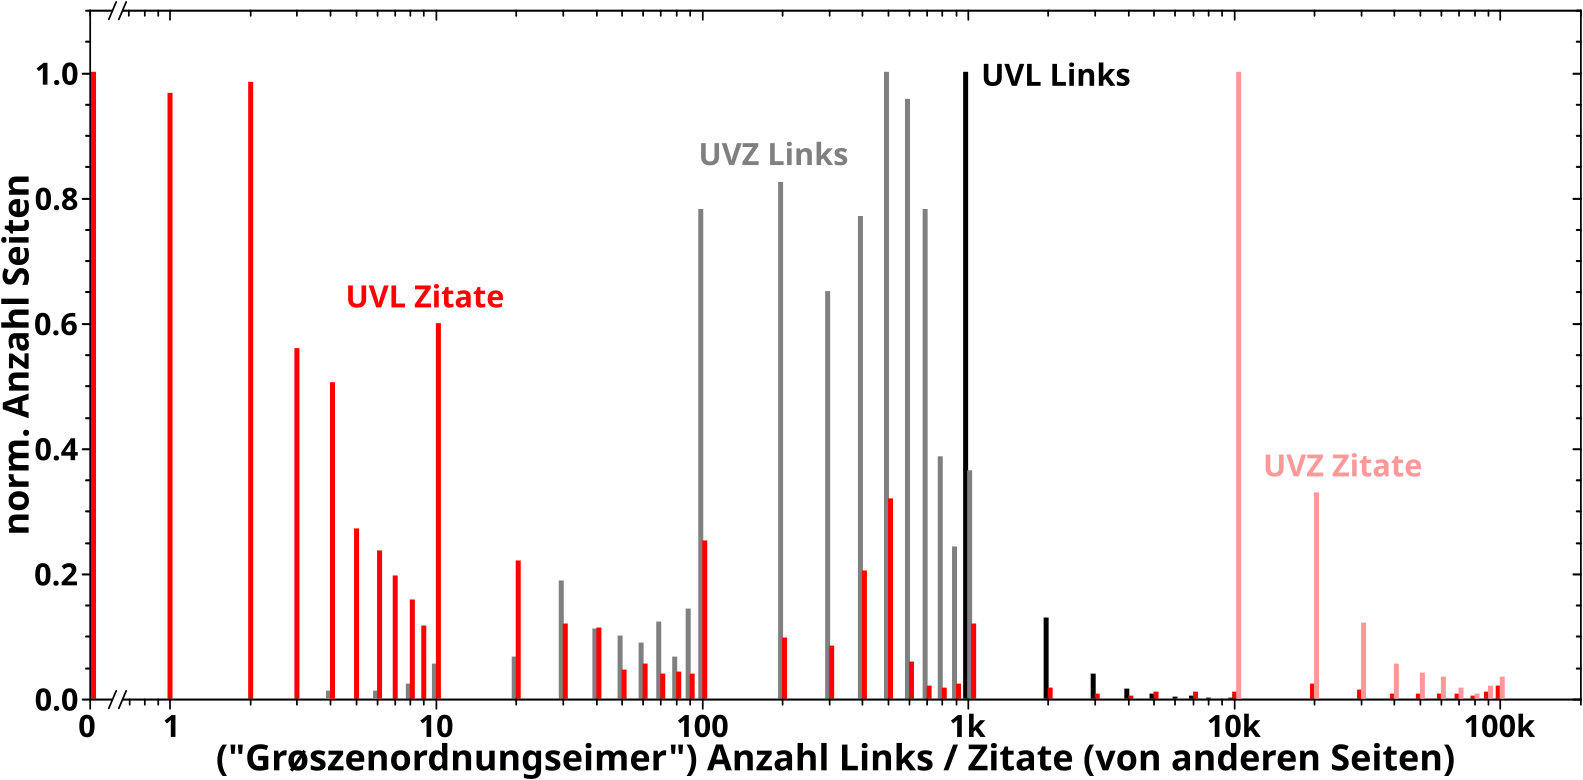
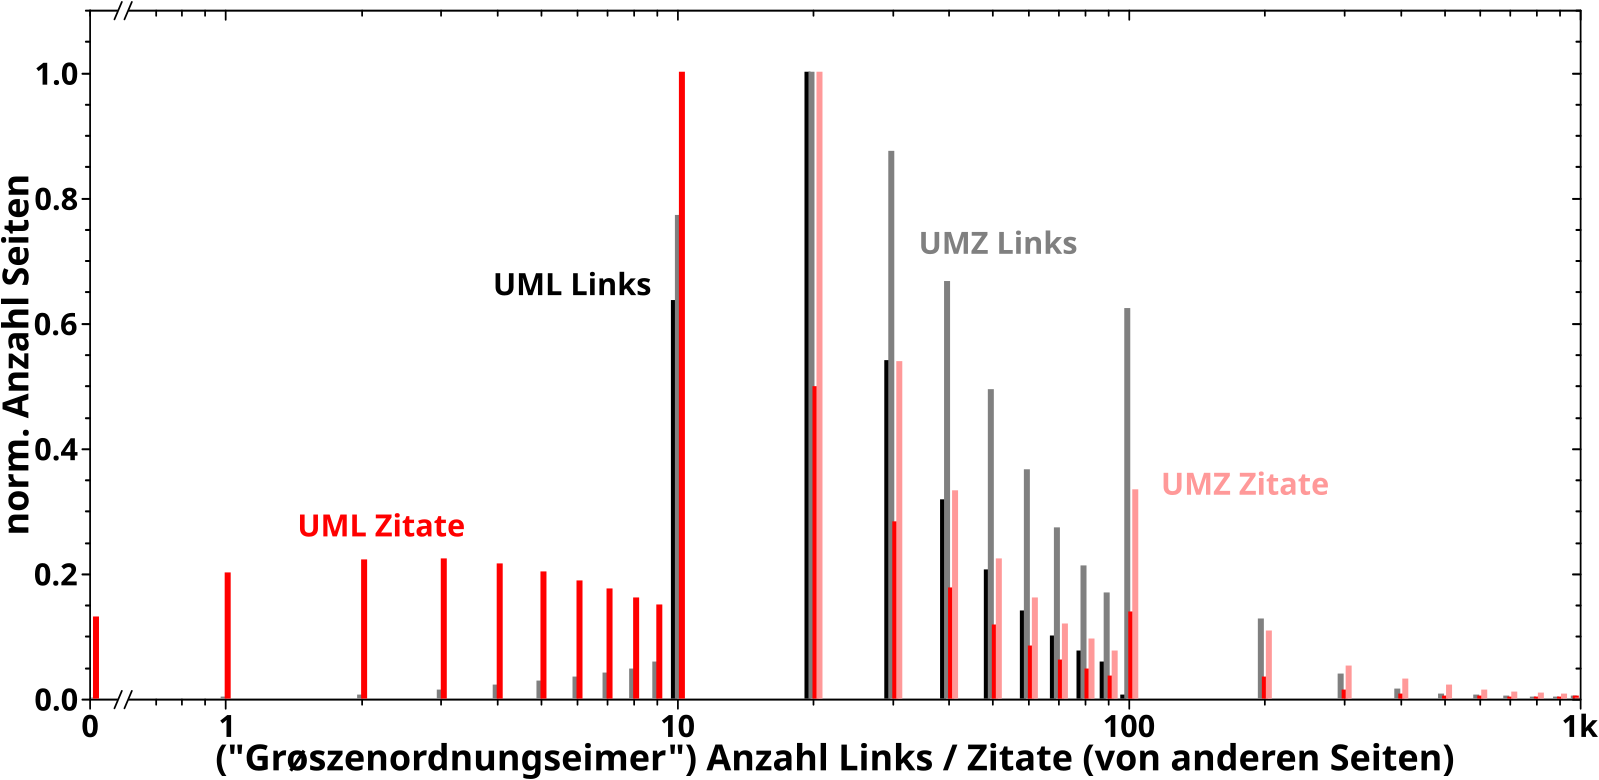
… tatsaechlich ziemlich kurz halten. Dafuer zeige ich sofort die Histogramme …

… und muesste vermutlich gar nicht viel weiter dazu sagen.

Die schwarze und graue Kurve liegen (beinahe) aufeinander, weil die allermeisten Seiten der UVL aehnlich viele Links haben wie ein signifikanter Anteil der Seiten der UVZ. Die schwarzen Balken gehen naemlich sehr schnell runter. Deswegen wuerde ich vermuten, dass die allermeisten Seiten der UVL eher 10 als bspw. 15 Links haben. Und 10 ist gar nicht so weit weg von den 5, 6 oder 7 Links, welche die meisten Seiten der UVZ haben. Auszerdem sieht man bei genauem Hinschauen ja auch, dass die schwarze kumulative Kurve ein klein bisschen høher liegt als die graue kumulative Kurve. So qualitiativ betrachtet passt das schon mit Hinblick auf dessen, was ich beim letzten Mal schrieb.

Die rote kumulative Kurve liegt nun unter der schwarzen kumulativen Kurve, weil im roten Histogramm betraechtliche Anteile (weit) links von 1000 Zitaten (dem høchsten Balken im schwarzen Histogramm … auch wenn dort die Links gezaehlt werden) liegen. Bzgl. der hellroten Kurve gilt umgekehrt (also høher und rechts) das Gleiche.

Und hier offenbart sich dann auch, warum der UVZ / UVL Intergruppenabstand der kumulativen Kurven berechnet aus der Linkfrequenz so grosz ist, dass ich diese Betrachtungen ueberhaupt erst anstellen musste. Die meisten Seiten der UVZ haben zehntausend Mal mehr Zitate als die meisten Seiten der UVL. Das Maximum des roten Histogramms liegt bei null, aber auch ein oder zwei Zitate sind nicht viel, verglichen mit den mindestens zehntausend Zitaten die alle Seiten der UVZ haben.

Toll wa! So schnell geht das bei guter Vorbereitung.

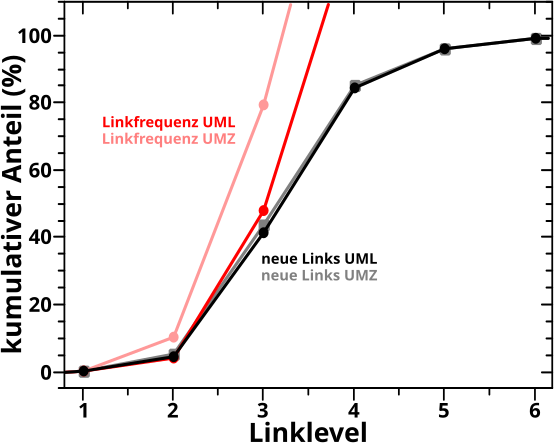
Weil ich beim letzten Mal alles so lang und breit erklaert habe, kann ich sofort und ohne viel Aufhebens (oder nochmalige Wiederholung) daran anknuepfen und zeige ohne Umschweife die kumulativen Kurven fuer die Untergruppen mit den mittelvielen Links / Zitaten (UWL / UWZ):

Rein qualitativ wuerde ich daraus die folgenden Dinge vermuten bzgl. der Histogramme. Weil die beiden schwarzfarbigen Kurven beinahe aufeinander liegen, sollten die Histogramme fuer die Links in den wesentlichen Eigenschaften gleich sein fuer beide Untergruppen. Die rote Kurve schmiegt sich anfangs sehr an die beiden zuvor genannten Kurven an. Deswegen wuerde ich vermuten, dass auch das entsprechende Histogramm der Zitate der UML den vorherigen beiden Histogrammen aehnlich ist.
Bzgl. der Verteilung der Zitate der UMZ wuerde ich denken, dass diese „rechtslastig“ ist, im Vergleich zu den anderen drei Verteilungen, weil die kumulative Kurve erhøht ist. Aber genug der vielen Worte hier sind die Histogramme:

Ich bleibe bei einer qualitativen Diskussion der Ergebnisse und auf den ersten Blick scheint alles so zu sein wie oben vermutet. Der jeweils høchste schwarze und graue Balken sind an der gleichen Stelle und das Histogramm entwickelt sich auch aehnlich.
Der høchste rote Balken liegt nur um einen „Eimer“ daneben und entwickelt sich auch aehnlich. Das wuerde mich nicht wundern, wenn ein so geringfuegiger Unterschied im Histogramm bei den kumulativen Kurven keinen groszen Unterschied hinterlaeszt. Ob eine Seite nun 10 oder 20 neue Links sieht … vom Bauchgefuehl haut das schon hin.
Die grøszte Schwierigkeit scheint darin zu liegen zu erklaeren, warum die hellrote kumulative Kurve sich nicht auch an die anderen Kurven anschmiegt. Die Histogramme sehr doch aehnlich aus, ja der høchste Balken ist an der selben Stelle. Ich denke, dass die Erklaerung darin zu suchen ist, dass es keine hellroten Balken links von 20 Zitaten gibt, waehrend alle anderen Histogramme dort doch betraechliche Anteile haben (was die kumulativen Kurven entsprechend „runter zieht“).

Nun schrieb ich im letzten Satz das Wort „scheinbar“ nicht umsonst, denn die eigentliche Schwierigkeit sieht man erst beim genaueren hinschauen: auch wenn das Maximum des schwarzen und des grauen Histogramms an der selben Stelle ist, so sind die grauen Balken rechts davon doch ungefaehr immer doppelt so hoch wie die schwarzen Balken. Wenn man da mal drueber nachdenkt, dann sollte das doch zu einer høheren kumulativen (grauen) Kurve fuehren, … tut es aber augenscheinlich nicht.
Das bereitete mir erhebliches Kopfzerbrechen und ich musste von einer qualitativen Betrachtung zumindest zu einer teilweisen quantitativen Betrachtung uebergehen um die Erklaerung fuer das NICHTvorhandensein von etwas Erwartetem zu finden  … aber der Reihe nach.

Zunaechst verweise ich auf die beiden Diagramme vom letzten Mal und zur vereinfachten Diskussion beschraenke mich auf die Daten fuer die neuen Links (das Folgende ist aber analog bzgl. allem was mit der Linkfrequenz zusammen haengt).
Die kumulativen Kurven gehen etwas, aber nicht weit auseinander. Die Kurven sind aber definitiv nicht (beinahe) deckungsgleich wie hier. Bei den entsprechenden Histogrammen sieht man, dass es sehr viele (und hohe) grauen Balken rechts vom Ende der schwarzen Balken gibt. Genauer gesagt haben ca. 75 % aller Seiten der UMZ mehr Links als die Seiten der UML. Das ist betraechtlich.
Fuer die kumulativen Kurven zaehlt aber letztlich nicht nur der Unterschied in der Anzahl der Seiten, sondern das Produkt aus der Anzahl der Seiten in jedem „Eimer“ mit der Anzahl der Links fuer die dieser „Eimer“ steht. Oder anders: jede Seite im høchsten grauen Balken (Anzahl Links = 10 bis 20)  ist doppelt bis viermal so viel „wert“ wie die Seiten im letzten schwarzen Balken (Anzahl Links = 5).

Worauf ich hinaus will ist der Fakt, dass die Histogramme doch schon DEUTLICH unterschiedlich sind, es aber dennoch nur zu einem relativ geringen Abstand in den kumulativen Kurven fuehrt. Damit kann ich zurueck zur obigen Schwierigkeit gehen.
Ca. 65 % der Seiten der UMZ sind in den (grauen) Balken rechts vom Maximum des Histogramms „einsortiert“. Fuer die Seiten der UML liegt der Wert bei ca. 45 %. Das ist ein Unterschied von gerade Mal 20 %. Klar, 20 % ist schon nicht mehr wenig. Andererseits kommt der Name des „ca.-10-Prozent-Fehlers“ nicht von irgendwo her; alles was nur so wenig von den Erwartungen abweicht ist schwer vom „Rauschen“ zu unterscheiden … und 20 % ist gerade mal doppelt so grosz. Auszerdem kann man in der grauen kumulativen Kurve ja auch eine kleine „Erhøhung“ erkennen … nur eben nicht so deutlich wie im entsprechenden Diagramm vom letzten Mal.

Ich brauchte Stunden (und musste eine Nacht drueber schlafen) um darauf zu kommen … wobei ich viel Zeit damit verbracht habe erstmal nochmal alles auszurechnen und das entsprechende Programm auf Fehler zu ueberpruefen, weil ich dachte, ich hatte irgendwo einen gemacht. Aber so ist das nun Mal, wenn man nach Wissen strebt und es bereitet mir trotz des vielen Haare raufens grosze Freude :) .
Wieauchimmer, ich nehme aus den hier sehr kurz gehaltenen Betrachtungen mit, dass die Unterschiede in den Verteilung ziemlich grosz sein muessen, um wenigsten moderate „Spuren“ in den kumulativen Kurven zu hinterlassen.
Das ist aber auch gut so, denn dadurch wird meine Aussage, dass ein Unterschied von einem Balken nicht so viel ausmacht, direkt (oder indirekt … ach ich will da jetzt nicht drueber nachdenken) bestaetigt.

Ebenso ist das auch nicht gegenteilig zu dem was ich oben bzgl. der jeweils hellroten Balken / Kurve schon sagte. Bei der schwarzen und grauen Kurve liegen jeweils ca. 20 % der Seiten links vom høchsten Balken, waehrend es ueberhaupt gar keine hellroten Balken dort gibt. Die rosa Kurve wird also in keinster Weise von solchen „kleinteiligen“ Anteilen „herunter gezogen“. Hinzu kommt, dass bei genauer Betrachtung die hellrote kumulative Kurve anfangs ja dann doch gar nicht all zu weit weg ist von bspw. der schwarzen kumulativen Kurve. Qualitiativ wuerde ich sagen haut das alles hin und mein Bauchgefuehl sagt mir, dass die obige Erklaerung bzgl. des Nichtvorhandenseins eines groszen Unterschieds zwischen der grauen und der schwarzen kumulativen Kurve nicht geaendert werden muss.

Uff, jetzt ist das doch so viel geworden … naja … dann muss die Erklaerung fuer die groszen Intragruppenunterschiede der UVL und UVZ (welche diese Betrachtungen ja ueberhaupt erst herbeifuehrten) noch bis zum naechsten Mal warten.

Beim letzten Mal zeigte ich (unzureichend vereinfachend und zusammenfassend), dass Seiten mit wenigen Links im Durchschnitt laenger brauchen um zu einer beliebigen anderen Wikipediaseite zu gelangen als Seiten mit vielen Links. Unter Beruecksichtigung der „umgedrehten Situation“ gilt i.A. das Gleiche fuer Seiten mit vielen Zitaten.
Dafuer hatte ich alle Wikipediaseiten (paarweise) in Untergruppen eingeteilt und mir das Verhalten eben jener genauer angeschaut. Besagtes Verhalten ist wie erwartet, zeigt aber kleinere Abweichungen (und mindestens eine grøszere) die ich beim letzten Mal erwaehnte aber nicht weiter untersuchte (oder erklaerte).
Ebenso liesz ich (mit Absicht) einen wichtigen Vergleich weg, denn ich zeigte nicht, inwiefern die Resultate fuer die beiden „Richtungen“, aus denen das Verhalten des kumulativen Anteils der neuen Links bzw. der Linkfrequenz betrachtet werden muss, uebereinstimmen. Ueber alle Seiten betrachtet sind die entsprechenden Kurven (beinahe) deckungslgleich (und sollten es auch sein) … zumindest fuer die fruehen Linklevel bei denen „Mehrfachsichtungen“ in der Linkfrequenz noch (sehr) selten vorkommen und eben diese damit fuer einen solchen Vergleich noch nicht unbrauchbar gemacht haben.

Beide Sachen hole ich heute und beim naechsten Mal nach. Ich teile das auf zwei Artikel auf, denn ich beschraenke mich fuer diesen Artikel nur auf die Resultate fuer die Untergruppen mit wenigen Links bzw. Zitaten. Dies deswegen, weil ich zur Diskussion der Unterschiede (mal wieder) Verteilungen heranziehen muss, diese aber nicht auf die uebliche Art und Weise darstellen kann. Damit es dadurch nicht zu Verwirrungen kommt muss das genau diskutiert. Das macht den heutigen Artikel recht land und deswegen trenne ich das auf.

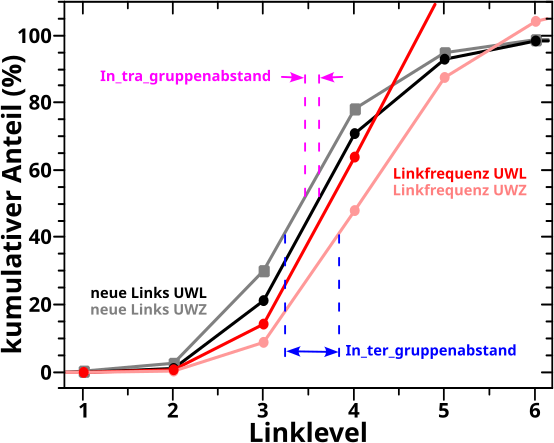
Aber nun Butter bei die Fische! Der Vergleich der kumulativen Kurven fuer die beiden „Richtungen“ fuer die Untergruppen mit wenigen Links (UWL) und wenigen Zitaten (UWZ):

AHA! Im Gegensatz zu dem was ich oben schrieb bzgl. aller Seiten, sind die Kurven hier definitv nicht (beinahe) deckungsgleich; nicht mal bis LL3! Ist ja interessant und daraus folgt, dass zwei Unterschiede in den Kurven erklaert werden muessen: 1. der Intragruppenabstand zwischen zwei Kurven die zu einer „Richtung“ gehøren und 2. der Intergruppenabstand zwischen den Kurven der zwei verschiedenen „Richtungen“.

Dafuer muessen wir zurueck zu den Verteilungen der Links und  Zitate gehen. Natuerlich nicht fuer alle Seiten sondern nur fuer die, die sich in den beiden Untergruppen befinden.
Hier tut sich nun aber ein Problem auf mit Hinblick auf die Unterguppen mit den vielen Links / Zitaten. Diese enthalten naemlich nur wenige Seiten. Die entsprechenden Verteilung bspw. fuer die UVZ waeren dann nur 703 Striche die alle nur bis eins gehen. Auszerdem erfahren diese Striche auch noch „logarithmische Komprimierung“ und „verschmieren ineinander“.

Das ist zunaechst nix Schlimmes, denn fuer Histogramme fasst man oft ohnehin alle Messungen mit Werten (einer bestimmten Charakteristik, hier bspw. der Anzahl der Links) die nahe beisammen liegen in einem „Eimer“ zusammen. Alle „Eimer“ sind gleich grosz (bspw. 1 bis 5 Links, 6 bis 10 Links usw.)  und das Histogramm selber zaehlt fuer jeden Balken dann wie viele Messungen in dem „Eimer“ sind.
Die Wahl der Grøsze dieser „Eimer“ kann mitunter trickreich sein. Bisher brauchte ich das nicht machen, weil es so viele Wikipediaseiten gibt und die entsprechenden Verteilungen auch ohne „Eimer“ aussagekraeftig waren. Bei nur (bspw.) 703 Seiten ist dem aber nicht mehr so.

Die „Eimer“ løsen das erste Problem, die Balken der Verteilung wuerden bei gut gewaehlter „Eimergrøsze“ unterschiedlich grosz ausfallen. Nun ist es aber so, dass die Abzsisse fuer die Histogramme (wie so oft) logarithmisch ist. Wenn man nicht gerade gigantische „Eimergrøszen“ heran zieht, tritt also weiterhin das Problem der „logarithmischen Komprimierung“ auf. Ganz davon abgesehen, dass wenn „Eimer“ fuer hohe Grøszenordnungen gewaehlt werden (bspw. von 100-tausend bis 110-tausend) die gleiche „Eimergrøsze“ sich ueber mehrere Grøszenordnungen bei kleinen Werten erstreckt (in diesem Fall vier von 1 bis 10k).
Die von mir gewaehlte Løsung besteht darin, dass ich die Grøsze der Eimer davon abhaengig mache, in welcher Grøszenordnung sie sich auf der Abzisse befinden. Ich nenne das „magnitudal bins“ oder „Grøszenordnungseimer“.

Das hørt sich vermutlich komplizierter an, als es ist. Kurzgesagt teile ich jede Grøszenordnung (also von 0 … 9, 10 … 99, 100 … 999 usw.) auf der Abzsisse in neun, jeweils gleich grosze „Eimer“  ein. In der ersten Grøszenordnung „fallen“ die Seiten in jeden „Eimer“ wie gehabt. In der zweiten Grøszenordnung „fallen“ in den ersten „Eimer“ alle Seiten die zehn oder mehr Links / Zitate haben, aber weniger als 20. Der zweite „Eimer“ ist entsprechend fuer alle Seiten mit 20 bis 29 Links / Zitaten und der neunte fuer alle Seiten mit 90 bis 99 Links / Zitate. Bei 100 erfolgt der Uebergang zur naechsten Grøszenordnung und der entsprechende erste „Eimer“ ist nun zehn Mal so grosz — also eine Grøszenordnung mehr — (denn dieser enthaelt alle Seiten mit 100 bis 199 Links / Zitaten).

Das løst alle Probleme fuehrt aber zu einer kleinen Verkomplizierung, die man im Hinterkopf behalten muss. Beim Uebergang von einer Grøszenordnung zur naechsten wachsen die Balken des Histogramms pløtzlich sprunghaft an. Der Grund liegt natuerlich darin, weil in besagten Balken pløtzlich zehn Mal mehr Seiten stecken als noch einen „Schritt“ vorher. Gedanklich muss man die Balken an solchen Grenzen also entsprechend verkleinern.
Im hiesigen Zusammenhang spielt das keine all zu grosze Rolle, denn es reicht zu sehen, ob eine Untergruppe mehr Seiten links (oder rechts) vom „Maximum“ der Verteilung der anderen Untergruppe hat. Letzteres ist auch der Grund, weswegen ich die Histogramme normiere.

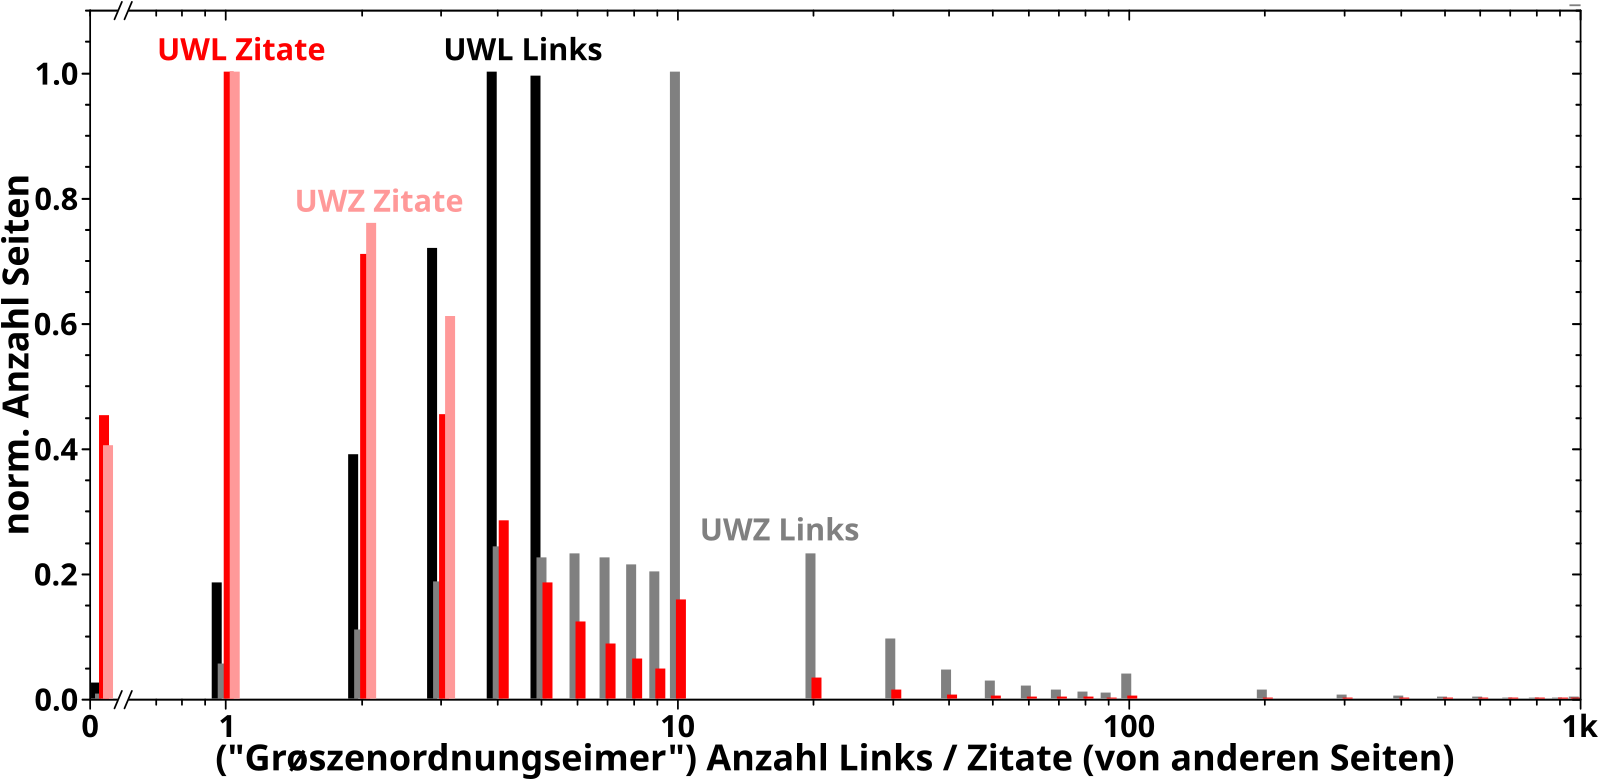
Genug geredet, hier sind sie, die Verteilungen der Links und Zitate der UWL und UWZ:

Fetzt wa! Bei den grauen Balken (Verteilung der Links der UWZ) sieht man beim Wert 10 auf der Abzsisse deutlich das Phaenomen, was man im Hinterkopf behalten muss. Nicht ganz so deutlich sieht man es auch an dem entsprechenden roten Balken (Verteilung der Zitate der UWL). Aber eigentlich will ich damit ja die Intra- und Intergruppenabstaende erklaeren. Darum der Reihe nach.
Ach so, ich hab die Abzsisse bei 1000 abgeschnitten. Danach gibt es zwar noch ein paar Balken, die sind aber so klein, dass sie vøllig irrelevant sind.

Zunaechst der Intragruppenabstand. Die Kurve fuer den kumulativen Anteil der neuen Links der UWZ (schwarz) liegt unter der Kurve fuer die UWL (hellschwarz … vulgo: grau). Das geht natuerlich nur, wenn die Seiten in der UWZ mehr (neue) Links sehen als die Seiten in der UWL. An den Histogrammen sehen wir, dass dem tatsaechlich so ist.
Ist ja auch eigentlich auch ganz klar, denn die Seiten der UWL wurden deswegen in die UWL einsortiert, weil diese 5 Links oder weniger hatten. Deswegen gibt es im Histogramm keine schwarzen Balken bei Werten mit 6 oder mehr auf der Abzsisse.
Das spielte aber bei den Seiten in der UWZ ueberhaupt keine Rolle, denn diese wurden nach der Anzahl der Zitate (0 bis 3) ausgesucht. Deswegen sind die grauen Balken ueberall zu finden und das ist entscheidend fuer den Intragruppenabstand.

Weil die UWZ Seiten (als Ensemble) signifikant viel mehr Seiten schon „ab Start“ (also LL0) sehen (das ist was obiges Histogramm u.a. aussagt), verzweigt das Linknetzwerk auf kleinen Linkleveln schneller und somit ist die kumulative Kurve bzgl. der neuen Links der UWZ ueber der entsprechenden Kurve der UWL. Das macht auch nix, dass die beiden Untergruppen unterschiedlich viele Seiten enthalten, denn die kumulativen Kurven sind ja „normiert“.

Beim Intergruppenabstandes der kumulativen Kurven bzgl. der Linkfrequenz (die rote / hellrote Kurve(n)) geht die Argumentation genau so. Die Seiten der UWZ wurden danach ausgewaehlt, dass sie 3 oder weniger Links haben (deswegen keine rosa Balken rechts davon). Fuer die Seiten der UWL war das aber kein Kriterium und im Histogramm sehen wir an den roten Balken, dass diese von mehr Seiten gesehen werden, weswegen die entsprechende kumulative Kurve der UWL høher liegt als die der UWZ.

Nun zum Intergruppenabstand. Dafuer betrachte ich nur die hellrote und die graue Kurve (eigtl. muessten alle vier Kombinationen von (hell)rot zu (hell)schwarz untersucht werden, aber das ist immer das selbe Prinzip und gibt keinen weiteren Erkenntnissgewinn).

Die hellrote Kurve entsteht dadurch, dass die Seiten der UWZ (neue) Links sehen. Die graue Kurve entsteht dadurch, dass die Seiten der UWZ von anderen Seiten zitiert werden. Im Histogramm muessen fuer den Intergruppenabstand also die Balken der Links und der Zitate der UWZ verglichen werden. Man sieht nun, dass die UWZ sehr viele graue Balken rechts von den hellroten Balken hat. Die weitere Argumentation ist dann wie Oben.

Fuer die schwarze und rote kumulative Kurve(n) ist die Argumentation qualitativ die selbe. Quantitativ muss man aber im Histogramm etwas genauer hinschauen, denn die roten Balken erstrecken sich auch rechts von den schwarzen Balken (obwohl die schwarze Kurve ueber der roten liegt). In diesem Fall sieht man aber, dass der grøszte rote Balken definitiv links vom grøszten schwarzen Balken liegt und die roten Balken rechts vom letzten schwarzen Balken sind nicht sehr hoch. All das bedeutet, dass im Durchschnitt die Seiten der UWL NICHT von mehr Seiten gesehen werden als sie (neue) Links haben. Die zwei høchsten roten Balken sagen aus, dass die meisten Seiten nur ein bzw. zwei  Mal zitiert werden, waehrend die zwei høchsten schwarzen Balken aussagen, dass viele (mglw. gar die allermeisten) der selben Seiten mindestens vier oder fuenf Links haben. Die wenigen Seiten mit mehr als fuenf Zitaten spielen da dann auch keine Rolle mehr.

Jut … das soll reichen hierzu. Beim naechsten Mal das Gleiche fuer die anderen beiden Untergruppen und mit der ganzen Vorrede hier kann ich die Diskussion dort kuerzer halten :)

Die Frage „wie vielen Links muss eine Wikipediaseite im Durchschnitt folgen um eine andere Wikipediaseite zu sehen“ wurde sowohl von der einen Richtung (ausgehend von einer Seite), als auch von der anderen Richtung (kommend von anderen Seiten) beantwortet. Beide Ergebnisse stimmen ueber alle Wikipediaseiten gesehen ueberein (zumindest so lange, wie „Mehrfachsichtungen“ die Linkfrequenz nicht zu sehr dominieren).
Andererseits wissen wir, dass nicht alle Seiten gleich sind und es stellt sich dann die Frage, ob Seiten mit vielen Links (oder Zitaten) frueher beliebige andere Seiten sehen (von anderen Seiten gesehen werden), als Seiten mit wenigen Links (oder Zitaten). Rein logisch und auch intuitiv wuerde ich das mit Ja beantworten. Das will ich aber in den Daten sehen und deswegen arbeitete ich beim letzten Mal aus, wie bspw. „wenige Links“ oder „mittelviele Zitate“ objektiv zu interpretieren sind. Die entsprechenden Seiten wurden in die sechs Untergruppen UWL, UWZ, UML, UMZ, UVL und UMZ zusammengefasst.

In den Abkuerzungen steht das „U“ fuer „Untergruppe“, „W“, „M“ und „V“ fuer „wenige“, „mittelviele“ und „viele“ und „L“ und „Z“ ensprechend fuer „Links“ und „Zitate“. Das ist leicht verstaendlich; dennoch gebe ich zwei Beispiele, denn ich werde ab sofort nur noch diese Abkuerzungen verwenden.
Die Seiten in der „UWL“ kennzeichnen sich alle dadurch aus, dass sie … in der Tabelle vom letzten Mal nachschau … null bis maximal 5 … also Wenige, Links zu anderen Seiten haben. Wieviele Zitate die Seiten in der UWL haben ist aber NICHT festgelegt (das wird an spaeterer Stelle uebrigens nochmal wichtig).
Die Seiten in der „UMZ“ kennzeichnen sich alle dadurch aus, dass sie 20 bis maximal 1000, also Mittelviele, Zitate zu anderen Seiten haben. Wieviele Links die Seiten in der UMZ haben ist NICHT festgelegt.

Nach der Vorrede kann ich ohne weitere Abschwiffe gleich das erste Ergebniss zeigen. Dieses Diagramm zeigt, wie schnell die Seiten in den Untergruppen beliebige (!) andere Seiten (also auch die der eigenen Gruppe) sehen (die Linien dienen wieder nur der besseren Visualisierungen, denn es gibt keine gebrochenen Linklevel):

Die Kurven beginnen natuerlich bei LL0 und gehen deutlich weiter als bis LL6. Von Interesse ist aber nur der Punkt, an dem die Seiten in den Untergruppen (als (Untergruppen)Ensemble gesehen) im Durchschnitt die Haelfte aller Seiten gesehen haben. Zur Erinnerung: wenn man alle Seiten zusammen betrachtet, lag dieser Uebergang zwischen dem 3. und 4. Linklevel (aber etwas naeher an LL3 als an LL4).
Es gibt natuerlich kein „zwischen“ zwei Linkleveln. Das ist so zu verstehen, dass im Durchschnitt bis LL3 die meisten Seiten noch NICHT 50 % aller anderen Seiten gesehen haben, waehrend auf LL4 die meisten Seiten (im Durchschnitt) sehr wohl 50 % aller anderen Seiten gesehen haben.
„Naeher an LL3“ ist so zu verstehen wie der Ordinatenwert fuer diese Stelle ist: bis dahin wurden (im Durchschnitt) fast 40 % aller anderen Seiten schon gesehen. Es sollten also bereits merkbar viele Seiten auftreten (aber noch nicht die Mehrzahl), bei denen (im uebetragenen Sinne) bereits ein Muenzwurf ausreicht um zu entscheiden ob (im Durchschnitt) eine beliebige andere Seiten gesehen wurde oder nicht. Waehrend die ueber 80 % auf LL4 bedeuten, dass das Ensemble aller Seiten diesbezueglich einen riesigen Schritt gemacht hat und nun die Mehrzahl der Seiten (im Durchschnitt) vier von fuenf beliebigen andere Seiten gesehen hat.

Hier nun sehen wir zwei wichtige Dinge:
1.: die Ergebnisse fuer die Gruppen (wenige, mittelviele, viele Links / Zitate) unterscheiden sich wie erwartet; Seiten mit mehr Links sehen eine beliebige andere Seite eher als Seiten mit weniger Links. Das war erwartet (siehe oben). Dennoch freut es mich, dass die Unterschiede so deutlich sind … ich waere etwas ratlos gewesen, wenn dem nicht so gewesen waere.
2.: die Ergebnisse fuer die der paarweisen Untergruppen liegen nahe genug beisammen, sodass ich das als „das ist innerhalb des Fehlers gleich“ betrachten, und zunaechst nicht auseinanderklamuesern muss. Man sieht zwischen den paarweisen Untergruppen kleine Unterschiede (am grøszten sind die fuer die zwei Gruppen mit den wenigen Links / Zitaten), aber darauf gehe ich an anderer Stelle ein.

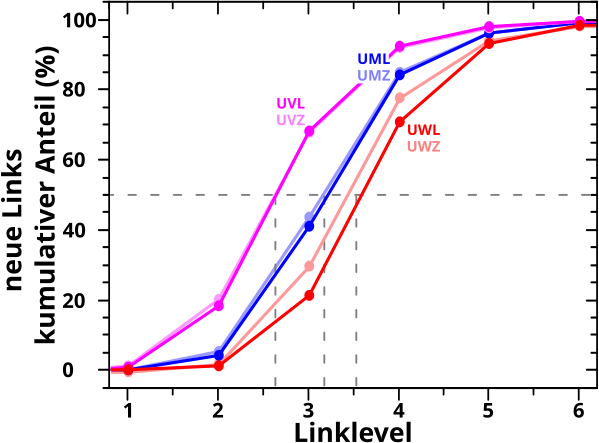
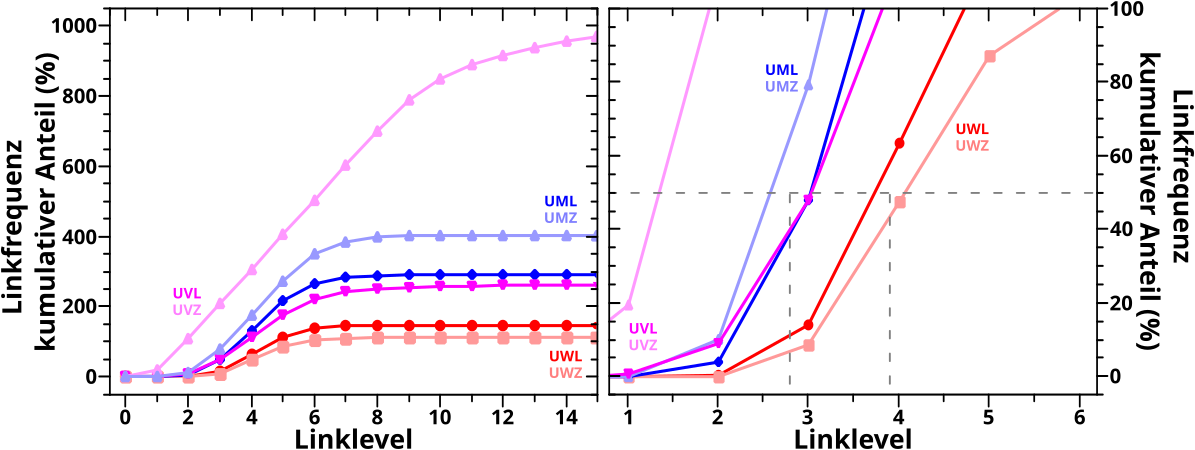
Prima! Nun andersrum: wie schnell werden die Seiten der Untergruppen von anderen Seiten gesehen:

Im linken Diagramm zunaechst eine „grøbere“ Uebersicht um zu zeigen, dass die Untergruppen bzgl. des kumulativen Anteils jeweils høhere „Schlussprozente“ erreichen. Zur Erinnerung: ueber alle Seiten gesehen wird im Durchschnitt ueber das gesamte Linknetzwerk aller Seiten jede Seite fast 2 1/2 Mal von jeder anderen Seite gesehen.
Fuer die Untergruppen war zu erwarten, dass die nach der Anzahl der (von anderen Seiten erhaltenen) Zitate sortierten Gruppen auch entsprechend høhere Schlussprozente haben. Ist ja logisch, eine Seite die nur ein Mal zitiert wird, wird letztlich auch nur ein Mal von allen anderen Seiten gesehen (wenn auch vermutlich auf unterschiedlichen Linkleveln). Eine Seite die 1000 Zitate von anderen Seiten erhaelt hat hingegen eine (hohe) Chance im Linknetzwerk einer Urpsrungsseite mehrfach aufzutreten und wird somit mehrfach von jeder (Ursprungs)Seite gesehen. Dieses Phaenomen spiegelt sich in den „Schlussplateaus“ der hellfarbigen Kurven im linken Diagramm wider.

Das gleiche Verhalten ist ebenso im Durchschnitt der Untergruppen zu erwarten, die nach der Anzahl der Links sortiert wurden. Zur Erinnerung: (im Durchschnitt!) gibt es (wie wir seit langem wissen) einen Zusammenhang zwischen der Anzahl der Links und der Anzahl der Zitate, welche mittels eines maechtigen Gesetzes mit positivem Exponenten beschrieben werden kann. Das bestaetigt sich in der (normal) roten und (normal) blauen Kurve.
Fuer die (normal) lila Kurve, also die Seiten der UVL, gilt dies jedoch nicht. Das ist ein wichtiger Unterschied und ich komme darauf an anderer Stelle zurueck.

Im rechten Diagramm zeige ich den hier und heute interessanten Bereich von Nahem. Von den Ergebnissen fuer die UVL abgesehen gilt i.A. das Gleiche was ich bzgl. den Ergebnissen zum kumulativen Anteil der neuen Links sagte. Die Unterschiede sind deutlich zu sehen und verhalten sich wie erwartet. Paarweise gesehen sind die Kurven fuer die UWL / UWZ bzw. UML / UMZ zwar nicht so schøn beisammen wie beim kumulativen Anteil der neuen Links aber hier und heute sind mir die Diskrepanzen klein enug genug um das innerhalb des Fehlers als das Gleiche zu betrachten. Letzteres gilt wie gesagt fuer die UVL und UVZ nicht.

Somit ist fuer heute festzuhalten: Seiten die bestimmten Untergruppen zuzuordnen sind, verhalten sich anders und die Andersartigkeit ist i.A. wie erwartet.
Nichtsdestotrotz gibt es unerwartete Unterschiede die erklaert gehøren. Das dauerte eine Weile bis ich die Erklaerung beisammen hatte und ist das was ich in diesem Beitrag schon mehrfach andeutete. Mehr dazu beim naechsten Mal.