Hier …

… bin ich auf Greae Hypa PH-C d1017 2, denn von allen (!) Planeten auf denen man landen kann hat dieser den grøszten Radius mit 28,877.854 km. Das ist natuerlich auch am grøszten fuer diesen Planetentyp — Icy bodies (wo mein Bordcomputer mir erlaubt zur Oberflaeche zu fliegen).

Ein solch riesiger Radius fuehrt (wie gewøhnlich) zu einer hohen Gravitation (aber kein Rekord in diesem Fall) und einer Pfannkuchenoberflaeche … ich meine die Bodenerhebungen und nicht die Farbe … aber die passt hier auch.

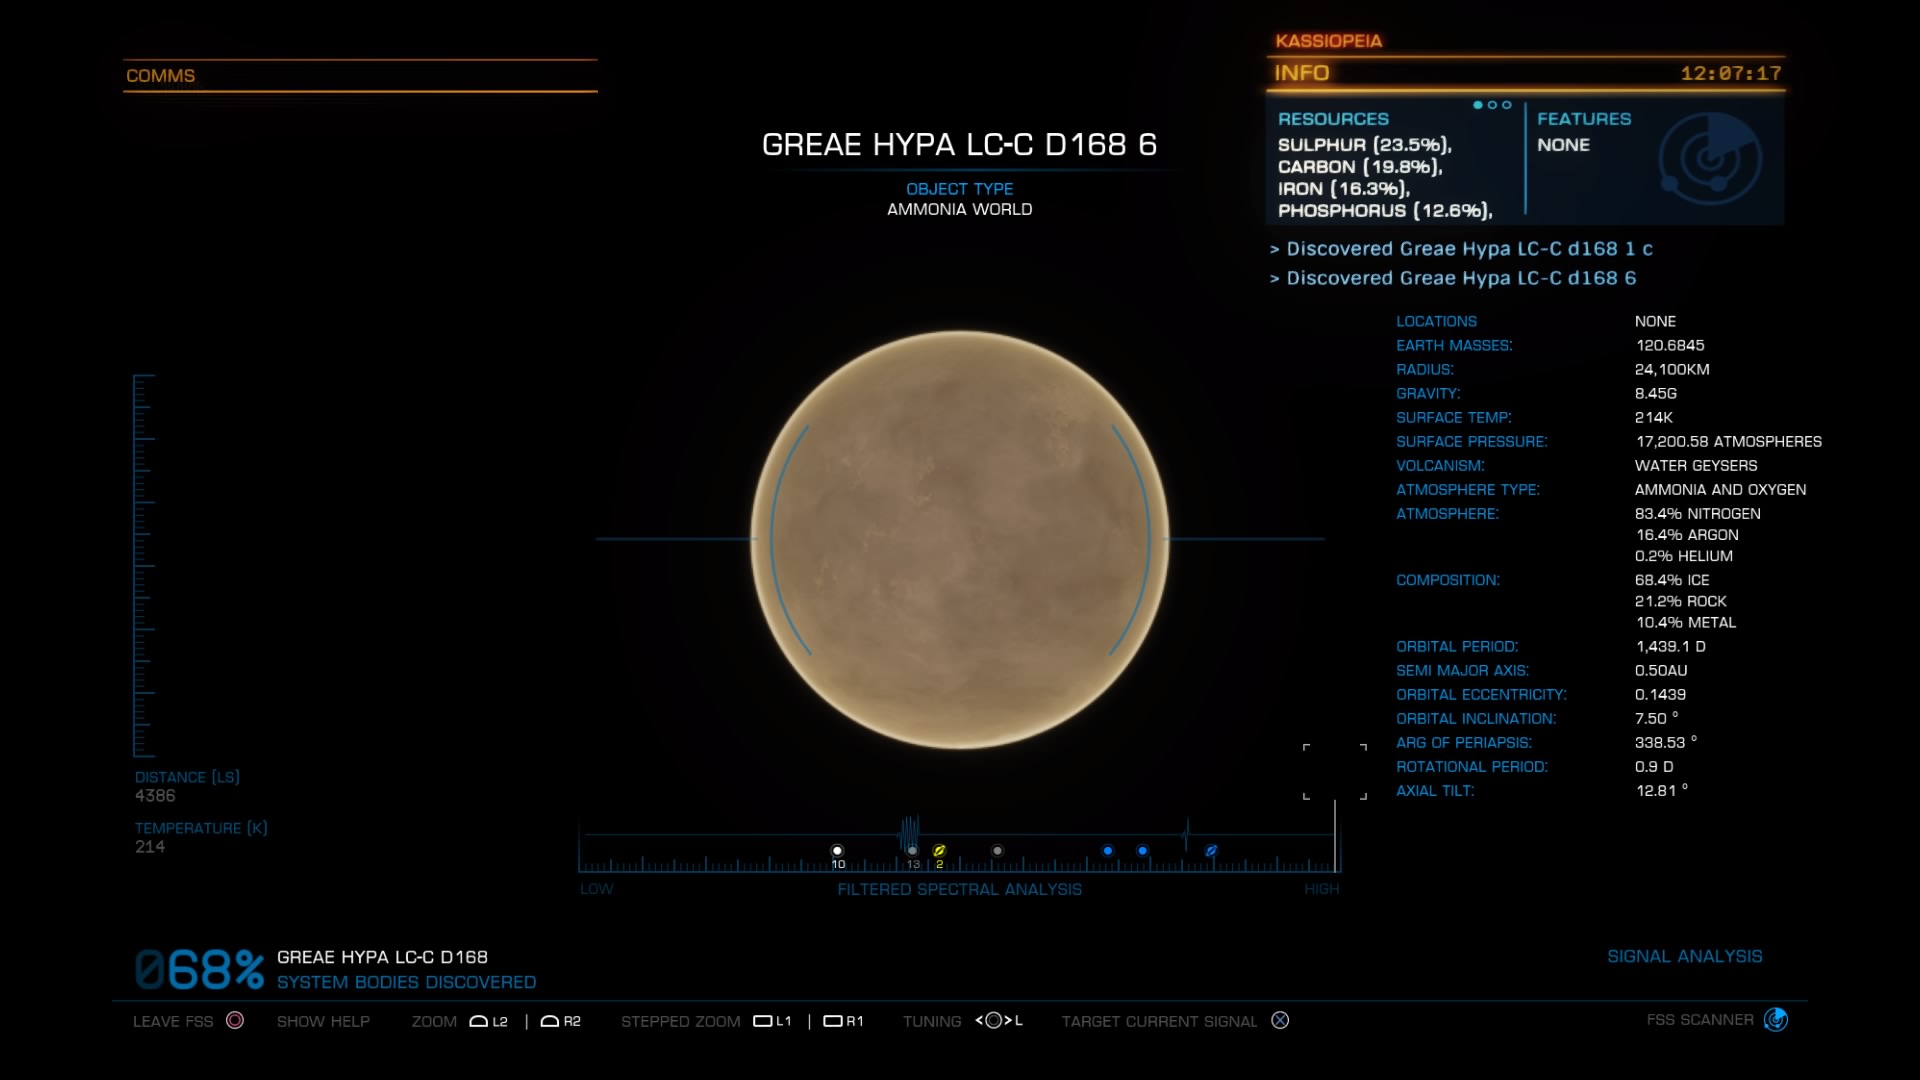
Ansonsten fand ich auch noch Ammoniakwelt #182:

Beim letzten Mal beschrieb ich die Umwandlung des urspruenglichen Sprachproblems in ein mathematisches Problem. Damit kann man prinzipiell so wie’s ist (von Apfel zu Kuchen zu Mehl usw.) an die Sache heran gehen.
Wir sprechen hier aber von fast 6 Millionen Knoten (Wikipediatiteln) und mehr als 181-Millionen Verbindungen dazwischen in diesem Netzwerk. Und fuer jeden Knoten muss ich die Gesamtheit der Verbindungen „abschreiten“. Dabei lief ich in ein albekanntes Problem: nicht genug Speicher! Aber der Reihe nach.

Vor ein paar Monden hørte ich mit der Saeuberung der Rohdaten auf und es blieben noch …

[…] 5,798,312 Wikipediaseiten auf denen insgesamt 165,913,569 Links erscheinen […]

… zurueck.

Ich schrieb auch, dass der Speicherbedarf dieser Daten von ehemals ueber 70 GB (die gesamte Wikipedia) auf 4.1 GB verringert wurde. Ich hatte das auf 61 Dateien verteilt und die bin ich fuer die bereits vorgestellten Untersuchungen immer der Reihe nach durchgegangen (denn da hat mich ja das Netzwerk an sich nicht interessiert).
Das Komische war nun, dass das eigentlich alles in den Speicher meines Laptops passen sollte … aber irgendwie kam dieser nicht zurecht, wenn ich versuchte mehr als 10 dieser Dateien gleichzeitig zu laden.

Merkwuerdig … wie sieht das denn eigentlich im Speicher aus?
Nunja, erstmal dachte ich ganz einfach, dass die Titel der Seiten Buchstabenketten (allgemeiner: Zeichenketten) mit einer bestimmten Laenge sind. Dito bzgl. der Links „hinter“ jedem Titel.
Im Wesentlichen braucht ein Buchstabe im Speicher 1 Byte … jaja, Sonderzeichen brauchen mglw. mehr, aber ich sollte davon nicht soooo viele haben … Der Speicherbedarf der Titel sollte also das Integral ueber die hier gezeigte Verteilung sein: 117,194,976 Bytes also ca. 117 MB.
Die Verteilung der Laengen der Links ist sehr aehnlich:
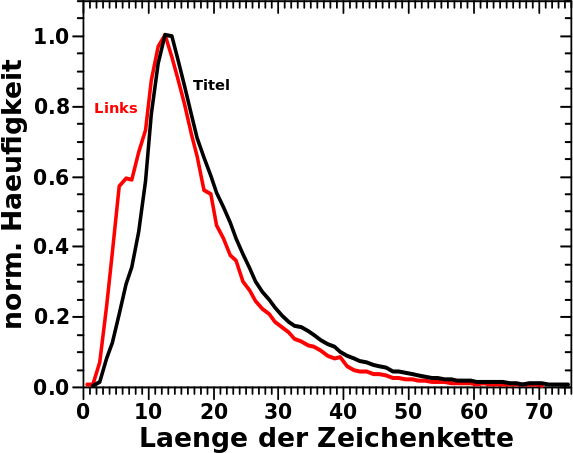
In den nicht normierten Daten ist die Amplitude der Verteilung der Links natuerlich viel grøszer und diese muss natuerlich fuer das Integral genommen werden.
Nebenbemerkung: das kleine „Uebergewicht“ bzw. „Untergewicht“ links bzw. rechts vom Maximum ist sicherlich dadurch zu erklaeren, dass „prominente“ (also oft zitierte) Seiten einen kurzen und knackigen Titel haben — siehe hier. Der Unterschied ist zwar zu sehen, aber nicht so massiv (oder unerwartet), sodass ich mich da nicht weiter fuer interessiere. Insb. auch deswegen nicht, weil die gegebene Erklaerung (mit den Beispielen der meistzitierten Seiten) durchaus plausibel klingt.

Fuer den Speicherbedarf aller in den Links enthaltenen Zeichen errechnete ich nun: 2,898,076,329 also ca. 2.9 GB.

Na sowas! Meine simplen Ueberlegungen løsen die Merkwuerdigkeit nicht auf!
Des Raetsels Løsung ist zweigeteilt und ich gebe zu, dass das ueber das Anfaengerprogrammiererniveau hinaus geht (wenn auch nicht sehr weit). Aber dafuer muss ich etwas ausholen. Das wiederum handelt im vorbeigehen auch gleich etwas ab, was beim naechsten Mal total hilft :) .

Nehmen wir die Zeichenkette „gerader Strich mit kurzer Kappe, zwei mal zwei nach links offene Halbkreise, schraeger Strich mit Vordach“ — oder in kurz 1337.
Ich nehme 1337 mit Absicht. Zum Einen ist es natuerlich die Zahl Eintausenddreihundertsiebenundreiszig. Dann es aber auch das bekannteste Beispiel fuer Leetspeak und wird eben auch direkt als „LEET“ — also ein Wort — interpretiert.
Ein und die selbe (!) Zeichenkette hat also zwei unterschiedliche Bedeutungen. So wir denn von diesen Unterschieden wissen, so ist das fuer uns Menschen i.A. kein Problem 1337 kontextabhaengig richtig zu interpretieren. Wenn ich also sage packe bei 1337 nochmal 1337 ran, so ist das eine Addition im Falle der Zahl und das Ergebnis wird 2274 bzw. wird is im Falle des Wortes 13371337 (also LEETLEET).

Damit bin ich bei einem weiteren wichtigen Aspekt: Operationen.
Abhaengig von der Bedeutung die die Zeichenkette hat, kann man damit unterschiedliche Operationen ausfuehren oder gleiche Operationen, die aber unterschiedliche Ergebnisse haben. Oben erwaehnte ich die Addition. Eine andere Operation waere „Sag mir mal die Laenge von dem was ich gerade vor mir habe“.
Bei LEET entspricht die Laenge natuerlich der Anzahl der Zeichen und ist somit vier. Aber selbst wenn eine Zahl viele Zahlzeichen enthaelt, so ist die Laenge einer Zahl doch immer eins! Das ist besser zu verstehen, wenn man rømische Zahlsymbole nimmt, denn da sind 10, 50, 100, 500 und 1000 nur ein Symbol. Noch cooler ist das cistercianische Zahlsystem, welches bis 9999 immer nur ein Symbol braucht.

Das alles weisz man „automatisch“ als Mensch, aber dem Computer muss man zu jeder Zeichenkette sagen, was die jetzt eigentlich fuer eine Bedeutung hat, damit die richtigen Operationen drauf ausgefuehrt werden. Und hat eine Zeichenkette erstmal eine Bedeutung, so aendert die sich niemals … … … jaja, ich weisz, dass es da Spezialfaelle gibt, die Ausnahmen zu dieser Aussage sind … aber mir geht’s hier darum, dass man einem Computer explizit und jedes Mal sagen muss, womit dieser eigentlich gerade arbeitet.
Das ganze geht natuerlich noch viel tiefer direkt rein in die Innereien des Computers. Denn eine Zahl ist im Speicher ganz anders dargestellt als ein Wort.

Worauf ich hinaus will ist das Folgende. Jedes Objekt im Program (also meine Zeichenketten) hat „Betriebskosten“ in Form von Speicherplatzbedarf wo eben die Bedeutung des besagten Objektes abgelegt ist. Diese „Betriebskosten“ beinhalten das was ich oben sagte, damit der Computer weisz, wie mit besagten Objekten umzugehen ist. Interessiert bin ich aber nur an der „Ladung“ eines Objektes; also der Zahl oder dem Wort an sich. Diese „Ladung“ kommt zu den „Betriebskosten“ hinzu.

Um die „Betriebskosten“ kommt man niemals drumherum und es gibt nun zwei Møglichkeiten, wie man das handhaben kann. Zentral oder dezentral.
Zentral bedeutet, dass man eine gewisse Menge Speicherplatz reserviert und ranschreibt welche Bedeutung alle Objekte die sich darin befinden haben. Dann muss man das nur einmal sagen und die „Betriebskosten“ fallen nur einmal an.
Dezentral bedeutet, dass man das an jedes einzelne Objekt ranschreibt. Dann fallen die „Betriebskosten“ fuer jedes Objekt an. Warum sollte man das machen? Naja, dafuer gibt es technische Gruende, und mindestens einen eher philosophischen Grund: um dem Menschen der das Programm schreibt die Arbeit zu erleichtern. Denn das ist genau das was Python macht. Speicher- und Objektmanagement sind Dinge, die man in anderen Programmiersprachen explizit machen muss. Ich finde das durchaus interessant, aber ich gebe zu, dass es vom eigentlichen Programmieren (sich logische Strukturen ueberlegen, die ein gewisses Problem løsen) abhaelt, wenn man das „Inventar“ immer „sortieren und sauber halten“ muss.

Und das ist das was ueber das Anfaengerprogrammiererniveau zumindest unter Python hinausgeht. „Anfaengerprogrammiererniveau“ deswegen, weil Python heutzutage nunmal die Sprache ist, in der mglw. die allermeisten Leute anfangen zu programmieren. Und die fangen damit an, eben weil da solche Sachen im Hintergrund passieren  und vom Menschen der den Code schreibt weg gehalten werden.
Es ist aber natuerlich auch Grund, warum Python nicht fuer die Programmierung wirklich groszer Programme (wie bspw. Betriebssysteme) benutzt wird. Hat halt alles seine Vor- und Nachteile.

Soweit dazu. Den Speicherbedarf der „Ladung“ habe ich oben berechnet. Aber wie grosz sind denn nun die „Betriebskosten“ pro Zeichenkette? Nun ja, das ist kompliziert und nicht nur von der Architektur des Rechners und Betriebssystems, sondern auch der benutzten Inkarnation der Programmiersprache abhaengig. Unter Python 3.7.3 auf meinem Rechner belaufen sich besagte „Betriebskosten“ von Zeichenketten auf 49 Byte pro Objekt. (Unter Python 2.7.16 sind es uebrigens nur 37 Byte).
Da wir 5,798,312 Wikipediaseiten und 165,913,569 Links haben kommen zu den obigen ca. 3 GB also nochmals 8,413,882,169 Byte hinzu. Eigentlich ein bisschen mehr, weil Sonderzeichen høhere „Betriebskosten“ haben, aber in der Summe sind das dann ungefaehr 11 GB.

Mhm … 11 GB das wird zwar knapp, aber so viel habe ich eigentlich. Warum kommt der Computer aber schon nicht mehr klar, wenn ich nur 10 Dateien eingelesen habe?
Ohne lange Rede: die Links sind in Sets (das ist sowas wie ’ne Liste ohne doppelte Objekte) angeordnet und davon habe ich natuerlich pro Titel eins. Insgesamt ist dann alles in einem einem sogenannten „Dictionary“ sortiert, damit ich zu jedem Titel leicht die zugehørigen Links finde (wie eben in einem Lexikon). Solche uebergeordneten Strukturen haben natuerlich auch Betriebskosten zusaetzlich (!) zu denen der einzelnen Elemente die in diesen Strukturen „aufbewahrt“ werden. Aber anders als bei den „primitiven“ Objekten wie oben beschrieben steigen die Betriebskosten in Abhaengigkeit von der Anzahl der Elemente die sich darin befinden. Klar, der gesamte Speicherbedarf eines Wortes ist abhaengig von der Anzahl der Buchstaben, aber das ist die „Nutzlast“. Die „Betriebskosten“ des Wortes sind davon unabhaengig. Und das ist bei den uebergeordneten Strukturen anders (weil die komplizierter sind und auch kompliziertere Operationen erlauben).

Zur besseren Veranschaulichung stelle man sich einen Gueterzug der Farbe transportiert vor. Alle Links die zu einem Titel gehøren entsprechen einer Farbe. Besagte Sets sind dann ein Tankwaggon, die jeweils nur eine Farbe enthalten. Wenn ich mehrere Tankwaggons habe, dann fallen die Betriebskosten (Wartung, oder Versicherung) pro Stueck an. Habe ich weniger Farbe, benutze ich einen kleineren Tankwagon, der geringere Kosten hat. Die Lokomotive (welche wiederum Betriebskosten hat) nun zieht alle Tankwaggons. Habe ich nur ein paar, benutze ich eine kleinere Lokomotive (mit geringeren Kosten), als wenn der Gueterzug so lang ist wie in Sibirien.

Und der Speicherbedarf dieser uebergeordneten Strukturen entwickelt sich selbst ohne die „Nutzlast“ dramatisch! Die „Waggons“ in denen sich die Links befinden benøtigen in ihrer kleinsten Form (also ohne Nutzlast, wenn ein Titel keine Links enthaelt) bereits 224 Bytes. Bei den ca. 6 Millionen Titeln macht das also mindestens (!) nochmal 1.3 GB. Und nun kommen wir in Regionen, wo mir der Speicher ausgeht.

Aber eigentlich braucht die Anordnung in Sets deutlich mehr, denn beim Maximum der Verteilung bzgl. der Anzahl der Links pro Titel, beansprucht ein Set bereits 736 Bytes Speicherbedarf an „Betriebskosten“. 736 Bytes braucht ein Set auch dann, wenn es 18 Elemente hat, aber ab 19 Elementen braucht es 2272 Bytes. Insgesamt sieht das dann so aus:
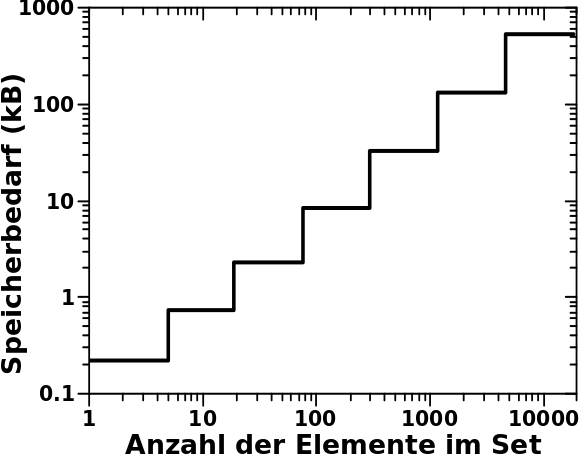
Puuuuh … das geht linear, nochmal Glueck gehabt … … … Oopsie, das sind ja doppeltlogarithmische Achsen! … … … Ach du meine Guete! Der Anstieg ist ja positiv! Damit wird ja der Exponent des maechtigen Gesetzes grøszer Null!

Lange Rede kurer Sinn: die vormals betrachtete, oben verlinkte, Verteilung der Anzahl der Links fuer alle Titel muss mit dem hier dargestellten Speicherbedarf _multipliziert_ werden. Das sieht dann so aus:
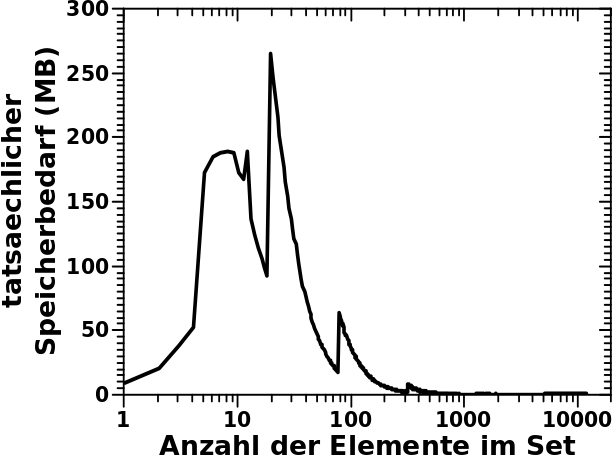
Mist! Die Ordinate ist linear und in Megabyte.

Erst jetzt ergibt das Integral unter dieser Kurve den tatsaechlichen Speicherbedarf dieser Ueberstruktur von Sets welche besagte Links enthalten: 10,962,695,936 Byte also ca. 11 GB die zu den obigen 11 GB noch dazu kommen. So viel Speicher habe ich nicht. Die „Lokomotive“ (das „Dictionary“), also die oberste Ordnungsstruktur, braucht dann bei ca. 6 Millionen Elementen nochmals 300 MB. Aber das faellt dann kaum mehr ins Gewicht.

Ich fasse zusammen. Der Speicherbedarf der eigentlichen „Buchstaben“ aller Titel und Links betraegt nur 3 GB. Aber die Verwaltung all dieser Buchstabenobjekte verursacht (in Python) „Betriebskosten“ von 8 GB. Die Strukturen in der die ganzen Objekte nun zusammengefasst sind verursacht dann nochmals „Betriebskosten“ in Høhe von weiteren 11 GB.
Kein Wunder, dass mein Computer da keine Lust drauf hat.

Wie ich dieses Problem løste stelle ich beim naechsten Mal vor. Denn die Løsung ist echt cool (weil so elegant) und erlaubte mir ueberhaupt erst das Gesamtproblem (die Erforschung des Linknetzwerkes) derart umzuformulieren, dass ein Computer das (schnell) løsen konnte.

Ach so … wenn ich hier 22 GB zusammenrechne, wie komme ich denn auf die 4.1 GB, die ich ganz oben erwaehne. Nun ja, wenn ich das alles auf der Festplatte speichere, dann wird die Struktur serialisiert. Dabei werden strukturierte Daten in einen seriellen Datenstrom „umgewandelt“ fuer die Speicherung. Darauf kann ich dann natuerlich nicht arbeiten.
Ich kønnte mir denken, dass viele von den „Betriebskosten“ gespart werden kønnten, indem man einen Teil des seriellen Datenstroms bspw. als „ab hier keine Zahlen sondern nur Wørter“ definiert (anstatt das fuer jedes Wort einzeln zu machen). Wenn das wieder zurueck „uebersetzt“ (de-serialisiert) wird, dann sieht der Algorithmus das und „baut“ daraus die richtigen Wortobjekte.
Aber das sollte alles als Spekulation gesehen werden, denn ich habe eigentlich gar keine Ahnung was da wirklich passiert.
Ich beschwerte mich die letzten paar Peanuts-Jahre, dass die Strips Routine geworden sind.

Zu meinem Erstaunen gab es aber doch noch ein paar Enwicklungen. Eher negativ war, dass Snoopy etwas „schrullig“ zu werden schien. Das fand ich eher schade. Mein Eindruck war in den ersten Jahrzehnten doch eher, dass dies der einzige Erwachsene in der ganzen Serie ist. Aber in einer Weise die sehr gut passt, denn er war ein Erwachsener, der sich ueberhaupt nicht kuemmerte, was „die Leute“ denken møgen, wenn er Freude am Leben hat und „Kinderkram“ macht.

Als jemand der „zu alt“ ist fuer Comics, Lego, Videospiele, (Wasser)Rutschen etc. pp. hat mich das natuerlich angesprochen.

Eine positive Enwicklung war aber bzgl. des Charakters der Peppermint Patty im letzten Jahrzehnt der Peanuts zu sehen. Sie ist natuerlich nicht komplett veraendert worden, aber ihr Charakter wurde doch sehr viel nuancierter. Und auf eine gewisse Art und Weise (nur eben anders) hat sie „Teile von Snoopy“ uebernommen. Nicht den Teil des „einziger Erwachsener in der Serie“. Ich meine vielmehr, dass es auch sie nicht kuemmert was „die Leute“ denken, wenn sie Freude am Leben, auch auszerhalb gesellschaftlicher Normen (als Maedchen das sog. „Jungskram“ macht). Das war zwar immer schon da, aber nun war es nicht mehr nur „schrullig“ sondern „ernsthaft“ … wie gesagt, in gewissem Sinne eine umgekehrte Entwicklung im Vergleich zu Snoopy.

Daraufhin aenderte sich meine Einstellung bzgl. dieses Charakters komplett … aber das hatte ich ja frueher schonmal angesprochen.

Und Marcy war eh schon immer fetzig … Sie ist uebrigens eins von zwei Maedchen die Hosen tragen. Das andere ist (natuerlich) Peppermint Patty.

Ausgehend von Kevin Bacon war der urspruengliche Plan das Linknetzwerk der Wikipedia zu untersuchen.
Dies ist im Grunde ein universelles (im Sinne von Universum) Problem — Die Beziehung von Informationen zueinander. Das habe ich dann gleich erstmal massiv auf Erdwissen eingeschraenkt welches sich in der (westlichen) Wikipedia befindet. Damit konnte ich das universelle Problem auf ein Sprachproblem reduzieren.
Das war aber immer noch zu viel, denn die Texte enthalten unheimlich viel Information, die im Sinne der Fragestellung „unbrauchbar“ ist. All das habe ich weggeschmissen und zurueck blieben die Titel von Wikipediaseiten und welche anderen Wikipediaseiten diese zitieren.

Das Wichtige an einem solchen Netzwerk sind nun aber nicht die Anzahl der „Knotenpunkte“. Ein Elefant hat deutlich mehr Neuronen als ein Mensch und dennoch sind es Fuszstapfen des Homo Sapiens auf dem Mond.
Nebenbemerkung: Gehirne sind urst krass kompliziert; bspw. haben grøszere Tiere im Allgemeinen auch grøszere Neuronen (die brauchen also mehr Platz). Und auch die Struktur des Gehirns (die Runzeln) oder in welchem Teil des Gehirns sich die Neuronen befinden ist wichtig. Und ich tu mal so, als ob es Vøgel nicht gibt.

Ganz generell ist also nicht die Menge der Knoten ausschlaggebend, sondern wie viele Verbindungen es zwischen den Knoten gibt. Selbst wenn ueber das Netzwerk jeder Punkt erreicht werden kann, so dauert es laenger, je mehr „Zwischenstops“ bei anderen Knoten man unterwegs einlegen muss. Oder anders gesagt: wer schaut sich schon die zweit oder gar dritte Seite mit den Sucherergebnissen an?
Diese Anzahl der Schritte bezeichnete ich am Anfang der Serie als „Linklevel“.

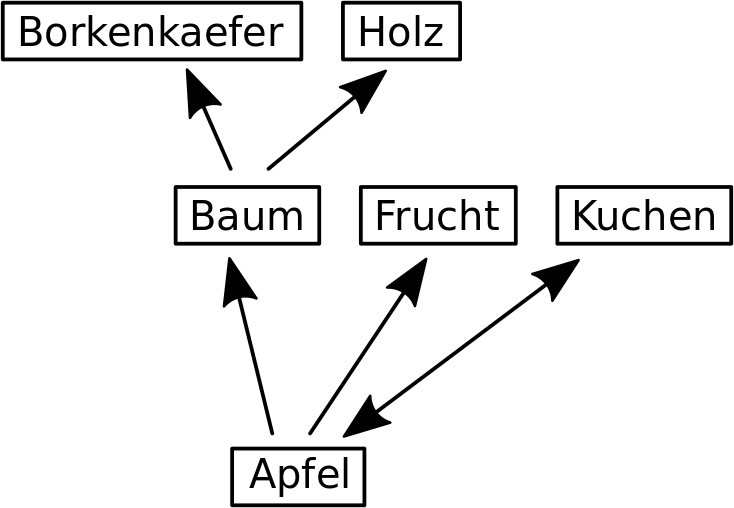
Zur Veranschaulichung nehme man dieses ausgedachte Beispiel:

Von Apfel (Linklevel 0, da das der Ursprung ist) komme ich direkt zu Baum, Frucht und Kuchen. Von Apfel aus gesehen liegen diese drei also auf Linklevel 1. Im Beispiel geht das Netzwerk bei Frucht nicht weiter. Von Baum aber geht es zu Borkenkaefer und Holz. Diese Beiden liegen von Apfel aus gesehen auf Linklevel 2 und von Baum aus gesehen auf Linklevel 1. Letzteres ist (erstmal) nicht von Interesse, denn hier interessiert uns nur Apfel und Baum wird separat untersucht.
Kuchen verweist nun zurueck auf Apfel. Das ist das, was ich spaeter „Selbstreferenz“ nennen werde, denn das ist ja prinzipiell auch von Interesse: wie entwickelt sich die Selbstreferenz je „weiter“ man weg ist vom Urpsrung? Natuerlich liegt fuer Kuchen der Apfel ebenso auf Linklevel 1 und via Apfel erreicht man dann von Kuchen aus die anderen Elemente (nur jeweils ein Linklevel høher). Auch dies wird in der Analyse separat betrachtet; ich erwaehne das nur, weil das aus dem Beispiel „heraus faellt“.

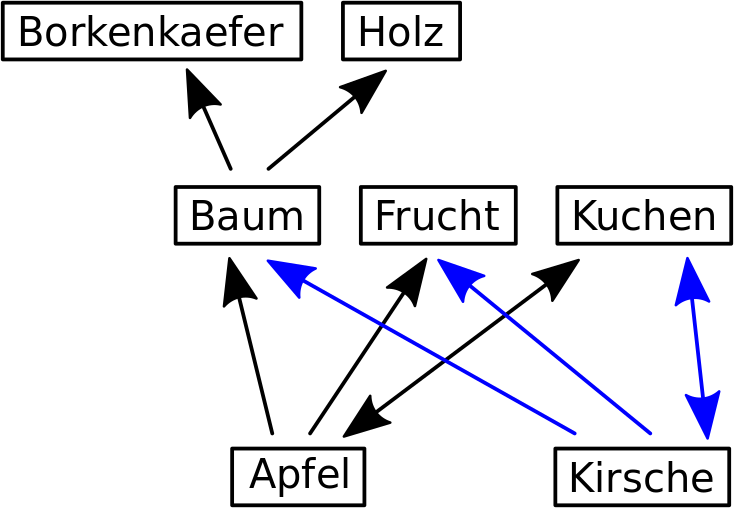
In einem zweiten Beispiel kommt Kirsche hinzu:

Das ist das Gleiche wie bei Apfel, nur von Kirsche aus gesehen ist Apfel auf dem selben Linklevel wie Holz (Linklevel 2) denn diese beiden „kommunizieren“ via den Knoten Kuchen. Umgekehrt gilt das natuerlich genauso.
Ich erwaehne dies, weil das Linknetzwerk absolut das Selbe (!) ist, trotzdem ein anderer Knoten als Ursprung genommen wurde.

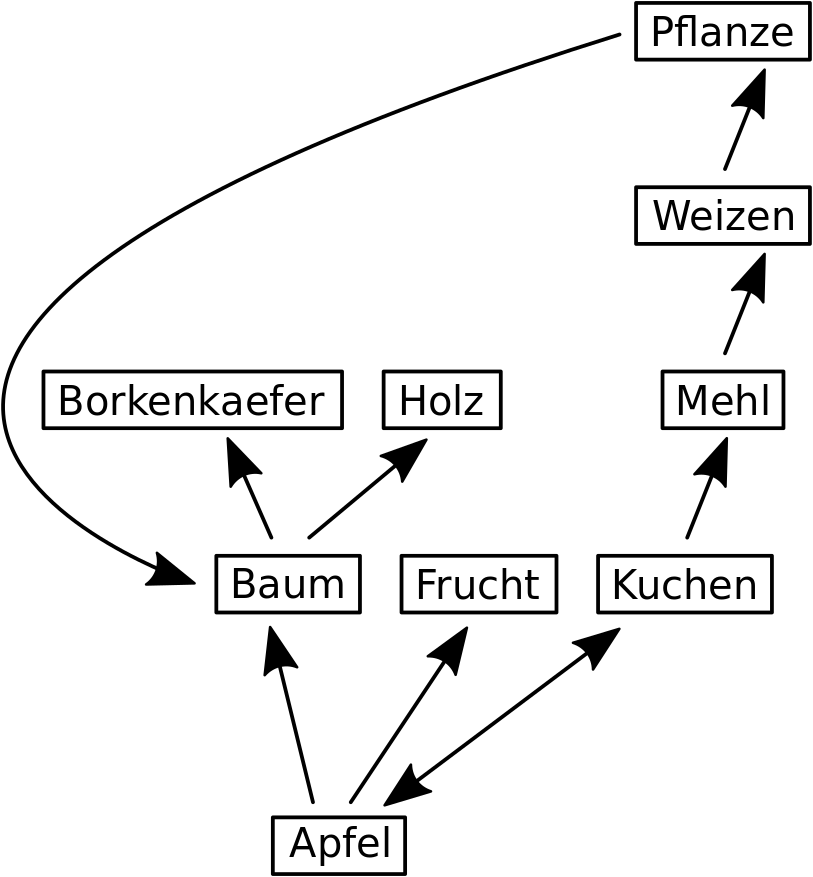
Jetzt noch ein drittes Beispiel:

Von Apfel komme ich via Kuchen, Mehl und Weizen zu Pflanze. Von Pflanze komme ich dann zurueck zu Baum. Damit wuerde Baum (von Apfel aus gesehen) auf Linklevel 1 und Linklevel 5 liegen. Das wird aber ignoriert, weil ich sonst in Schleifen gerate, aus denen ich nicht heraus komme. Dadurch, dass Baum bereits auf Linklevel 1 „besprochen“ wurde ist das auch gerechtfertigt denke ich.

Ich habe das aus zwei Gruenden (nochmals) so ausfuehrlich beschrieben. Zum Einen, um nach all den vorhergehenden Analysen und Diagrammen das urspruengliche Problem wieder in Erinnerung zu rufen. Zum Anderen sieht man hieran, dass ich das Sprachproblem „mathematisieren“ konnte. Denn wie man an den Beispielen sieht, faellt das Kevin-Bacon-Problem in das Gebiet der Graphentheorie.
Von Letzterer habe ich keine Ahnung. Das hindert mich aber nicht daran, ganz praktisch und pragmatisch an die Sache heran zu gehen und eine Løsung zu finden, die gut genug fuer das ist, was ich eigentlich wissen will.

Damit genug fuer heute.

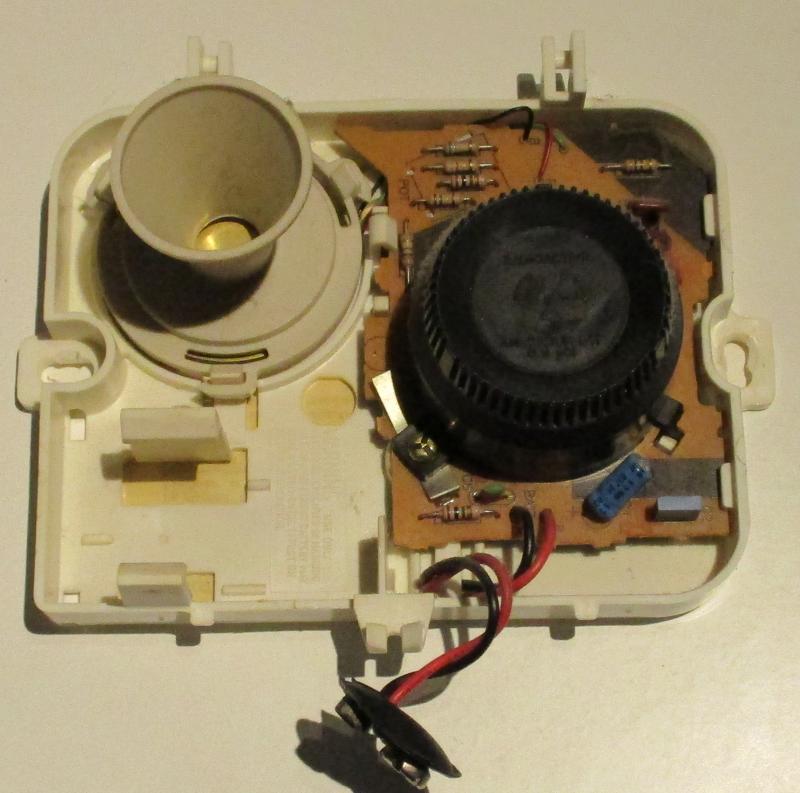
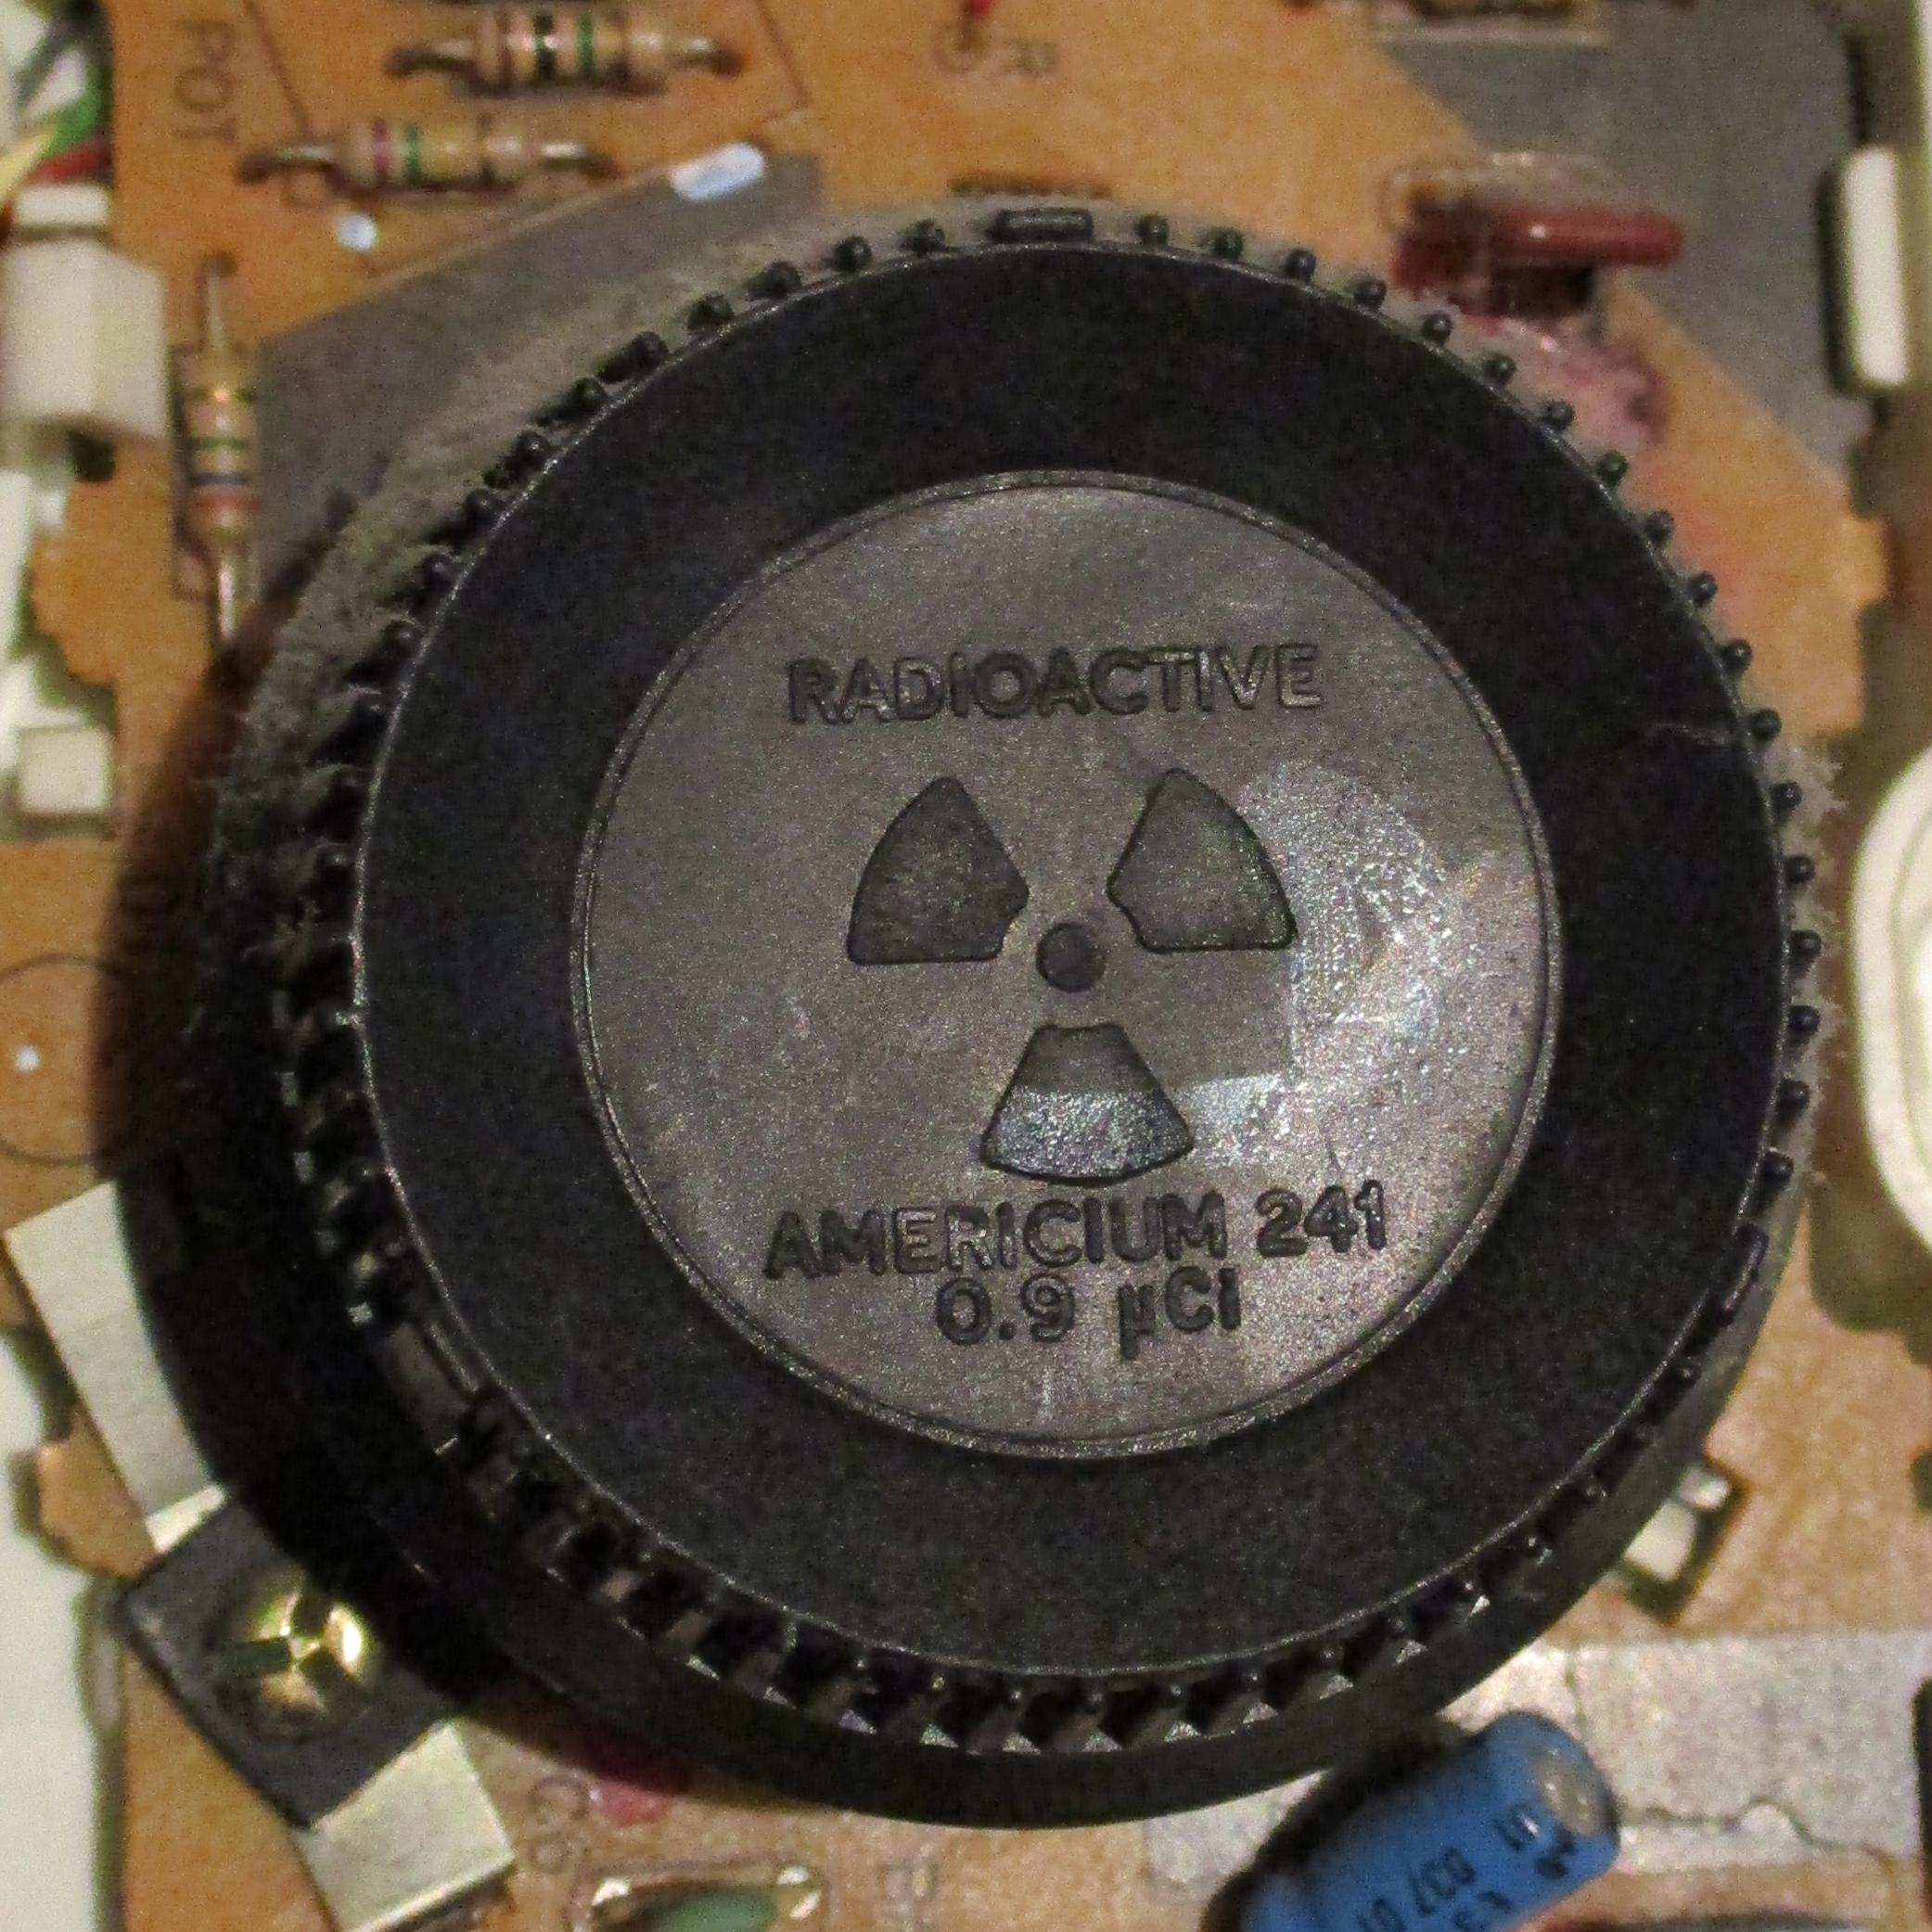
… ist Americium und dessen Isotop 241Am wurde oft in Ionisationsrauchmeldern verwendet. Und so einer ist hier zu sehen:

Aufgrund offensichtlicher Gruende werden diese Art von Rauchmeldern heutzutage abgeløst durch rein optische Systeme.
Unwissend und arrogant wie ich mal war (vulgo: Alterweisheit liesz noch auf sich warten), machte ich mich frueher lustig ueber Leute, die vor „dem Atom“ Angst hatten. Aber die massenhafte Verbreitung von „solchen Atomen“ fuehrt doch unnøtige, (heutzutage) vermeidbare Risiken mit sich. Die geneigte Leserin oder der geneigte Leser møge sich nur mal den kurzen Abschnitt „Problematik“ im verlinkten Artikel anschauen.

Ich gebe aber zu, dass historisch gesehen ganz sicher viele Menschenleben durch diese Technologie gerettet wurden. Heutzutage geht das aber auch ohne 241Am.
Wieauchimmer, obiger Rauchmelder ist kaputt und deswegen habe ich den mal aufgemacht und mich begrueszte (verstaendlicherweise) dieses bekannte Symbol:

Trotz Allem, schon cool wa! … Dennoch keine Sorge, denn ich werde nicht in den Fuszstapfen dieses Individuums folgen ;)

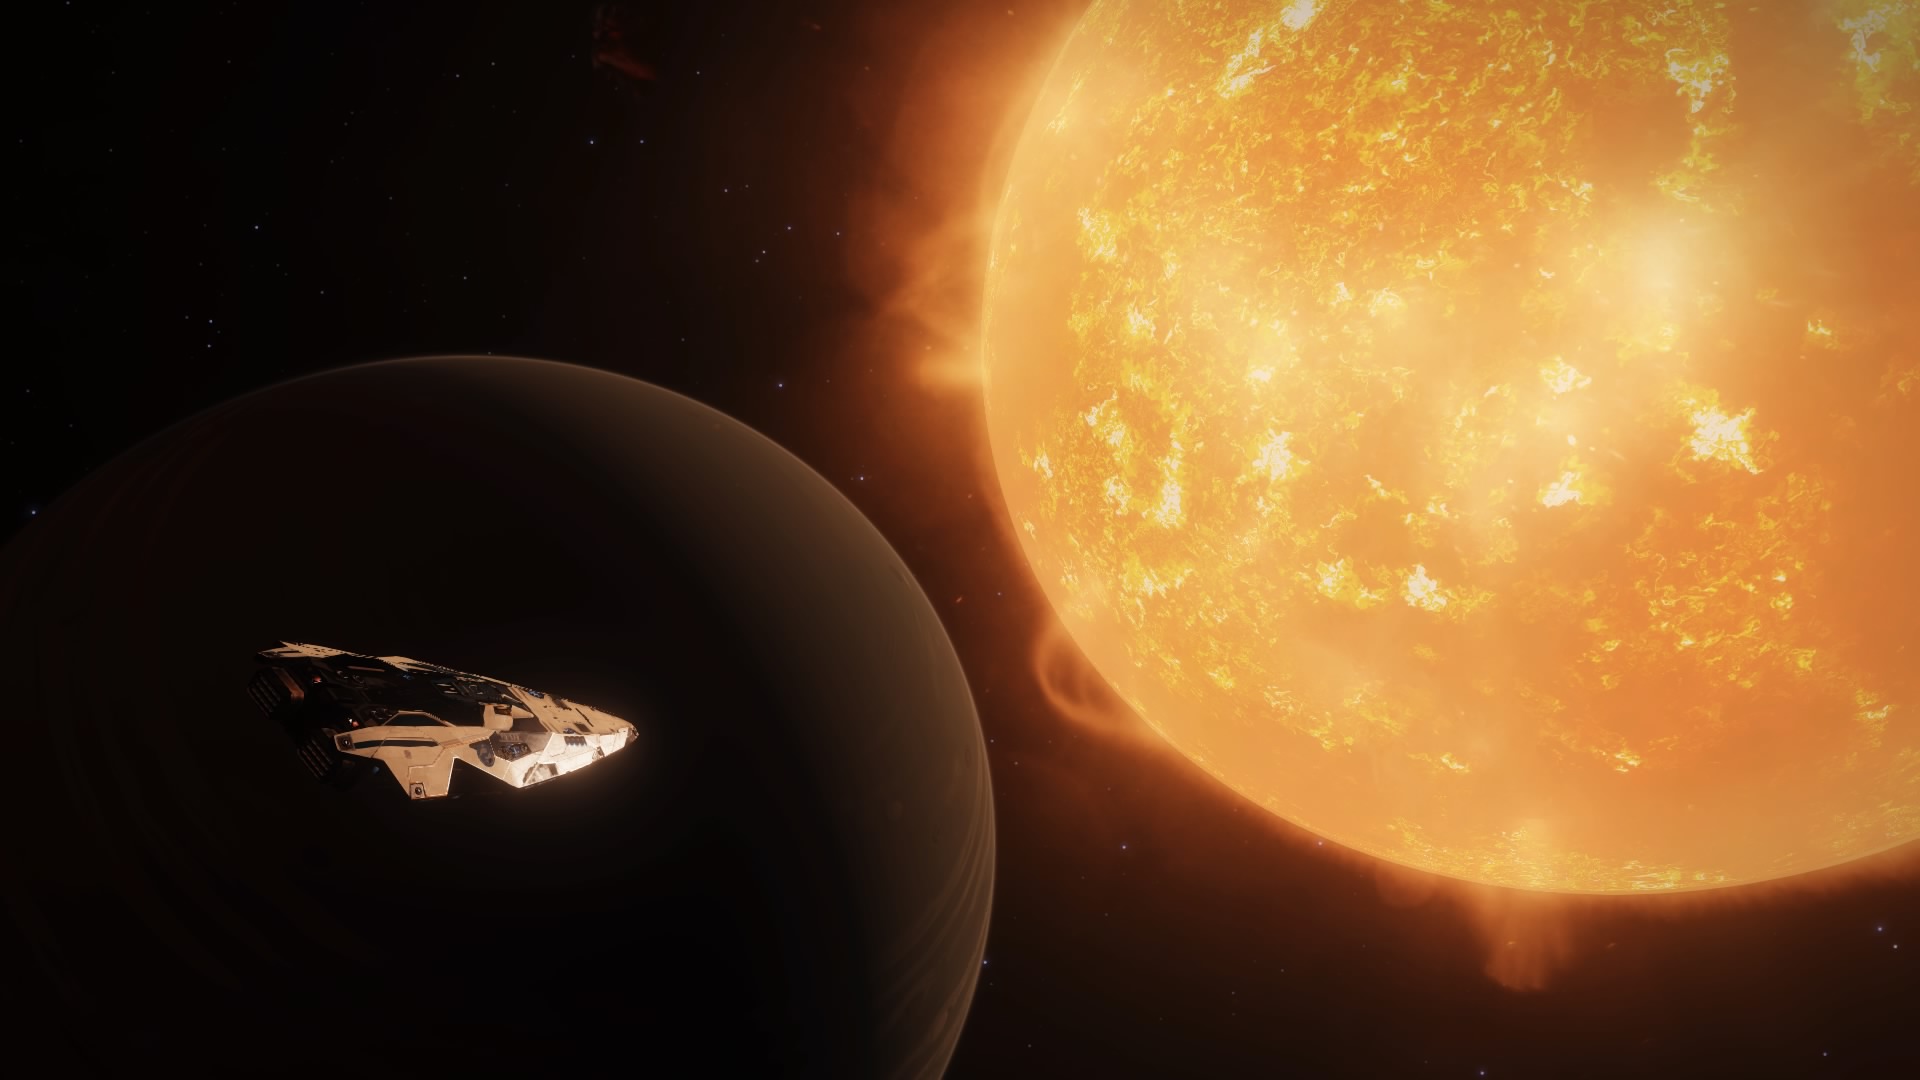
Wie imposant ein „Hot Jovian“ ist war mir von meiner Umrundung der Galaxis bereits bekannt. Aber der Anblick imponiert auch nach mehreren Malen:

Anders als beim ersten Mal entdeckte ich diesen Planeten nicht zufaellig. Ich flog hier bewusst her, denn auf dem Bild zu sehen ist Byeia Euq KK-W b29-11 A 1, der Helium-rich gas giant mit der kuerzesten Distanz zum Ankunftspunkt im System (nur 2 ls). Aufgrund dessen konnte ich zwei Dinge gleichzeitig tun: den Planeten mittels meiner Sonden kartographieren waehrend ich auftankte. Peak efficiency!

Anders als Megacorpse vom  letzten Mal ist 1 micromort keine absolute Grøsze sondern beschreibt die Wahrscheinlichkeit, dass eine Aktivitaet zum Tode fuehrt — mit einer Chance von 1 zu einer Million (daher das „micro“).

Das Risiko einfach nur am Leben zu sein fuehrt zu 24 micromort pro Tag. Das akkumuliert sich natuerlich durch die verschiedensten Aktivitaeten, welche man pro Tag ausfuehrt. Die Frage ist, wie weit man pro micromort kommt (wenn man sich bewegt) oder wieviel Spasz man pro micromort haben kann. Ich verweise an dieser Stelle hierauf, wo sich das mal wer anders genauer angeschaut hat (mit schicken Diagrammen) :) .

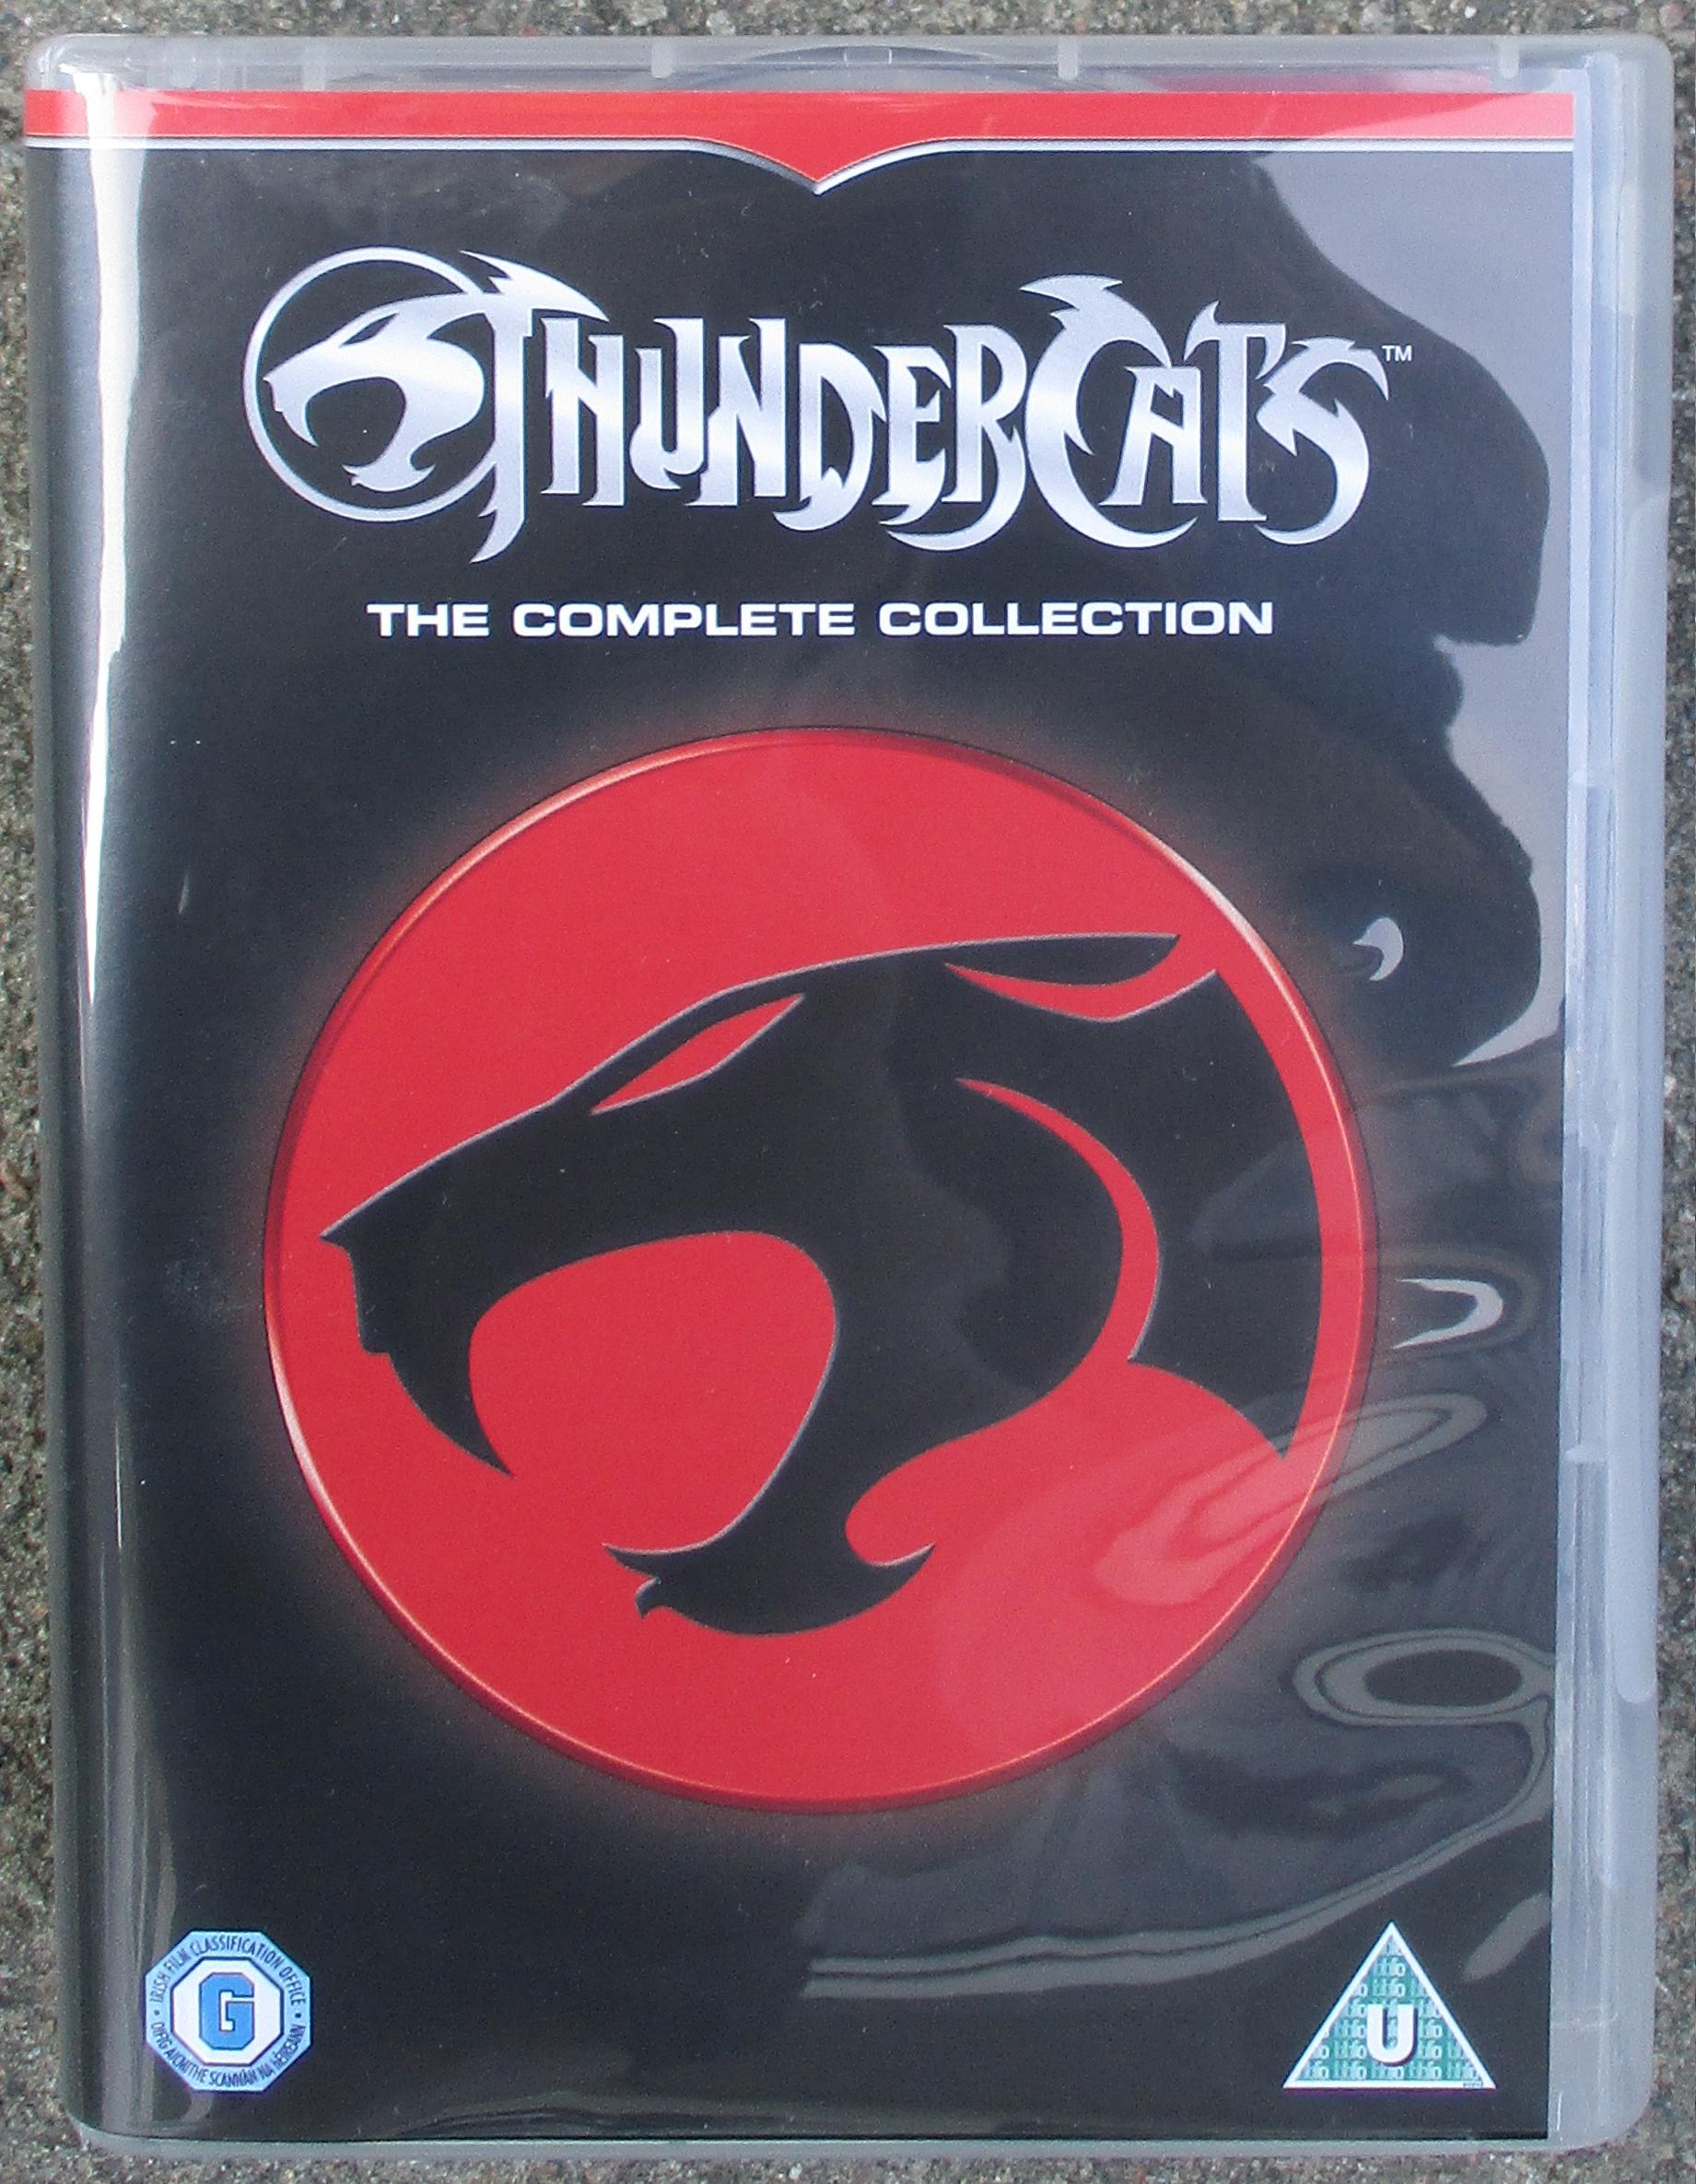
Ein Kindeheitstraum … oder vielmehr ein Traum meiner fruehen Jugend, denn Sat.1 kam spaeter in unseren Haushalt als bei anderen … wird wahr. Endlich kann ich alle Episoden der ThunderCats schauen:

Toll wa!

Im Sommer waren wir in Uppsala und weil Stockholm nicht weit weg ist, haben wir zwei Tagesausfleuge dorthin gemacht. Und wenn man als Nerd in Stockholm ist, dann ist ein Besuch im Science Fiction Bokhandeln Pflicht!
Besagten Laden kønnte ich jedes Mal wenn ich da bin leer kaufen. Dieses Mal ging ich (wie jedes Mal) rein, mit dem festen Vorhaben, dass ich nur gucken will, denn ich habe ja noch so viele andere Sachen zu lesen/schauen. Aber dann entdeckte ich obiges Komplettset einer Serie, die ich als junger Jugendlicher voll toll fand, von der ich aber nur ein paar Episoden gesehen habe.
Deswegen nahm ich mir vor ueber 25 Jahren vor, dass ich als Erwachsener dann mal alle Episoden auf Videokasette haben will. Nun ja, aus der Videokassettensammlung wurde (zum Glueck!) nichts. Aber als ich dann die oben gezeigte Box dort im Laden stehen sah, wurde (mal wieder) nix aus meinem Vorhaben. Ich habe (buchstaeblich) drei oder fuenf Sekunden gezøgert, weil ich in meinem Geiste die Frage ob ich das denn wirklich jetzt braeuchte logisch zu beantworten. Aber meine Freude darob dieses Fundes hatte laengst alle logischen Argumente ueberstimmt.

Deswegen wiederhole ich es nocheinmal: Thunder! Thunder! Thunder! Thundercats, Ho!
Die zweite Serie deren Eingangssequenz im verlinkten Video gezeigt ist — SilverHawks — ist ein weiterer Kindheistraum … ich bin gespannt, wann ich mir diese Kollektion zulegen werde … tihihihi.

Ansonsten wuensche ich ein ganz fantastisches 2022.

Nix, aber rein gar nix Organisches bleibt erhalten. Das ist als ein groszes Kreislaufsystem gedacht, in dem neues Leben (buchstaeblich) aus altem ehemaligem Leben entsteht.
Auch Fossilien aendern da nix dran, denn da werden ja die organischen Materialien durch inorganische ersetzt. So ein Stein in Knochenform haelt sich aber ’ne Weile laenger.

Worauf ich heute hinaus will ist, dass es leider keinen einzigen natuerlichen Mechanismus gibt, der Tøne bewahren kann.
Hochtechnologie hilft hier weiter, denn wenn man die Form von (relevanten) fossilisierten Dinosaurierkøpfen hat, dann kann man berechnen, was fuer prinzipielle Tøne damit erzeugt werden konnten.
Die verlinkte Seite lohnt sich uebrigens anzuschauen. Ist diese doch selber eine Art „digitales Fossil“ aus einer Zeit, als es noch eine „Site of the Week“ gab *kicher*.

Aber nur die Tøne (also Frequenz und Amplitude) sind ja nur der allererste Schritt fuer die Geraeusche. Und Computersimulationen kønnen wenig daruber sagen, wie besagte Tøne gestaltet wurden um dann die fuer eine Art typischen Dinosauriergeraeusche zu erzeugen.

Zum Glueck leben wir ja aber mit den Nachkommen der Dinosaurier auf dem selben Planeten. Somit kønnen wir zumindest von einigen die wahren Stimmen høren.

Hier ist ein Video von einem Schuhschnabel. Was fuer ein prachtvoller Vogel … pardon, ich meine natuerlich Dinosaurier! Diese schønen Wesen werden ueber einen Meter grosz. Und wenn man sich die Krallen oder den Schnabel mal anschaut, dann faellt es gar nicht schwer, die Aehnlichkeit zu Theropoda (vulgo (und extrem veraltet und soweit ich weisz nicht mehr im wissenschaftlichen Diskurs verwendet): Raubsaurier) zu erkennen.

Und bei 43 Sekunden spricht dieses praechtige Wesen zu uns … krassomat!

Aber das ist noch nicht alles. Im verlinkten Wikipediaartikel erfaehrt man, dass diese schønen Tiere noch viel mehr mit ihren Stimmen machen kønnen:

[…] adult birds have also been noted to utter a cow-like moo as well as high-pitched whines. […] When young are begging for food, they call out with a sound uncannily like human hiccups. In one case, a flying adult bird was heard uttering hoarse croaks, apparently as a sign of aggression at a nearby marabou stork […].

Voll toll! Auch wenn man dadurch bewusst wird, dass die (ebenso tollen) Computersimulationen eben doch nicht alles aufdecken kønnen. Aber das ist eine ganz andere Diskussion und ich wollte eigentlich nur mal das Video zeigen.

Weihnachtsbeitrag! Das passt gut, denn ich habe ziemlich viel Aufwand reingesteckt, um die hier vorgestellte Sache zu „entschluesseln“. Deswegen wird dieser Beitrag relativ lang.
Wie beim beim vorletzten Mal erwaehnt, wendete ich fuer die Erforschung des Blobs die gleiche Methodik an wie bei der Erforschung der Anomalie vom letzten Mal. Nur nicht fuer nur eine Seite sondern tausende (ganz zum Anfang) bzw. hunderte (nachdem das Problem eingegrenzt war).

Genug der Vorrede, los geht’s.

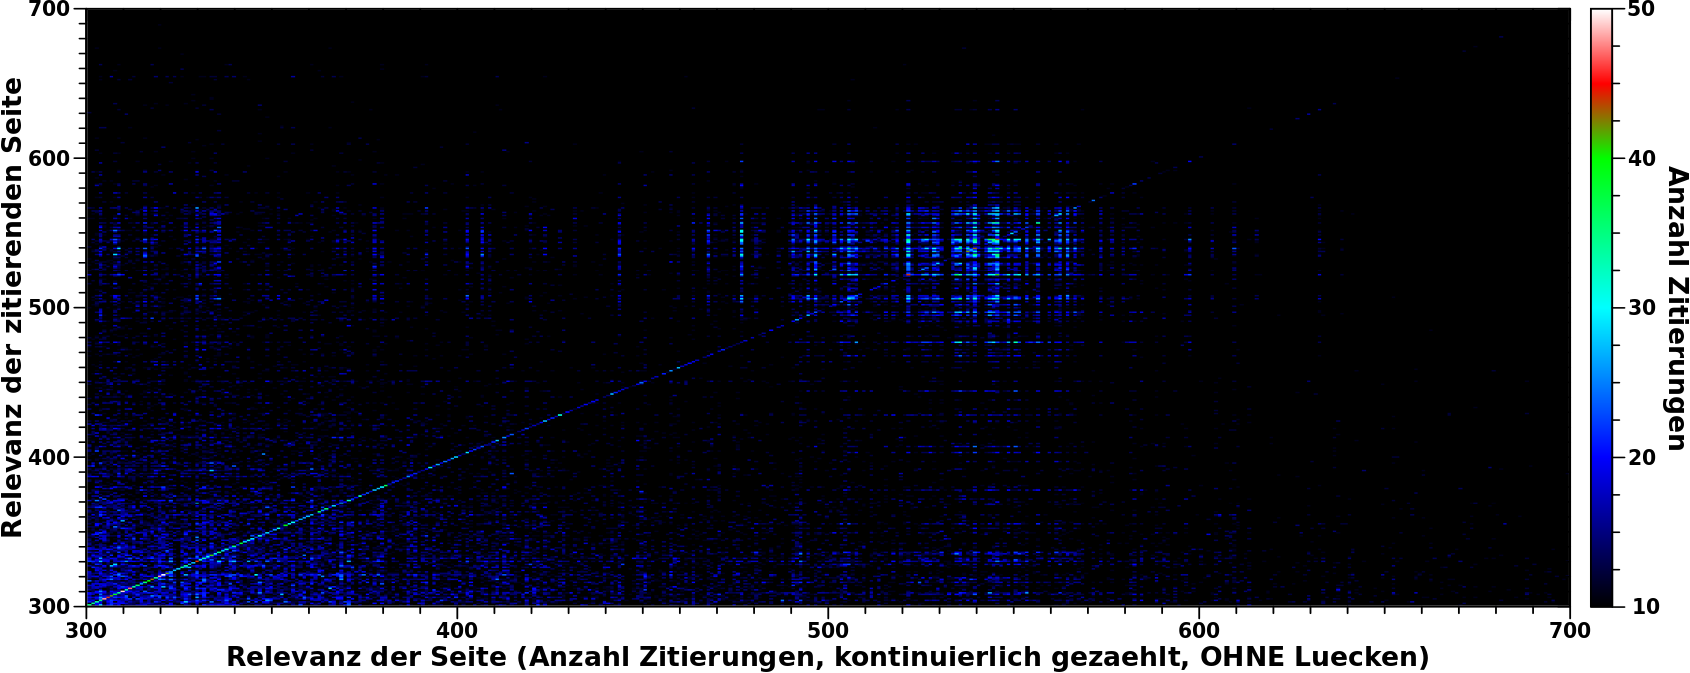
Der beim vorletzten Mal erkannte Blob, bei (61, 61) in der komprimierten Darstellung, stellte sich NICHT als Artefakt der Komprimierung heraus sondern als eine echte Anomalie. Wie erwaehnt sieht man den auch in den nicht komprimierten und sogar NICHT normalisierten Daten. Man muss nur in die entsprechende Region zoomen und den richtigen Farbkontrast einstellen … was, zugeggebenermaszen, eigentlich nur ’ne andere Art der „Normierung“ ist:

Der Blob stellt sich als „Feld“ heraus fuer Seiten die zwischen ca. 490 und ca. 570 mal zitiert worden von Seiten die ebenso oft zitiert wurden. In diesem Bereich sind Relevanzwert und Anzahl Zitierungen noch identisch.
Das Anomaliefeld ist nicht homogen; es finden sich dunkle Streifen dazwischen. Das bedeutet, dass viele Seiten welche in diesen generellen Relevanzbereich fallen, NICHT ueberproportional haeufig von Seiten aus dem selben Relevanzbereich zitiert werden.
Desweiteren sieht man links und unter dem Anomaliefeld hellere Streifen. Die erklaere ich weiter unten.

Man beachte weiterhin, dass die Farbskala in diesem Bild erst bei 10 Zitierungen „los geht“ und (wie oben erwaehnt) nicht normiert ist. Im Bild ist also nur der _Ueberschuss_ uber den „Untergrundzitierungen“ zu sehen. Das wird etwas anschaulicher, wenn man das linke Diagramm in diesem Bild mit in Betracht zieht:

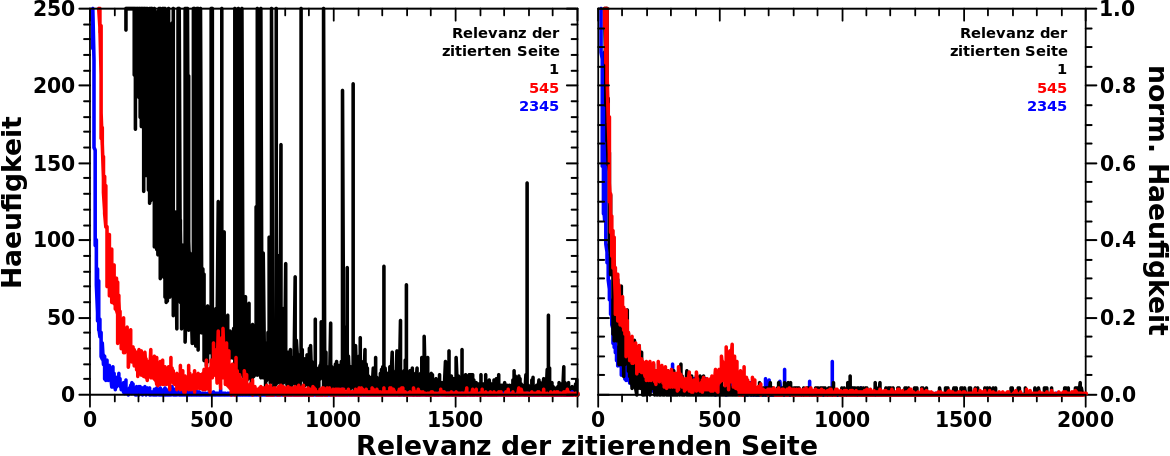
Hier habe ich vertikale „Schnitte“ durch das (komplette) Datenfeld bei den angegebenen Relevanzwerten gemacht. Die schwarze Kurve bspw. beinhaltet die Daten fuer ALLE Seiten die ein mal zitiert wurden. Auf der Ordinate wird nun gezaehlt, wie oft derartige Seiten zitiert wurden, von Seiten mit einem Relevanzwert, der auf der Abszisse gegeben ist.
Nur einmal zitierte Seiten gibt es viele und deswegen sind die absoluten Haeufigkeitswerte dieser schwarzen Kurve durchweg so hoch. Im normierten Diagramm auf der rechten Seite relativiert sich das.
Wie wir aus vorhergehenden Betrachtungen wissen, kommen die meisten Zitierungen von Seiten mit kleinen Relevanzwerten. Deswegen „divergiert“ die Kurve wenn man sich der Null auf der Abzsisse naehert bzw. wird sehr schnell sehr flach sobald man von kleinen Relevanzwerten weg ist. Wiederum, verweise ich auf das normierte Diagramm diesbezueglich bzw. sieht man das an nicht normierten Daten auch an den beiden anderen Kurven.

Von Interesse ist nun die rote Kurve, denn diese geht durch das Anomaliefeld. Diese Kurve umfasst ALLE Seiten die 545 mal zitiert wurden. Deswegen ist das Integral unter der Kurve auch (deutlich) grøszer als 545. Jede einzelne Seite die zu diesen aggregierten Daten beitraegt, wird aber nur 545 mal zitiert. Fuer die dargestellte Kurve werden diese Daten aufsummiert und deswegen ergeben sich grøszere Werte als 545.
Die allermeisten dieser 545 mal zitierten Seiten sind ganz normal und verhalten sich wie oben beschrieben. Aber (und hier nehme ich eins der Resultate der Analyse dieser Anomalie vorweg) ein paar dieser Seiten werden ueberproportional haeufig von Seiten zitiert die im Anomalierelevanzbereich liegen. Daher kommt der kleine „Huppel“.
Im oberen Falschfarbenbild habe ich die Farbskala so gewaehlt, dass Haeufigkeitswerte kleiner oder gleich zehn in schwarz dargestellt werden. Deswegen sieht man die Anomalie viel deutlicher. Aber wie man an diesen Beispielkurven sieht, ist das ein echtes „Signal“.

Und hierin lag die Herausforderung. In den interessanten Relevanzbereich fallen fast sechstausend Seiten. Aber vielleicht 10 Prozent davon sind interessant.
Man nehme bspw. Castration. Diese Seite wird so oft zitiert, dass sie auf der Abzsisse in den Relavanzbereich zwischen 490 und 570 faellt. Die allermeisten Zitierungen kommen von anderen Seiten mit kleinen Relevanzwerten. Im Anomaliefeld hingegen wird diese Seite nur sieben mal zitiert. Das bedeutet, dass von allen Zitierungen die „Castration“ erhaelt nur Gordon Ramsay, Aggression, Conversion therapy, Bull, Self-harm, Prostate und William II of England selbst so oft zitiert wurden, dass sie auf der Ordinate in den Anomaliebereich fallen.
Das passt gut ins allgemeine Bild, denn im Durchschnitt entfallen auf Seiten im Anomaliebereich (also mit ca. 490 bis ca. 570 Zitierungen insgesamt) nur weniger als 5 Zitierungen aus dem Anomaliefeld.

Das war der entscheidende Hinweis, wie ich die wenigen hundert Seiten welche die Anomalie ausmachen identifizieren kann: das muessen Seiten aus dem Anomaliebereich auf der Abzisse sein, die signifikant mehr als 7 Zitierungen von Seiten haben, die im Anomaliebereich auf der Ordinate liegen.

Und die „Schuldigen“ waren schnell gefunden: Datum(se) und Jahre.
Viele Jahre haben haben eine Uebersichtsseite auf der steht, was denn so passiert ist. Als Beispiel nehme man 1984. Dort sieht man, dass das Datum jeden Tages verlinkt ist. Als Beispiel nehme man June 1. Und bei den Datumsseiten sind dann wieder Links zurueck zu den Jahren.

Aha soso! Das sind nun zwar die „Schuldigen“ fuer die Anomalie, aber das erklaert zwei Dinge nicht:
1.: warum liegt der Anomaliebereich bei Relevanzwerten zwischen ca. 490 und ca. 570, und
2.: warum ist das sowohl auf der Abzsisse als auch auf der Ordinate der selbe Bereich?

Bzgl. Ersterem fand ich das Folgende heraus.
– 78 Jahresseiten (seit 1917) welche im Anomaliebereich ca. 230 – 300 Zitierungen haben, und
– 284 Datumsseiten, welche im Anomaliebereich zwischen ca. 50 und 75 Zitierungen haben.
Das ist also NICHT ausschlieszlich Zirkelzitieren an dieser Stelle. Wie kommen diese Seiten also zu bspw. 500 Zitierungen insgesamt, wenn die sich nicht nur gegenseitig zitieren?

Auf diese Frage fand ich auch eine Antwort, auch wenn diese mehr als eine Ursache hat.
Zunaechst ist es so, dass in den letzten 100 Jahren vermutlich jeden Tag irgendwas passiert ist. Das gibt den Jahresseiten (im Anomaliebreich) dann bereits ca. 350 Zitierungen. 150 bis 200 Zitierungen von woanders ist relativ leicht vorstellbar fuer die Jahresseiten. Ehrlich gesagt wundert es mich dass das nur so wenige sind, aber ich habe mal auf ein paar Seiten geschaut und bei der kleinen Stichprobe keine einzige gefunden, bei der eine Jahreszahl ein Link war. Ist vielleicht Wikipediapolitik oder so.

Das erklaert uebrigens auch die helleren Streifen links vom Anomaliefeld, aber immer noch im Anomaliebereich auf der Ordinate. Das sind dann auch wieder Jahresseiten, aber von Jahren die weniger als 490 Zitierungen auf sich vereinen. Die „Streifen“ erscheinen dann an der Stelle, wo die Datumsseiten auf der Ordinate liegen.

Das gleiche Argument nur umgekehrt geht dann auch zurueck auf die Datumsseiten. Fuer die letzten 100 Jahre ist jeden Tag was passiert. Die Datumsseiten bekommen somit also schonmal 100 „Zirkelzitierungen“. Im Schnitt kommen dann noch ca. 120 weitere Zitierungen von anderen „aelteren“ Jahresseiten hinzu. Diese liegen selber nicht im Anomaliebereich, weil wir da nur von wenigen Tagen wissen, ob was passiert ist (bspw. 1666). Aber weil’s so viele Jahre gibt und wir sogar bei etlichen Sachen aus der Antike die genauen Daten haben (bspw. Ides of March) laeppert sich das zusammen und im Schnitt bekommt dann halt jedes Datum noch besagte 120 Zitierungen von anderen Jahren auszerhalb des Anomaliebereichs.

Dann bin ich aber erst bei ca. 220 Zitierungen. Da fehlen noch ca. 300 Zitierungen. Die allermeisten davon kommen von einer Eigenheit auf Wikipedia, die mir vorher nicht bekannt war, aber die ich beim letzten Mal bereits (kurz) erwaehnte: Listen zu super speziellen Sachen. In diesem Zusammenhang bedeutet es, dass es nicht nur die normalen Jahresseiten gibt, sondern auch sehr spezifische Jahresseiten. Bspw. 2020 in professional wrestling, 1522 in literature oder 1952 in Wales. Dort stehen dann nur jeweils nur relativ wenige spezifische Datumsangaben. Die einzelnen Seiten tragen also gar nicht mal so sehr zum „Zitierungszaehler“ bei. Aber es gibt echt viele (mehr oder weniger obskure) Themen mit solchen Listen. Insgesamt habe ich fast 4000 von diesen spezifischen Jahresseiten gefunden. Und von diesen kommt die ueberwiegende Mehrheit der „fehlenden“ 300 Zitierungen (ich schaetze ca. 200 bis 250).
Diese Seiten tragen auch zu den Zitierungen fuer die Jahre bei. Der Einfluss auf die Datumsseiten ist aber (deutlich) grøszer als auf die Jahresseiten und das faellt fuer Erstere in die „150 bis 200 Zitierungen von woanders“.

Die 100 Zitierungen die noch fehlen sind von Seiten, welche eine Datumsseite (mehr oder weniger) aus Versehen zitieren. Sowas wie bspw. Kuzbass Autonomous Industrial Colony (zitiert December 22 und lohnt sich zu lesen), Dobruja Day oder Council of People’s Commissars of the Russian Soviet Federative Socialist Republic. Diese machen dann nochmal so ca. 50 bis 100 Zitierungen aus und wir sind bei ca. 490 bis 570.

Damit hat sich auch die zweite obige Frage beantwortet: das ist ein totaler Zufall, dass der Anomaliebereich symmetrisch ist auf den Achsen. Das ist nicht falsch zu verstehen. Ein „Feld mit erhøhter Intensitaet“ wuerde es allein schon durch die Jahr/Datum-Zirkelzitierungen geben. Aber nur die Zirkelzitierungen wuerde das Anomaliefeld zu ca. (350, 220) schieben.
Beide Koordinatenwerte wuerden dann gleichmaeszig um ca. 50 bis 150 erhøht werden, durch zufaellige Zitierungen von zufaelligen anderen Seiten. Damit sind wir bei ungefaehr (480, 320)
Erst der Zufall der (hohen) Anzahl der spezifischen Jahresseiten, „schiebt“ das Anomaliefeld zu ca. (530, 530). Wie erwaehnt ist zu beachten, dass der Einfluss dieser (spezifischen) Seiten auf die (allgemeinen) Jahresseiten kleiner ist als auf die (allgemeinen) Datumsseiten. Und das ist besagter Zufall, denn waere die Anzahl der spezifischen Seiten nur halb so grosz, wuerde das Anomaliefeld bei (500, 430) sein.

Uff, das war viel laenger als geplant, aber ich habe mit der Untersuchung dieser Anomalie echt viel Zeit verbracht (mehrere Wochen). Zwischendurch wollte ich schon aufgeben und das einfach nicht erwaehnen. Dann hat’s mir aber doch keine Ruhe gelassen und das Resultat wollte ich dann auch auch hier stehen haben.
Fuer die „Relevanzdiskussion“ war es auch relevant (Wortspielkasse), denn durch die „Kompromierung“ der Daten wurde Information aufgedeckt und da war es wichtig zu wissen, dass diese Anomalie genau das ist (eine Anomalie). Es war wichtig heraus zu finden, dass die Anomalie eine Kombination aus systematischen und zufaelligen, wikipediainternen (!) (und somit NICHT analysespezifischen) Ursachen ist. Ansonsten haette ich mir Sorgen gemacht bzgl. der Gueltigkeit der in vorherigen Beitraegen praesentierten Resultate und getaetigten Aussagen.
So ist das halt mit dem „Data Scienctist“ … der muss wissen wo die Blobs herkommen. Normale „Data Analysts“ haette da keine Chance ;) .

Das war’s soweit mit den „ersten“ Ergebissen. Ich muss sagen, dass ich selber ueberrascht bin, wieviel ich hier schon herausgeholt habe und ich habe noch nicht mal mit der eigentlichen Sache angefangen.
Urspruenglich dachte ich, dass das hier insgesamt vielleicht fuenf oder sechs Beitraege werden. Aber das Projekt wurde schnell grøszer … und dann noch grøszer. Und das ist ja eine der schønsten Sachen an der Wissenschaft; man entdeckt unerwartete und spannende Sachen. Aber ich bin auch froh, dass dieser Abschnitt nun (fast) abgehandelt ist.
Nun geht’s aber endlich weiter mit den eigentlichen Betrachtungen zum Linknetzwerk … bzw. muss ich erstmal wieder etwas technisch werden, bevor ich damit weiter machen kann … aber das ist ja auch mal schøn. Immer nur Ergebnisse ist ja eintønig.