Archive for the ‘Kevin Bacon’ Category

Rekorde bzgl. des laengsten bzw. kuerzesten Titel sind zwar nett, aber die haben wenig Aussagekraft, was man denn prinzipiell erwarten kann. Deswegen schaute ich mir mal die Verteilung der Laenge aller Titel aller Wikipediaseiten an. Diese Verteilung sieht so aus …
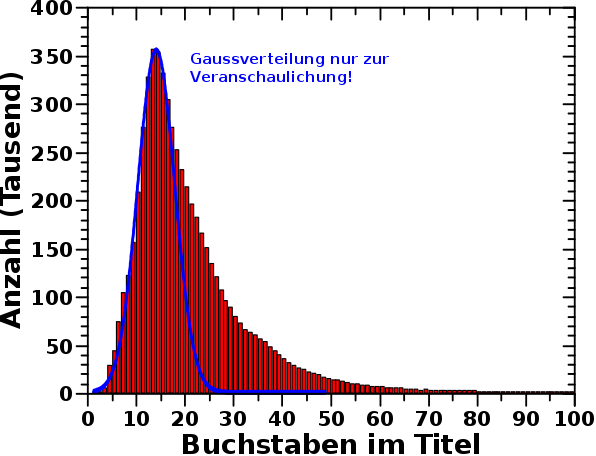
… und das ist ganz bestimmt keine Normalverteilung, denn die habe ich zum Vergleich mit eingezeichnet.

So richtig verwundert war ich erstmal nicht, denn ich hatte nix erwartet. Aber dann fragte ich mich doch, warum das keine Normalverteilung ist.
Prinzipiell muss das keine Gaussverteilung sein. Die Geschwindigkeitsverteilung der Konstituenten eines idealen Gases folgen einer Maxwell-Boltzmann-Verteilung. Wie oft die Erde pro Jahr von Meteoriten getroffen wird, die grøszer sind als 1 m folgt einer Poisson-Verteilung. Aber wenn ich nix weiter weisz, dann nehme ich erstmal eine Gaussverteilung an. Das war schon bei meinen vielen Muenzwuerfen und auch bei meinen Untersuchungen der Fibonaccifolge erfolgreich.
Mit dem „dicken“ Teil rechts vom Peak kønnte es eine Maxwell-Boltzmann-Verteilung sein. Ich habe versucht die Daten mit dieser Funktion anzupassen und das funktioniert nicht. Gut so, denn dann haette ich mir Gedanken machen muessen, warum die Verteilung der Anzahl der Buchstaben der Titel der Wikipediaseiten ausgerechnet einer Maxwell-Boltzmann-Verteilung folgt.

Wenn man sich die Verteilung aber nun genau anschaut, dann sieht man zwei „Schultern“. Die eine bei ca. 35 Buchstaben sieht auch das ungeuebte Auge. Die andere um ca. 23 Buchstaben sieht man eigentllich nur, weil die roten Balken nicht der blauen Kurve folgen.
Schultern sind oft ein Zeichen dafuer, dass das Gesamtsignal durch mehrere Prozesse zustande kommt. Ich persønlich kenne das aus der Halbleiterphysik, in der das Gesamtsignal optischer Halbleiter oft aus Rekombinationskanaelen unterschiedlicher Energie (vulgo: unterschiedliche Wellenlaenge) stammt.

Zur besseren Veranschaulichung stelle man sich eine RGB-Leuchtdiode vor. Diese besteht eigentlich aus drei Leuchtdioden, einer roten, einer gruenen und einer blauen, die nahe beineinander sind. Wenn nun alle drei von denen gleichzeitig an sind, nimmt das Auge das Gesamtsignal als weiszes Licht wahr. In dem Fall haben wir also drei Prozesse die unabhaegig voneinander sind und in der Summe etwas sehr anderes ergeben als einzeln betrachtet — naemlich besagtes weiszes Licht anstatt einer wohldefinierten Farbe.
Das Licht welches jede einzelne Leuchtdiode aussendet ist nun aber nicht streng „einfarbig“. Die Leuchtdioden emittieren nicht bei nur einen einzelnen Wellenlaenge sondern das Maximum der Emission liegt auf einem gewissen Wert (den wir dann bspw. als „rot“ sehen) und mit geringerer Wahrscheinlichkeit wird Licht høherer und niedrigerer Wellenlaenge ausgestrahlt. Die Wahrscheinlichkeit welche Wellenlaenge ausgestrahlt wird ist normalverteilt.
Kurzer Abstecher: ein Laser emittiert auf einer einzigen Wellenlaenge … naja, streng genommen emittiert auch ein Laser nicht auf ganz genau auf nur einer einzigen Wellenlaenge, aber fuer die meisten praktischen Betrachtungen ist das nicht so wichtig, denn die „Streuung“ um die Zentralwellenlaenge ist viel geringer als bspw. bei Leuchtdioden.
Lange Rede kurzer Sinn: man kann das weisze Licht einer RGB-Leuchtdiode mittels drei unabhaengigen normalverteilten Prozessen erklaeren.

Wenn ich nun die Daten mittels drei Gaussverteilungen anpasse, erhalte ich dieses Bild:
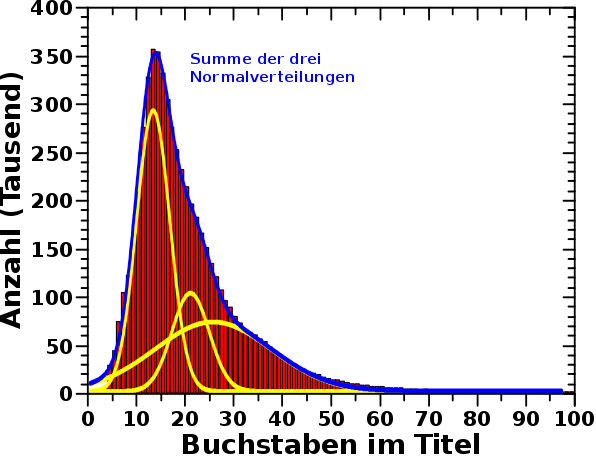
Die blaue Kurve entspricht der Summe der drei unabhaengigen Gaussverteilungen (gelb). Dass die Anpassung so gut ist, deutet darauf hin, dass meine Annahme dreier unabhaengiger (gaussverteilter) Prozesse mglw. richtig ist … andererseits, wenn man genuegend Normalverteilungen nimmt, kann man alles mehr oder weniger gut anpassen.

Die erste unabhaengige Verteilung dominiert den Peak und das Zentrum dieser liegt bei ungefaher 13.23 Buchstaben. Der zweite Prozess ist deutlich schwaecher (die Amplitude der Gaussfunktion ist nur ca. ein drittel so grosz) und das Zentrum liegt bei ca. 21.07 Buchstaben. Der dritte Prozess liegt mit einem Zentrum von ca. 25.81 Buchstaben allerdings ziemlich weit entfernt von den oben erwaehnten ca. 35 Buchstaben. Von der „Staerke“ aehnelt dieser dem zweiten Prozess, ist aber deutlich weniger „definiert“. Die, diesen Prozess beschreibende, Gausskurve ist sehr breit und ueberlappt signifikant die beiden anderen Prozesse.

Das ist natuerlich nicht „die ganze Geschichte“. Wenn die Tittellaenge deutlich mehr als 50 betraegt wird die Verteilung ueberhaupt nicht gut mit diesen drei Prozesen beschrieben. Das ist aber nicht unerwartet und tut relativ wenig zur Sache. Letzteres liegt natuerlich daran, weil es davon insgesamt so wenige gibt und die fallen dann unter das was ich im allerersten Satz bereits schrieb.

Nun ist natuerlich die Frage, was diese drei Prozesse sein kønnten?
Ehrlich gesagt, habe ich ueberhaupt keine Idee, was der dritte Prozess ist. Aber bei so einer breiten Gausskurve kønnte da alles møglich mit dazu zaehlen. Bei den ersten beiden Prozessen habe ich aber eine Vermutung: die englische Sprache an sich und Namen. Dazu mehr beim naechsten Mal.
Beim letzten Mal schaute ich mir die Wikipediaseiten mit den kuerzesten Titeln an.

Auf der anderen Seite gibt es Wikipediaseiten mit echt langen Titeln. Das Subcommittee on International Organizations of the Committee on International Relations hat 87 Buchstaben. Ein anderes Subcommittee, das United States Senate Foreign Relations Subcommittee on Multilateral International Development, Multilateral Institutions, and International Economic, Energy and Environmental Policy, hat fast 100 Buchstaben mehr (181 um genau zu sein). Aber den ersten Preis (oder vielmehr die Blume) nimmt, mit 250 Buchstaben, nach Hause die Wikipediaseite mit dem Titel: Cneoridium dumosum (Nuttall) Hooker F. Collected March 26, 1960, at an Elevation of about 1450 Meters on Cerro Quemazón, 15 Miles South of Bahía de Los Angeles, Baja California, México, Apparently for a Southeastward Range Extension of Some 140 Miles … das ist uebrigens der Titel einer wissenschaftlichen Arbeit *lol*.

Beim naechsten Mal schaue ich mir dann mal genauer an, wie sich die Verteilung der Laenge der Titel aussieht.

Nun hatte ich endlich die Rohdaten zur Analyse des Linknetzwerks fertig. Aber bevor ich dazu komme (und wieder erstmal ein paar technische Details besprechen werde), dachte ich mir, dass ich ja schonmal das was ich habe untersuchen kønnte.

Dabei musste ich mir auch keine Sorgen darum machen, ob das alles in den Arbeitsspeicher passt. Der Grund ist, dass ich immer nur ca. 100,000 Titel (mit den dazugehørigen Links) in eigenen, kleinen Dateien gespeichert habe. Die Daten darin passen garantiert in den Arbeitsspeicher und ich kann die der Reihe nach abarbeiten.
Das Linknetzwerk wird dadurch in keinster Weise analysiert, denn dafuer muss ich ALLES gleichzeitig bearbeiten … dazu aber mehr zu einem spaeteren Zeitpunkt.

Heute nun interessierte mich, was denn die kuerzesten Titel sind. Es stellte sich heraus, dass viele Buchstaben (im weitesten Sinne) und Zahlsymbole der Sprachen dieser Welt eigene Wikipediaseiten haben. Naja … wenn man alle Sprachen in Betracht zieht, dann haben nur ganz wenige Buchstaben eine eigene Seite … aber darauf will ich nicht hinaus.

Ein Beispiel ware die Nummer 5, der Buchstabe P, oder das umgedrehte S.
Die Laenge dieser Titel ist … eins … und davon gibt es 234 Seiten … das war einfach … tihihi.

„Tote Links“, also links die zu Seiten „fuehren“ die es gar nicht gibt, sind rot unterstrichen. Auf dieser Seite findet man einige Beispiel dafuer. Um die zu finden, oder vielmehr um nicht aus Versehen echte Links diesen zuzuordnen, musste ich (fast) alles von dem machen, was ich in vorherigen Artikeln dieser Reihe beschrieben habe.

Weil dies aber nun fertig war, wurde die Aufgabe relativ einfach, denn ich brauchte nur fuer die verbliebenen 181,064,753 Links schauen, ob es eine Wikipediaseite mit dem selben Titel gibt. Dadurch fielen fast 10 % dieser Links weg und zurueck blieben 165,913,569.

Eine zweite Art von „Leiche“ sind Artikel die keine Links (im Text) enthalten. Zunaechst kønnte man denken, dass es sich dabei nur um sehr kurze Artikel zu obskuren Themen wie Vehicle registration plates of Qatar handelt. Das gibt es aber auch bei laengeren Seiten mit durchaus relevantem Thema. Ein Beispiel waere Organizational change fatigue. Und ebenso gibt es Artikel die so lang sind, dass ich mich frage, wie die KEINE Links haben kønnen; bspw. Ahn Sanghak.

Wieauchimmer, wenn solche „leeren“ Seiten NICHT woanders verlinkt waren, habe ich die rausgeschmissen. Das waren nicht viele. Gerade mal 2802.
Viele von diesen gehen zum Wiktionary; als Beispiel soll Flitterjigs genuegen. Aber oft sind es auch richtige Seiten; beispielsweise Phalke oder Prestwich Camera. Sollte ich jemals einen eigenstaendigen Wikipediaartikel schreiben (anstatt nur mal hier und da ’n Fehler zu berichtigen), muss ich dafuer sorgen, dass der an anderer Stelle zitiert wird.

Das war’s dann nun endlich mit den Vorbetrachtungen zu den Rohdaten und dem „Aufraeumen“ in diesen. Und hier sind die endgueltigen Zahlen, bzgl. der Daten an denen ich in die Analyse vollzogen habe: 5,798,312 Wikipediaseiten auf denen insgesamt 165,913,569 Links erscheinen und die Grøsze der strukturierten Daten betraegt 4.1 GB.
Aber bevor ich mit der eigentlichen Analyse anfangen konnte, musste ich noch ein paar … mhmmm … ich sag mal technische Probleme løsen. Dazu mehr in den kommenden Beitraegen in dieser Serie.

Abschlieszend zu den Rohdaten sei an dieser Stelle erwaehnt, dass ich in all den bisher beschriebenen Aktionen definitiv echte Links faelschlicherweise geløscht habe. Dies kann mehrere Gruende haben. Einer ist natuerlich, dass ich nur einen Teil der von Nutzern eingefuehrten Fehler berichtigt habe. Wikipedias interne (Such)Funktionen habe damit dann aber keine Probleme. Ein anderer Grund waere bspw. wenn ein (aelterer?) Artikel einen Link zu einem anderen Artikel hat, dieser aber nun zu etwas anderem umgeleitet wird. Eigentlich habe ich solche Umleitungen in Betracht gezogen, aber manchmal scheint das nicht geklappt zu haben. Die Prestwich Camera die ich oben verlinke ist so ein Fall.
Wieauchimmer, ich setze ja sowieso bei Daten aus der echten (Menschen)Welt einen Fehler von 10 % an und ich denke nicht, dass solche Faelle diesen uebersteigen.

Zu meiner Ueberraschung gibt’s das Wort tatsaechlich in der dtsch. Sprache und ich meine damit solche Seiten — eine andere Art der hier besprochenen „Abkuerzungen“.

Fuer die Analyse des Linknetzwerkes sind mir diese ein Dorn im Auge. Denn was haben Donald Fraser (der Geologe) und Don Fraser (der Eiskunstlaeufer) gemeinsam? Vermutlich nix, aber auf solchen Seiten werden die (beinahe) direkt miteinander verbunden. Im gesamten Linknetzwerk „treffen“ die beiden sicherlich frueher oder spaeter aufeinander, aber durch diese Seiten passiert das viel zu frueh. Das ist Schummeln und deswegen will ich die weg haben.

Zum Glueck gibt es zwei interne Wikipediaseiten die (fast) alle Dis­am­bi­gu­ie­rungsseiten auflisten. Hier ist die eine und dort ist andere. Also baute ich mir erstmal einen Datenmaehdrescher der mir die relevante Information von den beiden Seiten beschaffte.
Apropos, als Data Scientist ist es total normal fuer mich, spezielle, der Aufgabe angepasste, Werkzeuge zu schreiben um die Analyse ueberhaupt erst durchfuehren zu kønnen. Das war ja bei den Stromdaten damals genauso. Was der Unterschied zu den Data Analysts ist, kønnt ihr, meine lieben Leserinnen und Leser, euch sicher selber denken.

Wieauchimmer, auf diese Art und Weise fand ich mehr als 400,000 Dis­am­bi­gu­ie­rungsseiten.

Das Problem ist nun, dass die beiden Seiten NICHT alle Dis­am­bi­gu­ie­rungsseiten auffuehren. Denn dafuer muss bei der Erstellung einer solchen Seite eine bestimmte Markierung gesetzt werden und das machen Nutzer manchmal nicht.

Ganz im Allgemeinen ist das uebrigens ein zweigeteiltes Elitenproblem! Zum Einen muss man wissen wie man die Wikipedia schreibt. Somit findet Wissen welches die sog. Elite nicht interessiert keinen Eingang. Ein Beispiel waere Folklore in den Favelas. Ich bin ueberzeugt, dass es die gibt, konnte dazu aber auf die Schnelle nix finden. Und was man nicht schnell findet gibt’s nicht — genauso wie die Ergebnisse auf Seite 2 der Suche nicht existieren.
Zum Zweiten werden „kuenstliche“ „Intelligenzen“ mit diesen Daten trainiert! Und die Wikipedia ist vornehmlich Cisgender, maennlich und europid. Aber ich schwiffte ab.

Ich habe dann ein paar Tage einen ursten Aufwand betrieben, um Heuristiken fuer Dis­am­bi­gu­ie­rungsseiten zu finden, die nicht in den beiden erwaehnten Listen zu finden sind. Ich fand so ca. 15,000 … und ich fand auch etliche Seiten die von diesen Heuristiken falsch erkannt wurden. Weil ca. 15,000 verglichen mit 400,000 zum Glueck nicht richtig viel ist, entschied ich mich deswegen die alle drin zu lassen und dem bereits mehrfach erwaehnten Fehler zuzufuehren … *seufz* … lieber lasse ich einen Schuldigen, dessen Schuld nicht eindeutig bewiesen ist gehen, als dass ich einen Unschuldigen aus Versehen einsperre … diese Meinung habe ich uebrigens auch bei anderen Themen.

Unter den Seiten die ich drin lasse, fallen leider auch solche Seiten wie die Alphabetical list of municipalities of Italy (7963 Links) oder die IUCN Red List vulnerable species (Animalia) (5244 Links) oder der Index of Singapore-related articles (welche mit 11,521 bei Weitem die meisten Links hat).
Ebenso fand ich mehr als 286-tausend Artikel die als erstes eine Jahreszahl in sich haben und welche die Events in bestimmten Bereichen fuer jedes Jahr aufzaehlen. Als Beispiele seien 1966 in film (1043 Links), 1985 in music (1477 Links), 2017–18 Isle of Man Football League (47 Links) genannt. Mit 2027 in rail transport (33 Links) laeszt sogar die Zukunft schon von sich høren.

Dann dachte ich (wieder einmal), dass ich alle Listen, Indices und Titel die mit Jahren anfangen rausfiltern kønnte, und verbrachte einige Zeit damit Heuristiken dafuer zu finden. Leider fand ich auch hier wieder heraus, dass es da so viele Ausnahmen gibt, dass das unpraktisch war.
Andererseits, kønnte bei all diesen Seiten durchaus argumentiert werden, dass die eine Berechtigung in der Analyse haben, weil sie thematisch sortiert sind. Anders als das Mr. Fraser Beispiel oben schaffen diese Seiten also keine „Abkuerzungen“ zu thematisch nicht zusammenhaengenden Dingen. Dieser ad hoc Grund reichte mir, denn ich hatte genug davon davon mir Wikipediaseiten anzuschauen und rauszufinden warum die eine Ausnahme sind … *seufz*.

Jut, nun hatte ich also alle Dis­am­bi­gu­ie­rungsseiten gefunden und konnte die (und Links dorthin) løschen. An dieser Stelle habe ich mich dann auch nochmal um die Umleitungen gekuemmert. Die allermeisten hatte ich schon frueh mit den richtigen Links erstattet (bzw. geløscht). Ein paar Sachen waren aber noch offen (bspw. hatte ich Umleitungen ganz am Anfang noch ohne Ersetzung der Spezialbuchstaben betrachtet). Auszerdem habe ich noch ein zweites Mal interne Seiten geløscht (prinzipiell konnten welche auftauchen nach der Erstattung der Umleitungen) und mich auch nochmal um die Korrektur von Nutzerfehler gekuemmert.
Durch all das war aber nicht mehr viel zu holen. Die genauen Zahlen habe ich vergessen, aber mich duenkt die zuletzt beschriebene Aktion verkleinerte die Anzahl der Links um 12 … oder 16 oder so eine andere kleine Zahl. Aber ’s ist natuerlich immer schøn, wenn die Daten eine etwas bessere Qualitaet haben.

Nach dieser Saeuberung der Daten blieben noch 5,801,114 Seiten zurueck (von ehemals 6,212,282) in denen insgesamt 181,064,753 Links erscheinen (von ehedem 188,777,960).
Die Grøsze der strukturierten Daten konnte von 4.9 GB geringfuegig auf 4.5 GB verringert werden. Aber gerade hier zaehlt jedes bisschen :)

Somit war ich beinahe am Ende der Vorbetrachtungen der Rohdaten angekommen. Es verblieben nur noch zwei Sachen. Links die keiner Wikipediaseite zugeordnet werden kønnen und Seiten die keine Links haben und auch nicht zitiert werden. Beides kommt vor und keines davon muss ich mitschleppen. Erstere nicht, weil es da nix zu untersuchen gibt. Letztere nicht, weil deren Linknetzwerk genau null Verbindungen hat. Aber mehr dazu beim naechsten Mal.

Urspruenglich dachte ich mir, dass ich bei meinen Betrachtungen einfach alles klein schreibe. Der Grund ist, dass Menschen dazu tendieren, Grosz- und Kleinschreibung wild durcheinander zu wuerfeln und auf diese Art und Weise wollte ich diese Fehlerquelle vermeiden.

Die Suchfunktion in Wikipedia kuemmert das nicht. Aber bei meiner Analyse ist das wichtig in Betracht zu ziehen, damit ein verlinkter Link richtig einem Titel zugeordnet werden kann.

Doch dann stolperte ich ueber JoAn Wood der ueberhaupt nichts mit Joan Wood zu tun hat … Oder war es der Unterschied zwischen UMBEL und Umbel? … Ach nein, mich duenkt es war Testing the waters vs. Testing the Waters … *seufz*.
Davon gibt es nicht viele Faelle, weniger als 2200. Aber schon einer haette gereicht um meine obige Annahme als nicht brauchbar hinzustellen. Somit musste ich also doch das (ungleich schwerere) Problem der Nutzerschludrigkeiten løsen.

Meine erste Idee war, dass ich mir den Hamming-Abstand zunutze machen kønnte. Dieser misst …

[…] the minimum number of substitutions required to change one string into the other […].

Die oben erwaehnten ca. 2200 Beispiele wo das-Gleiche-blosz-anders richtig ist, sind mir bekannt. Die kann ich also einfach auslassen bei der Berechnung des Hamming Abstands (damit da nix falsch gemacht wird).
Ich programmierte das dann fix und zunaechst schien das auch zu funktionieren. Bspw. erkannte der Algorithmus, dass „Takashi Fujiwara“ vermutlich eigentlich „Takeshi Fujiwara“ sein soll. Doch dann stolperte ich ueber Voss IL, welches zu Moss IL werden sollte. Ich bemerkte das natuerlich nur, weil ich „lokales Wissen“ habe, denn ich wohne in Norwegen. Voss und Moss sind Ortsnamen und „IL“ bedeutet „idrettslag“ — Sportverein. Zwar hat nur Moss IL eine Seite in Wikipedia, aber Voss IL wird hier zumindest erwaehnt.
Ein anderes (lustiges) Beispiel warum der Hamming-Abstand fuer meine Zwecke nicht brauchbar ist, ist die Umwandlung von „Macon, Ohio“. Dies kønnte entweder „Mason, Ohio“ werden oder „Bacon, Ohio„. Welches ist richtig?
Satz mit ‚X‘: das war wohl nix … *seufz*.

Der Grund warum mir das so am Herzen liegt ist folgender. Ganz am Ende werde ich alle Links die keiner echten Wikipediaseite entsprechen rausschmeiszen. Und die hier beschriebenen Faelle wuerden alle faelschlicherweise als „gibt’s nicht“ erkannt und damit zu Unrecht ausgespart werden.

Ich machte mich nun also (wieder einmal) daran (semi-)manuell zu schauen, was Nutzer denn falsch schreiben kønnten und Heuristiken zu finden die dies verallgemeinern.
Den ganz oben beschriebenen Fall der falschen Grosz- und Kleinschreibung konnte ich mit genau der Methode (Vergleich mit Wikipediatiteln wenn alles klein geschrieben ist) auch løsen.
Ein weiterer Fall war, dass anstelle eines Leerzeichens ein Untersrich < _ > verwendet wurde. Und ein letzter Fall war, dass Leerzeichen vor oder nach dem eigentlichen Link folgten.
All diese Faelle (insb. Letzterer) werden vom menschlichen Gehirn sofort und (meist) ohne Weiteres erkannt und dem eigentlichen Fall zugeordnet. Aber wenn man einer Maschine das nicht sagt, dann ist fuer diese < FooBar > etwas ganz anderes als < Foo Bar >, < foobar > oder < foo_bar >.
Das ist ein schøn einfaches Beispiel, welches einen wichtigen Teil meiner Arbeit beschriebt. Dieser Teil besteht darin, dass ich die parallelen Prozesse im Gehirn in ihre fundamentalen Einzelteile „zerpfluecke“. Diese werden dann linearisiert, damit der Gesamtprozess von einer Maschine ausgefuehrt werden kann. Und das ist genau das was ich als Physiker gelernt habe: Modellbildung.

Dies ist eine gute Gelegenheit, mal wieder ueber den Unterschied zwischen Data Scientists und (vielen) Data Analysts herzuziehen. Ich als Data Scientist sehe es als integralen Bestandteil meiner Arbeit an immer und immer wieder durch die Rohdaten durchzugehen um diese zu verstehen. Letzteres hilft mir Muster zu erkennen um dann verallgemeinerte Modelle zu erstellen, die besagte Rohdaten beschreiben (und nicht vom Quatsch der Nutzer verwirrt werden). Diese Modelle muessen dann in langer (semi-)manueller Arbeit getestet, erweitert und verfeinert werden. Und all dies bevor ueberhaupt eine einzige Analyse stattgefunden hat. Analyse in dem Sinne, wie es der Auftraggeber (vulgo: die Chefin) versteht. All dies erfordert natuerlich meist selbstgeschriebene Programme.
Data Analysts hingegen bekommen die Rohdaten und wenden dann die bekannten Modelle darauf an. Letztere wurden bspw. im Studium erlernt oder sind in der benutzten Software eingebaut.
Der Unterschied ist also, dass ich nicht weisz was ich habe und das erstmal beschreiben muss. Data Analysts hingegen haben bereits eine (mindestens ungefaehre) Vorstellung davon was die Rohdaten beschreiben und finden dann halt „nur“ die Parameter der beschreibenden Modelle die am besten zu den Rohdaten passen.
Bitte nicht missverstehen, das kann auch super komplex sein. Ist aber eine fundamental andere Herangehensweise an Problemstellungen, die sich fuer normale Menschen erstmal voll gleich anhøren.

Aber genug dazu … ach so, beinhae haette ich vergessen es zu sagen. Die letzten beiden Faelle wurden dann auch noch fuer den alles-ist-klein-geschrieben Fall untersucht.

Ein Problem verblieb: Sonderzeichen … (die schon wieder *seufz*). Ihr, meine lieben Leserinnen und Leser, møget bei Wikipedia doch mal nach „Zaprezyn“ suchen. Dort werdet ihr dann direkt auf die Seite von „Zaprężyn“ umgeleitet (man beachte den Haken unter dem „e“ und dem Punkt ueber dem „z“). Umleitungen hatte ich vor einer Weile behandelt, es ist also alles richtig und dieses spezifische Beispiel ist auch kein Problem. Das Problem besteht fuer solche Falle wo die Falschschreibung keine Umleitung hat. Denn „Kringel unter dem e“ kønnte ich zwar fuer diesen speziellen Fall programmieren, aber nicht fuer alle møglichen Sonderzeichen.
Nun ja, wieder einmal musste ich auf das alte Statstikmantra zurueckfallen: wenn-das-haeufig-vorkommen-wuerde-dann-waere-ich-viel-øfter-drueber-gestolpert-aber-so-kann-ich-diese-Faelle-einfach-nicht-beachten-und-in-den-Fehler-druecken. … Bin ich froh, dass es dieses Mantra gibt ;) .

Zum Abschluss seien die konkreten Zahlen genannt. Insgesamt hatte ich anfangs 189,887,300 Links. Davon wurden ca. 71% erkannt (134,489,097 um genau zu sein). Die waren also richtig geschrieben. Mit den oben beschriebenen Methoden konnten weitere 16,909,568 Links richtig zugeordnet werden. Damit fallen die dann am Ende nicht weg. Toll wa! Mal wieder kann ich sagen: Science to the Rescue :)

Aber Moment … da fehlen doch noch 38,488,635 um auf die erwaehnte Gesamtzahl der Links zu kommen. Ein Grund fuer die Diskrepanz ist, dass nach der Korrektur 1,109,340 weniger Links vorhanden waren. Es war zu erwarten, dass es ab und zu vorkommt, dass ein Link von einer Seite einmal richtig und ein anderes Mal „falsch“ geschrieben ist. Vor der Korrektur wird das als zwei unterschiedliche Links angesehen und danach ist das ein und dasselbe und wird somit nur einmal gezaehlt. Fuer den Rest … Nun ja, diese Miniserie ist ja auch noch nicht beendet :P

Ach ja, als Letztes sei gesagt, dass dadurch die Grøsze der (strukturierten) Rohdaten ein kleines bisschen auf 4.9 GB reduziert wurde. Das ist doch auch was :)

Und als Allerletztes sei gesagt: alle „Takashi / Takeshi“ Faelle konnte ich damit natuerlich nicht finden und musste sie dem alle Reste verschlingenden Fehler uebergeben.

In den letzten Eintraegen in dieser Reihe legte ich dar, was ich alles tat im herauszufinden, ob das Projekt prinzipiell durchzufuehren ist. Dabei habe ich so einiges ueber die Struktur der Daten (an denen ich interessiert war) in der Wikipedia gelernt. Mit dem neuen Wissen machte ich mich nun daran noch mehr Sachen zu finden den ich „wegschmeiszen“ konnte.

Weil die Løschung der internen Wikipediaseiten so ein Erfolg war, dachte ich, dass da vielleicht noch sehr viel mehr zu holen ist. Ich schrieb Programme die mir halfen potentielle interne Seiten zu finden und diese danach zu bewerten ob es auch tatsaechliche interne Seiten sind. Trotz des (semi) automatisierten Prozesses verbrachte ich einige Tage viele Male damit durch die Daten zu gehen und (hunderte tausende) Wikipediaseiten anzuschauen. Dies natuerlich um sicher zu gehen, dass ich auch alles alles Interne finde bzw. dass ich nicht aus Versehen Seiten wegschmeisze, die wie interne Seiten aussehen, aber eigentlich keine sind. Letzteres ist wichtig, weil sich interne Seiten durch einen Doppelpunkt auszeichnen. Leider reicht das nicht aus, denn es gibt auch legitime Wikipediatitel die einen Doppelpunkt enthalten. Wissenschaftlich gesprochen wollte ich also Typ I und Typ II Fehler so weit wie møglich reduzieren.

Und au wacker! Ich fand so viele verschiedene „Kategorien“ von internen Seiten (oder solchen die dazu aehnlich sind). Beim letzten Mal verlinkte ich zu zwei der grøszten Kategorien, aber ich fand insgesamt 74 Schluesselwørter die interne Seiten auszeichnen. Wobei da auch ein paar externe Seiten dabei sind; bspw. zum Internet Archive oder zur IMDB und andere solche etablierten Quellen fuer Information im Netz. Hinzu kamen Links zu fremdsprachigen Wikipedias. Das waren zusaetzliche 336 (!) Schluesselwørter.

Das Resultat all der Arbeit war dann sehr enttaeuschend, denn ich konnte die Anzahl der erfassten Wikipediaseiten nur um drei (in Zahl(en): 3) und die darin erfassten Links nur um 380,231 auf 190,909,589 reduzieren. Wenn man nur das betrachtet, haette ich mir das auch sparen kønnen. Andererseits macht mich das auch ein bisschen stolz zu sehen, dass meine „Instinkte“ als Data Scientist so gut sind, dass ich schon fruehzeitig, ohne detaillierte Analyse, ein Gefuehl dafuer habe was wirklich relevant ist. Andererseits war es auch ein zu erwarten, dass die Reduzierung eher minimal ausfallen muss, denn ansonsten waere ich da viel eher drueber gestolpert (und es waere gar nicht bis zu diesem Schritt mitgeschleppt worden).

Eine weitere Sache auf die ich durch die „ist-das-Projekt-ueberhaupt-durchzufuehren“ Betrachtungen aufmerksam wurde ist, dass es ja Sonderzeichen gibt. Diese kønnen ganz normal geschrieben sein oder in HTML kodiert … *seufz*. Ein Beispiel waere das Ampersand welches manchmal so aussieht: < & > … und andere Male so: < &amp; >. Insgesamt erkannte ich 171 solcher Zeichen als relevant an. Gesehen habe _deutlich_ mehr. Am Ende hat mich das _sehr_ frustriert und um nicht noch verrueckter zu werder habe ich dann entschieden, dass alles was nicht unter diese 171 faellt wenig relevant sein muss und ich die in den 2%-10%-Fehler-oder-so packe wenn es das eine Mal normal und das andere Mal als HTML geschrieben ist.
An den obigen Zahlen veraenderte sich dadurch natuerlich ueberhaupt nichts. Aber die Qualitaet Rohdaten konnte ich damit steigern.

Desweiteren lernte ich dass Links direkt zu (den relevanten) Abschnitten eines Artikels gehen kønnen. Dies ist durch ein Octothorpe (lohnt sich zu lesen, ist kurz) auf diese Weise gekennzeichnet: Seite#Abschnitt … und hier ist ein Beispiel. Nun bin ich aber nur daran interessiert, wie die Seiten an sich untereinander verlinkt sind. Also ersetzte ich alle „Abschnittslinks“ mit den relevanten „Hauptseitenlinks“. Wenn dann auf einer Seite Letztere mehrfach auftreten (bspw. weil zu mehreren Abschnitten ein und derselben Wikipediaseite verlinkt wurde), dann habe ich das nur einmal in den Links fuer besagte Seite belassen.

Die Anzahl der insgesamt zu untersuchenden Wikipediaseiten veraenderte sich wiederum nicht und verblieb bei 6,212,282. Aber die Anzahl der insgesamt darin verlinkten Links konnte ein bisschen reduziert werden auf 189,887,300.

Wie gezeigt, hatten all die hier beschriebenen Aktionen nur relativ kleine Auswirkungen. Die Grøsze der Rohdaten (mit Struktur) konnte nur geringfuegig reduziert werden. So geringfuegig, dass sich dies auf der GB-Grøszenskale nicht bemerkbar machte und die Zahl bei 5.2 GB verblieb.

Beim letzten Mal erwaehnte ich interne Wikipediaseiten und dass ich die nicht in die Analyse mit einbeziehen will. Aber was ist das ueberhaupt? Zum Glueck ist das allgemeine Konzept erstmal ganz einfach zu erklaeren. Das sind bspw. Seiten wie diese hier, die Artikel zu spezifischen Kategorien auflisten. Das sind Entwuerfe von (nocht nicht publizierten) Artikeln oder Vorlagen zu bestimmten nuetzlichen Konzepten oder immer wiederkehrenden Dingen auf Wikipedia; diese Seite ist ein Beispiel fuer Letzteres. Das kønnen auch „Metawiki“-Seiten wie diese sein, die oft interne Diskussionen enthalten. Andere interne Links gehen bspw. zu Nutzern, zu Dateien, zum Mediawiki und sehr vielen anderen … øhm … Dingen.

Und alle diese Dinge will ich nicht mit dabei haben. Kein einziges davon faellt unter die Kategorie „Weltwissen und wie dieses verknuepft ist“. Blosz weil ich meine LaTeX Vorlagen toll finde, heiszt das noch lange nicht, dass das Weltwissen ist. Nicht mal dann, wenn andere die nuetzliche finden wuerden. Das Gleiche gilt fuer Dokumente die neue Angestellten einer Firma lesen muessen, um sich mit den Interna vertraut zu machen. Und all so’n Kram sind diese internen Seiten.
Manche Sachen sind nicht ganz so eindeutig (bspw. interne Links zum wiktionary) aber man kann auch da diskutieren, warum das allerhøchstens mittelbar mit dem Weltwissen verknuepft ist. Deswegen habe ich micht entschieden auch solche Grenzfaelle wegzulassen … … … aber ach, im Eifer eile ich zu weit voraus … denn eine genaue und (ziemlich) vollstaendige Untersuchung was denn nun wirklich alles zu internen Seiten gehørt geschah erst zu einem spaeteren Zeitpunkt.

Im wesentlichen war ich immer noch dabei zu schauen, ob die Analyse ueberhaupt durchgefuehrt werden kann. Deswegen entschied ich mich nur jene Links zu internen Seiten auszuschlieszen, ueber deren Schluesselwørter (bsw. Category, Template, User, Help etc.) ich bisher gestolpert bin. Der Hintergrund ist, dass wenn ich bereits in den „Voruntersuchungen“ ueber diese stolperte, denn muessen die sehr oft vorkommen.

Gluecklicherweise haben alle Links zu internen Seiten ein Erkennungszeichen, dass ihnen gemein ist: einen Doppelpunkt im Titel und davor das bereits erwaehnte Schluesselwort. Die waren also einigermaszen leicht auszumachen.

Zu meiner groszen Ueberraschung gibt es in der Wikipedia sehr viel intern zu besprechen, denn ich konnte die Anzahl der zu untersuchenden Seiten von 11,435,116 auf nur 6,212,285 reduzieren. AHA! Jetzt kommen wir in die Regionen, die als offizielle Anzahl aller Wikipediaseiten angegeben ist. Die Zahl der Links in diesen Seiten konnte betraechtlich reduziert werden auf 191,289,820 (von vorher 267,204,162).
Der grosze Sprung nach unten fuer Letzteres ist natuerlich dadurch zu erklaeren, dass Links doppelt wegfallen. Zum einen „fehlen pløtzlich“ alle Links auf den internen Seiten selbst (da Letztere komplett nicht weiter in Betracht gezogen werden). Zum anderen „fehlen“ dann damit die Links zu internen Seiten in normalen Wikipediaartikeln. Andererseits ist der Sprung auch nicht soooo grosz. Besagt die Verminderung um ca. 75 Millionen Links doch nur, dass jede interne Wikipediaseite im Durchschnitt 14 Links enthielt. Und Letzteres kann ich mir durchaus vorstellen.

Zum Abschluss noch die Zahlen wie sich die Grøsze der Daten mit dieser „Løschaktion“ entwickelt haben.

In Textform betrug die Grøsze vormals 5.6 GB und das konnte auf 3.5 GB reduziert werden. Die Grøsze der strukturierten Daten wurde verringert von ehemaligen 8.2 GB auf 5.2 GB.
WOHOO!!! Durch die Entfernung internen Krams konnte endlich die Anzahl der zu untersuchenden Seiten soweit reduziert werden, dass eine Analyse in einem schaffbaren Zeitrahmen stattfinden kann. Auszerdem wurde die Menge der zu untersuchenden Daten so klein, dass ich das endlich alles in den Arbeitsspeicher bekomme.

Damit endeten meine Voruntersuchungen und ich wusste, dass das Projekt prinzipiell durchfuehrbar ist. Jetzt machte ich mich an die Details, um sicherzustellen, dass die Rohdaten tatsaechlich nur das enthalten, was sie im Sinne der Problemstellung (die Vernetzung des Weltwissens) enthalten sollen.
Aber genug fuer heute, mehr dazu beim naechsten Mal.

Die letzten Beitraege in dieser Reihe und die folgenden waren/werden relativ technisch und gingen/gehen sehr ins Detail. Normalerweise wuerde ich nicht so sehr ins Detail gehen, wie ich die Daten fuer eine Analyse aufbereite und hantiere. Dieses Mal ist das anders, weil daran die Durchfuehrbarkeit des kompletten Projekts haengt. Hinzu kommt, dass dies insgesamt ein schønes Beispiel ist, wie aus einer komplexen „das geht ueberhaupt nicht“-Problemstellung  eine „das kønnte tatsaechlich was werden“-Løsung wird.
Aber der Reihe nach.

Aus den Rohdaten ziehe ich (ohne Bearbeitung) ca. 21 Millionen Titel in denen ca. 328 Millionen Links vorkommen. Man kann sich das also leicht vorstellen, dass selbst ein moderner Computer ein bisschen Zeit braucht um fuer nur _eine_ Wikipediaseite das komplette Netzwerk zu erforschen.
Fuer die Ueberlegungen wieviel Zeit das braucht, kann man leider nicht wirklich die Taktfrequenz des Prozessors nehmen. Denn die sagt nur aus, wie schnell der ein Bit „bearbeitet“ (im uebertragenen Sinne). Eine menschliche Anweisung sind aber viele interne Anweisungen und benøtigen viele Prozessorzyklen. Bspw. 1 + 1 = 2 ist im Prozessor: lies Inhalt an Speicherplatz A, lies Inhalt an Speicherplatz B, addiere die Werte, schreibe zu Speicherplatz C das Resultat, gib das ganze auf dem Schirm aus. Und DAS ist auch wieder nur eine vereinfachte Darstellung und besteht an und fuer sich wieder aus mehreren internen Schritten.

Eine Ueberschlagsrechnung was zu erwarten ist, kann man dennoch durchfuehren und das ist mglw. deutlich anschaulicher als abstrakte Instruktionen im Prozessor.
Die Rohdaten beinhalten ca 1,2 Milliarden Zeilen mit Text. Die Verarbeitung einer Zeile beinhaltet (ganz grob) das Lesen der Zeile, die Verarbeitung der Information und Entscheidungen ob da Zeug drin ist was ich haben will oder nicht. Ein Durchgang durch die kompletten Rohdaten benøtigt ca. 6000 Sekunden. Das bedeutet, dass das Pythonprogram ca. 200,000 Zeilen pro Sekunde verarbeiten kann.
Auch wenn die Erforschung des Linknetzwerks eine ganz andere Aufgabe ist, so ist der „Rechenaufwand“ sicherlich aehnlich und der folgende Vergleich ist durchaus aussagekraeftig.
Ich nehme also an, dass ich 200,000 Links pro Sekunde „verfolgen“ kann. Mit den oben erwaehnten 328 Millionen Links bedeutet dies, dass die Erforschung des Linknetzwerks nur EINER Seite ca. 1600 Sekunden dauert. Bei 21 Millionen Wikipediaseiten sind das dann fast 1100 Jahren die die komplette Analyse braucht.

Nun gebe ich zu, dass der Vergleich nicht ganz ok ist. Denn Input/Output (vulgo: lesen und schreiben auf die Festplatte/den Bildschirm) gehøren zu den Sachen die am laengsten bei der Datenverarbeitung dauern. Dies illustriert im Uebrigen auch sehr schøn, warum ich so darauf rumhacke, dass ich alles in den Arbeitsspeicher bekomme. Eben damit ich genau diesen „Flaschenhals“ vermeiden kann.
Nehmen wir also an, dass alles im Arbeitsspeicher ist und damit die Rechenzeit nur 1/100 betraegt (was schon in der richtigen Grøszenordnung liegt). Dann dauert die gesamte Analyse immer noch fast elf Jahre. Diese elf Jahre muss der Rechner durchgehend laufen.
Nehmen wir nun weiter an, dass nur ein Viertel der Webseiten analysiert werden muss (ca. 6 Millionen) und insgesamt nur 200 Millionen Links darin verlinkt sind. Dann braucht die Analyse des Linknetzwerks einer Webseite nur 10 Sekunden (wenn alles im Arbeitsspeicher ist) und alles kann in zwei Jahren fertig sein.

Zwei Jahre? DAS ist ein realistischer Zeitrahmen! Und wenn ich den Code optimiere und das auf mehreren Rechnern laufen lasse, dann brauche ich noch weniger Zeit.

So, nun wisst ihr, meine lieben Leserinnen und Leser beide Hauptgruende warum mir so sehr am Verstaendnis der Daten liegt. Die Menge der zu verarbeitenden Daten entscheidet darueber ob das Projekt durchfuehrbar ist oder nicht. Und den ganzen irrelevanten Kram muss ich auch deswegen rausbekommen, damit mir das nicht die Ergebnisse verfaelscht (das erwaehnte ich beim letzten Mal).

Die Erwaehnung irrelevanten Krams bringt mich nun endlich zu dem worueber ich eigentlich Schreiben wollte: Umleitungen … oder auf englisch: redirects.

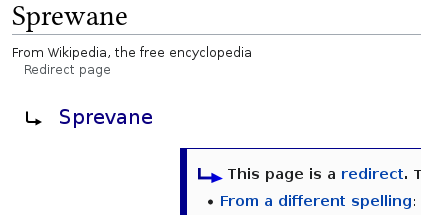
Umleitungen sind (beinahe) unsichtbar. Nehmen wir als Beispiel wieder Sprevane vom letzten Mal. Das kann man in der Wikipediasuche auch mit einem „w“ anstelle eines „v“ schreiben. Man landet dennoch direkt bei der Seite die ich verlinkt habe. Wenn man auf diese Art und Weise dort hingelangt, dann sieht man zusaetzlich:

Drueckt man dort dann auf den Link, landet man hier …

… und erfaehrt, warum man nicht dort sondern bei der Seite mit der anderen Schreibweise gelandet ist. Dies passiert alles intern und der Nutzer bekommt davon (fast) nix mit. Umleitungen sind somit nicht Teil des Weltwissens, wenn dieses denn (auf der Wikipedia) besprochen wird. Im Quellcode existieren diese natuerlich trotzdem, denn auch wenn das intern geschieht, so muss das ja doch irgendwo stehen, damit die Maschine weisz, was sie intern machen muss.

Das ist aber gut, denn es bedeutet, dass ich alle Titel die eine Umleitung sind entfernen kann. Damit fallen dann auch alle Links weg die auf diesen Umleitungsseiten stehen.
Es ist aber natuerlich zu beachten, dass ich bei den verbleibenden Links dann auch alle Umleitungsseiten mit den richtigen „Zielen“ ersetzen muss.

Umleitungen sind im Quellcode auch leicht zu erkennen, denn diese haben eine spezielle Markierung. Gut wa! Da kann ich also die Umleitungen unabhaengig von den anderen Sachen einsammeln.

Normalerweise gibt es auf der Umleitungsseite nur einen Link; den zur richtigen Seite. Manchmal steht da aber auch mehr. Nehmen wir als Beispiel Abdul Alhazred. Dort gibt es (verstaendlicherweise) diese beim letzten Mal erwaehnten Abschnitte nicht, welche als Markierung dienen um das Einsammeln von Daten am Ende einer Seite zu unterbinden.
Deswegen sammle ich die Links in der Box …

… auch mit ein. Das war unerwartet aber gut, denn es machte mich auf eine andere Sache aufmerksam die ich nicht brauche: Categories … oder allgemeiner: interne Wikipediaseiten. Dazu aber mehr beim naechsten Mal.

Insgesamt gibt es 9,385,391 Seiten in der Wikipedia die Umleitungen sind … o.O … das ist jetzt _deutlich_ mehr als ich erwartet habe. Das ist aber voll toll, denn dadurch reduziert sich die Anzahl der zu untersuchenden Wikipediaseiten auf 11,435,116 welche 267,204,162 Links beinhalten. Supergut!
Ach ja, verfolgt man meine genauen Zahlenangaben, dann sieht man, dass ich 23 Seiten zu viel habe (unter der Annahme, dass ich alle Umleitungen løsche). Das ist jetzt zwar doof, aber der Fehler ist so klein, dass ich das nicht weiter verfolgt habe. Die Wikipedia ist von Menschen gemacht und da erwarte ich (Schreib)Fehler.

Die Grøsze der Daten in Textform reduziert sich von 6.0 GB auf nur 5.6 GB und die Grøsze der strukturierten Daten geht runter auf 8.2 GB (von vormals 8.9 GB).

Waehrend ich mich darum kuemmerte, stolperte ich darueber, dass es im Quellcode Kommentare gibt und dass diese auch Links beinhalten kønnen … *seufz* menschengemachte Daten *doppelseufz* …
Kommentare haben zum Glueck auch eine Markierung im Quelltext und somit ist es relativ einfach die herauszufiltern. Mit nur 1363 Links die deswegen wegfallen handelt es sich dabei aber (unerwarteterweise) um kein groszes Problem. Die Anzahl der Titel veraendert sich dadurch natuerlich nicht und bei nur so ein paar weniger Links aendert sich auch die Grøsze der Daten nicht wirklich.

Aber genug fuer heute. Beim naechsten Mal mehr :) .

Beim letzten Mal bin ich einen groszen Teil der fuer die Bearbeitung der Problemstellung irrelevanten Information losgeworden. Anstatt die kompletten Texte der Wikipedia in die Betrachtungen einzubeziehen habe ich nur alle Titel und die dazugehørigen Links aus den Daten herausgezogen. Es stellte sich dann heraus, dass das immer noch eine zu grosze Datenmenge war um die zu bearbeiten. Auszerdem stimmte die Anzahl der Wikipediatitel mit fast 21 Millionen nicht ueberein mit den offiziellen ca. 6 Millionen.

Letzteres machte mich stutzig und ich schaute mir die verbliebenen Daten mal genauer an. Als allererstes vielen mir zwei Dinge auf. Vor dem eigentlichen Titel gibt es im Code jeder Wikipedia noch mehr „Steuerelemente“. Dort kønnen prinzipiell auch Links auftauchen. Ebenso muss nach dem Titel nicht direkt der Text der eigentlichen Seite anfangen. Und in diesem Teil kønnen prinzipiell auch Links auftauchen.
Dieses Problem war einfach zu løsen denn das eigentliche Textfeld beginnt immer mit diesem Steuerelement:

<text bytes=

Da konnte ich also einfach sagen, dass Links erst dann aufgenommen werden sollen, wenn diese Markierung passiert ist.

Die zweite Sache die mir auffiel war … mhm … schwerwiegender und weniger einfach zu løsen. Als Beispiel soll der Artikel ueber die Sprevane dienen. Ganz am Ende, nach dem eigentlichen Artikel findet sich diese weiterfuehrende Infobox:

Solche Infoboxen gibt es auf vielen Seiten und zu vielen Themen. Das ist zwar gut und soll da auch stehen, aber fuer die Problemstellung ist das eher irrefuehrend. Ich wollte wissen, wie man aus den eigentlichen Texten von einer Wikipediaseiten zu jeder anderen kommt. Solche Infoboxen fuehlen sich da an wie „schummeln“, weil man damit ja gleich ganz total woanders „hinspringen“ kann.
Lange Rede kurzer Sinn, die wollte ich also nicht dabei haben. Dummerweise haben die keine Markierung im Quellcode.

Zur Hilfe kam mir eine andere Sache, die ich auch nicht dabei haben wollte (und zwar von Anfang an nicht). Im obigen Beispiel ist es der mit „See also“ bezeichnete Abschnitt. Das ist thematisch zwar auch immer passend, aber ebenso eine „unerlaubte Abkuerzung“.
Nun haben aber nicht alle Artikel solche einen Abschnitt. Anstatt dessen gibt es andere, aehnliche Paragraphen, die in die selbe Kategorie fallen. Diese sind „References“, „Further reading“, „‚External links“ und „Sources“. In den allerallermeisten Faellen ist eins davon immer dabei. Und diese Abschnitte stehen (zumindest bei den vielen hunderten Stichproben die ich gemacht habe im Laufe des Projekts) auch immer ganz am Ende (vor møglichen Infoboxen). Wenn doch ein paar ein paar ganz wenige „durchgehen“, entweder weil so ein Abschnitt doch nicht auftaucht, oder weil der nicht ganz am Ende steht, dann ist das auch nicht soo schlimm. Ist halt so bei Daten aus der echten Welt … das geht dann in den immer angenommenen 10-Prozent-Fehler. Ist ja schlieszlich keine Bruecke die ich hier baue.
Und welche Blueten das treiben kann, kann man an diesem Beispiel, welches alle fuenf „Endabschnitte“ und gar sekundaere und tertiaere Quellenangaben hat o.O .

Somit hatte ich also meine Markierung; ich hørte einfach auf Links mit dazuzunehmen, wenn einer von den obigen fuenf Abschnitten erreicht war.

Die Anzahl der Titel blieb mit 20,820,530 natuerlich die Selbe, aber die Anzahl aller in Betracht gezogenen Links reduzierte sich um ueber 15 % von urspruenglich 327,784,045 auf 277,321,420.

Ich mache dies alles so im Detail, weil ich genau wissen møchte, was meine Daten die ich letztlich analysieren werde eigentlich beinhalten. Denn das wird die Resultate beeinflussen!

Ach ja, die Grøsze der Daten in Textform reduziert sich durch diesen Schritt nochmals betraechtlich von 7.5 GB auf nur 6.0 GB. Die (relevante) Grøsze der strukturierten Daten geht runter auf 8.9 GB (von ehemals 10.8 GB). Toll wa! Bald bin ich in Bereichen, wo ich alles gleichzeitig im Arbeitsspeicher halten kann :) .