Archive for the ‘Kevin Bacon’ Category

Beim letzten Mal schrieb ich, dass die Wikipedia Rohdaten ca. 75 GB (75.4 GB um genauer zu sein) grosz sind. Das ist viel zu viel um das im Arbeitsspeicher zu haben.
Und selbst wenn man so viel Arbeitsspeicher haette, ist das meiste davon Information, die nicht relevant ist fuer die eigentliche Problemstellung.

Mein erstes Ziel war somit Information loszuwerden die ich garantiert nicht brauche.
Im Wesentlichen bedeutete dies, den Text und die „Steuerelemente“ loszuwerden. Letztlich ist ja ALLES Text und deswegen ist Letzteres so wichtig. Denn das ist der Code, der dem Browser klarmacht, dass bspw. ein Wort fett oder kursiv sein soll, an welche Stelle ein Bild kommt, was ein Link ist oder das eine Sequenz von Wørtern eigentlich der Titel sind (und vieles, vieles mehr).

Und die letzten beiden Sachen sind die einzigen Dinge an denen ich interessiert bin.

Und hier kommt eine andere Sache ins Spiel, die vøllig normal fuer einen Datascientist (aber oft nicht fuer einen Dataanalyst) ist: sich die Rohdaten anschauen um herauszufinden wie die Information darin ueberhaupt strukturiert ist.
In diesem Falle war das einfach, weil ich ja den „Quellcode“ der Wikipedia hatte. Das war also alles schon super toll durchstrukturiert, denn eine Maschine muss ja im Stande sein das zu interpretieren und richtig darzustellen. So schøn anzusehen Bilderhandschriften sind, so ist das nicht von Webbrowsern (ohne Weiteres) interpretierbar. Da sitzt erstmal ein Mensch und „uebersetzt“ die in einer solchen Seite vorhandene Struktur in allgemeine (maschineninterpretierbare) Regeln.

Dieser Prozess ist oft ermuedend und langweilig. Aber nicht minder oft lerne ich dabei auch ’ne ganze Menge … insb. natuerlich bei diesem Projekt, da die Rohdaten die Wikipedia sind … hach, was hab ich alles gelesen :) .
Oft fasst man sich auch an’n Kopp oder rauft sich die Haare (nicht nur im bildlichen Sinne!). Das beinhaltet dann meist von sog. „Nutzern“ erstellte Daten. Und davon hatte ich hier auch ’ne ganze Menge.

Wieauchimmer, ich will also den Titel einer Seite und die im Text vorhandenen Links.
Der „Code“ einer Wikipediaseite ist sehr sehr aehnlich dem HTML-Quelltext jeder anderen Webseite. Letzteren bekommt man in Firefox angezeigt, wenn man < CTRL + U > drueckt.
Das ist gut, denn bedeutet dies doch, dass der Titel leicht zu finden ist, denn dieser befindet sich immer zwischen diesen beiden „Markierungen“:

<title>  TitelDerWikipediaseite  </title>

Das meine ich mit Struktur und warum das kleine (aber starke) Wort „immer“ im vorherigen Satz steht.

Links sind etwas komplizierter und ich werde auch an anderer Stelle nochmal auf diese zurueck kommen. In HTML sehen Links so aus:

<a href="LinkZurSeite" title="NameDerSeite">Das was im Text steht und blau und unterstrichen ist</a>

Im Code der Wikipedias ist das deutlich kuerzer. Links befinden sich dort in doppelten eckigen Klammern:

[[TitelDerWikipediaseite | blauer, unterstrichener Text ]]

Der Teil rechts von der „Pipe“ (keine Ahnung wie < | > im dtsch. heiszt) ist optional. Links davon kann auch eine URL einer externen Seite stehen. Das kommt vor aber nicht so haeufig.
Wichtig ist, dass die Struktur (wieder) immerzu das Gleiche ist.

Wenn man den ganzen Text weg laeszt und nur den Titel einer Seite und die Links behaelt, kann ich die Datenmenge um 90 Prozent (!) reduzieren von 75.4 GB auf nur 7.5 GB.
Dummerweise ist das in Textform. Als Rohdaten ist Textform super. Bei der Datenanalyse kønnte ich auch direkt mit Text arbeiten, dass ist aber schwerfaellig. Es ist besser die Information in Datenstrukturen zu „verpacken“, sogenannte Zuordnungstabellen. Das ist eine Art „Metastruktur“ und erleichtert die Handhabung der Daten immens! Handhabung bedeutet hier, lesen und schreiben von Daten.
Das bedeutet ich muss nicht jedes Mal durch jede Zeile eines Textdokuments durchgehen, bis ich eine spezifische Seite (und deren Links) gefunden habe. Innerhalb der „Metastruktur“ sage ich dann bspw. nur …

Ich habe hier einen gewissen Titel; gib mir alle dazugehørigen Links an

… und das wird dann direkt gefunden. In einer Bibliothek wuerde ich sozusagen die Nummer des Buecherregals nehmen (als „Titel“)  und alle Buecher darin entsprechen den Links.

(Beinahe) dito, wenn ich etwas mit den Links machen muss (Spoiler: dazu mehr in einem spaeteren Artikel):

Ich habe hier einen gewissen Titel; løsche alle Links die ein "A" enthalten

Das Problem ist nun, dass die interne Praesentation der Metastruktur Platz braucht. Ich erkaufe also Nuetzlichkeit mit Speicher. So wie ein Buecherregal und die Luft zwischen den Buechern mehr Platz braucht als wenn man Buecher einfach nur auf dem Boden stapelt. Da frage ich mich doch, wieviel weniger Platz die (nicht digitalen) Dokumente (also auch sowas wie Bilder und chiesische Vasen, etc. pp.) dieser Welt brauchen wuerden, wenn das nicht in Regalen (und aehnlichem) sortiert waere. Das sieht man ja bspw. wenn beim Umzug alles in ein paar Kartons dicht gepackt ist. Und darauf folgt dann die Frage, wie grosz die Effizienzsteigerung der Verwaltung ist (sei es beim Staat, bei der Schule oder im eigenen Haushalt) eben durch die Nutzung von Metastrukturen/Buecherregalen.

Wieauchimmer, durch den erhøhten Speicherbedarf ist die obigen Angabe etwas irrefuehrend. Klar, die Information an sich braucht nur 7.5 GB. Damit ich damit aber was (vernuenftiges) machen kann, brauche ich besagte Datenstrukturen und dadurch erhøht sich der Speicherbedarf auf 10.8 GB.
Wenn ich im weiteren Angaben zur „Grøsze der Daten“ mache, dann meine ich damit ab sofort immer inklusive der Anordnung in Datenstrukturen.

So, das war ein ganz schøn technischer Abstecher. Die 10.8 GB sind immer noch zu viel um das alles gleichzeitig im Speicher zu behalten. Zum Glueck (irgendwie) enthaelt die reduzierte Information (die aussoprtierten Titel und Links, ohne den Text und Steuerelemente) noch ’ne ganze Menge „Zeug“ welches nicht gebraucht wird zur Bearbeitung des Problems gebraucht wird (oder gar zu nicht ganz richtigen Resultaten fuehren wuerde). Dazu aber mehr im naechsten Artikel.

Ach ja, in den reduzierten Daten habe ich 20,820,530 Titel und diese beinhalten insgesamt 327,784,045 Links.
Moment 20,820,530 Titel und jeder Titel entspricht einer Wikipediaseite? Ich sagte doch ganz am Anfang, dass es nur 6 Millionen gibt. Nun ja, beides ist richtig, aber mehr zur Løsung dieses Raetsels in einem der folgenden Artikel.
Als „Rohdaten“ ist natuerlich die (englische) Wikipedia zu verstehen. Und JA, die kann man _komplett_ runterladen … also ohne Bilder und Videos und sowas … aber wenn man wuenscht, kann man das auch von den offiziellen Quellen nachladen … aber das wuensche ich nicht fuer dieses Projekt.

Zunaechst einmal ist es supercool, dass das ueberhaupt geht … soviel wusste ich … und dann ging’s auch schon los mit der Frage: Wie komme ich an die Daten die ich brauche um die Fragestellung zu bearbeiten?
Das ist uebrigens total normal fuer Data_scientists_. Uns werden Fragen gestellt und wir kønnen dann zusehen, wie wir die beantworten. Ist wie bei normaler Wissenschaft.
Data_analysts_ hingegen kriegen die (oft schon gut vorbereiteten) Daten gegeben und muessen die dann „nur“ analysieren.
Im Laufe der Serie werde ich ein bisschen mehr darauf eingehen, worin ich die Unterschiede sehe zwischen diesen beiden Berufen. Das soll nicht falsch zu verstehen sein. Dataanalysts haben oft ziemliche hohe Kompetenzen in der Datenanalyse die ich nicht habe. Aber Hinz und Kunz die ’n Fragebogen erstellen, dann die paar hundert Antworten ’ner regulaeren statistischen Analyse unterziehen und das ganze oft in einem bekannten Tabellenkalkulationsprogramm oder mit gekaufter proprietaerer Software, ohne zu wissen oder zu reflektieren was dahinter steckt (nicht nur bei der Software, sondern auch bei den Modellen), bezeichnen sich heutzutage so. Und ’s geht mir gegen den Strich, dass ich mit besagten Hinz und Kunz (nicht mit denen die wirkliche Kompetenz haben) in einen Topf geworfen werde. Und ja, ich rege mich hier ueber Kollegen einer anderen Zweigstelle auf … aber das mache ich nur wegen meiner Eitelkeit und weil ich eingebildet bin. Deswegen versuche ich das auf ein Minimum zu reduzieren.

Ich schwoff ab.

Zunaechst wusste ich zwar, dass man die Wikipedia runterladen kann, aber ich wusste nicht wo.
Schritt Null war dann eine allgemeine Suche im Internet und das lesen von ein paar Weblogartikeln. Dabei fand ich die offizielle Wikiepedia-komplett-runterladen-Seite.
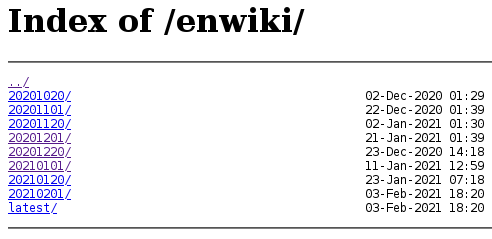
Dort navigierte ich fix zum Abschnitt „Where do I get it?“ und das fuehrte mich hierhin, wo ich begrueszt wurde von diesem spartanischen Design …

… … … … wait what? … und war erstmal verwirrt. Es brauchte ein bisschen vorwaerts / rueckwaerts / seitwaerts klicken um immer wieder hier zu landen. Das war also richtig.

Ich nahm das Backup vom 2020-12-20 was mich mich auf die naechste Seite fuehrte (ich frage mich, ob es die in einem Jahr noch gibt). Die Information dort war dann VIEL mehr und ich musste erstmal herrausfinden worum es sich bei all diesen Sachen handelt.
Nachdem ich mich ein bisschen informiert (und probiert) hatte, entschied ich mich fuer die Datei mit dem leicht zu merkenden Namen „enwiki-20201201-pages-articles-multistream.xml.bz2“.

Toll wa! Das Wissen der Welt ist komprimiert und ohne Bilder nur 17.7 GB grosz. … Unkomprimiert sind es ca. 75 GB. Das ist zwar deutlich mehr, aber jetzt auch nicht soooo viel. Schon krass, wie gut Komprimierungsalgorithmen sind. Ist ja bei mp3 oder den Videocodecs nicht anders. Menschlicher Einfallsreichtum par excellence.

Nun hatte ich was ich wollte und war einen Schritt naeher an der Beantwortung der Frage. Zu dem Zeitpunkt ahnte ich noch nicht, dass es noch ziemlich viele Schritte werden bis ich die Antwort in den Haenden halten konnte.
Eine Sache war mir aber klar: die 75 GB; das konnte ich nicht alles gleichzeitig im Arbeitsspeicher behalten. Geschweige denn sich „kreuzende“ Berechnungen ueber alles auf alles daran zu machen. Wie ich dieses Problem (schrittweise) løste, stelle ich in den kommenden Artikeln vor.

Das Konzept der Erdős Nummer ist ja bekannt … wenn nicht, dann empfehle ich diesen XKCD … tihihi.
Meine Erdős Nummer ist vermutlich 7. Es ist aber auch nicht allzuweit hergeholt dass es eine 5 ist. Und unter ganz guenstigen Umstaenden kønnte es sogar eine 4 sein, das bezweifle ich aber.

Das Erweiterte Konzept der Six degrees of separation, ist vermutlich bekannter. In kurz besagt dieses, dass im Durchschnitt jeder Mensch mit jedem anderen Menschen ueber nur 6 andere Leute verbunden ist.
Ich bspw. bin ueber nur 4 Verbindungen mit Fidel Castro verbunden. Ich habe mal jemanden getroffen deren Sohn (oder war’s der Bruder?) zusammen mit Fidels Bruder an einem Agrarprojekt gearbeitet hat.
Noch besser ist meine Verbindung zu TOOL. Dorthin huepfe ich ueber nur drei Verbindungen, denn eine Bekannte von mir hat mal direkt mit dieser Dame zusammengearbeitet. Toll wa!

Die Studien zu diesem Phaenomen deuten zwar in die Richtung dass die Annahme vermutlich schon stimmt, sind aber im Wesentlichen auch nicht ganz eindeutig. Dies liegt daran, weil das schwer zu testen ist (denn solche Ketten muss man ja nachvollziehen). Oder es steckt viel Voreingenommenheit mit drin, weil bspw. Prominente haeufiger auf den sog. „sozialen Kanaelen“ zu finden sind als Leute wie ich.

Six Degrees of Kevin Bacon ist das gleiche Konzept wie die Erdős Nummer … das ist so gleich, dass man direkt sagen kønnte, dass es das Selbe ist (nur mit Kevin Bacon) … und daher kommt auch der Name dieser Miniserie (weil ich’s lustig finde).

Dieses Spiel kann man beliebig fortsetzen, bspw. mit der Erdős-Bacon Nummer oder noch eins drauf mit der Erdős-Bacon-Sabbath Nummer.

In eine allgemeinere Richtung geht Six Degrees of wikipedia.
Allgemeiner deswegen, weil es nicht nur schaut, wie Personen miteinander verknuepft sind, sonder wie im wesentlichen die gesamte Welt (streng genommen gar das gesamte uns bekannte Universum) miteinander verknuepft ist.
Zugegeben, das ist sehr zentriert auf die sog. „westliche Welt“, weil das nunmal der „Ort“ ist, in dem die Wikipedia geschrieben wird. Aber das tat dem keinen Abbruch, dass mich diese Idee faszinierte. Wie kommt man von Trondheim zu Kevin Bacon? (Via Monty Python geht’s zu Tom Hanks und dann direkt zu Kevin.)

Fuer so ein paar konkrete Fragen war dieses Spielzeug ganz nett. Aber ich wollte mehr wissen. Ich wollte wissen, wie alles mit allem anderen zusammenhaengt.
Mein Interesse wurde noch gesteigert, als ich nach mehreren Versuchen immer drei Verbindungen (in seltenen Faellen zwei oder vier) erhielt.

Die meisten Leute sind dann sicherlich den kuerzesten und laengsten Verbindung interessiert (bzw. nach den Wikipediaseiten die gar keine Verbindung haben) und begnuegen sich mit ein paar Beispielen.
Beispiele sind fuer mich aber nur sowas wie Anekdoten und ich fragte mich, wie wohl die Verteilung der Verbindungen ALLER Wikipediaseiten aussieht. Da dies im wesentlichen die (komplette) Statistik der Verlinkungen ist, beinhaltet das natuerlich die obigen zwei (drei) Faelle … ’s ist aber grøszer angelegt … so grosz, dass ich mir dachte: Jawoll! Ich schau mal ob ich das komplette (interne) Wikipedialinknetzwerk analysiert bekomme … als von _jeder_ Seite zu _jeder_anderen Seite.

Um eine Vorstellung von der Wahnwitzigkeit dieser Idee zu bekommen, møge man mal sechs Millionen mal sechs Millionen ausrechnen. Es gibt naemlich ca. 6 Millionen Wikipediaseiten und alles ist mit allem verbunden. Nur ich will halt nicht nur diese Zahl wissen, sondern das auch noch aufgeteilt auf die „Stufe der Verlinkung“, oder das „Linklevel“ wie ich’s nenne.

Und ueber diese „Reise“ handelt diese Miniserie. Weil ich’s so toll (und oft genug auch frustrierend) fand. Weil ich total viel gelernt habe (nicht nur durch das Lesen vieler, vieler Wikipediaseiten sondern auch durch das Programmieren der dafuer nøtigen Werkzeuge). Und weil ich total viel Freude an all den tollen Sachen hatte ueber die ich in der Wikipedia gestolpert bin.

Ich versuche an den Schritten die ich gehen musste (und die ich in den Artikel im groben nachvollziehen werde) ein bisschen deutlich zu machen, wie denn mein „Arbeitsalltag“ als sog. „Datascientist“ so aussieht. Was es bedeutet, (viele) Daten zu analysieren … denn die Analyse an sich steht meist erst ganz am Ende und macht nur ca. 20 % der eigentlichen Arbeit aus … auch wenn das dann das Einzige ist, was man rumzeigt.
Dadurch werden die kommenden Artikel aber zum Teil relativ technisch und die bunten Graphen gibt’s erst ganz am Ende. Ehrlich gesagt, waehrend ich dies schreibe sind die bunten Graphen noch in weiter Ferne, denn die Analyse des kompletten Linknetzwerks der wikipedia dauert mehrere Wochen (siehe die 36 Millionen Millionen Verbindungen die ich oben erwaehnte) … und das obwohl ich das gerade auf 4 Rechnern gleichzeitig rechnen lasse.