Archive for the ‘Kevin Bacon’ Category

Selbstzitierungen … habe ich urspruenglich als Selbstreferenzen bezeichnet und dabei bleibe ich auch … konnte mir die Benutzung des anderen Wortes (mit gleicher Bedeutung) aber aufgrund der zeitlichen Naehe zu dieser Miniserie nicht verkneifen.

Wieauchimmer, mit Selbstreferenzen sind alle Links gemeint, die auf den Ursprung (also die Seite dessen Linknetzwerk ich gerade untersuche) (zurueck) verweisen. Das Konzept ist ja recht einfach zu verstehen.
Nach dieser kurzen Auffrischung bereits bekannter Dinge steige (wie immer) als Erstes ein mit der Summe aller Selbstreferenzen ueber alle Seiten pro Linklevel. Es ist die rote Kurve im linken Diagramm in diesem Bild:
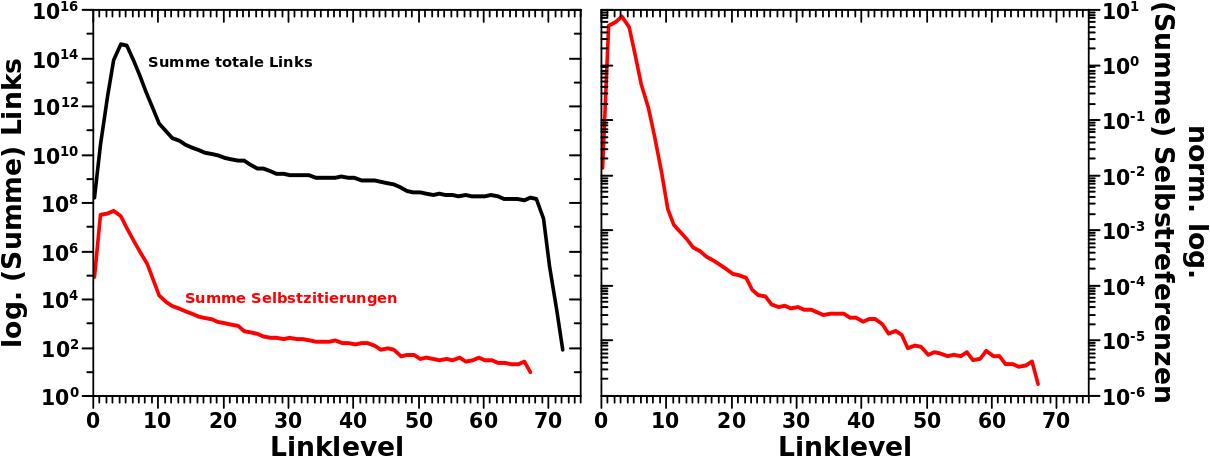
Zum Vergleich habe ich wieder die gleiche Grøsze fuer die totalen Links in schwarz dazu gepackt. Wie zu erwarten ist die Anzahl der Links die zum Ursprung zurueck gehen massiv kleiner als die Anzahl aller Links auf einem Linklevel.

Interessant ist, dass das Maximum augenblicklich auf LL1 erreicht wird. Das das schnell hoch geht ist jetzt  nicht soooo ueberraschend, denn die Anzahl der Selbstreferenzen ist natuerlich eine Funktion der Anzahl der totalen Links. Je mehr ich von Letzteren habe um so mehr Selbstreferenzen sollten (naiv angenommen) auftauchen. Aber dass diese Aussage dann nur noch bedingt gilt, die Anzahl der totalen Links nimmt weiter zu, die der Selbstreferenzen aber nicht, ist aber (wie gesagt) interessant.
Auszerdem ist das Maximum doppelt so breit im Vergleich mit allen anderen Verteilungen und zieht sich von LL1 bis LL4. Wieder: da die Anzahl der totalen Links weiter zu nimmt, wuerde das darauf hindeuten, dass die relative Anzahl der Selbstreferenzen ebenso schnell abnehmen muss. Ich komme darauf beim naechsten Mal zurueck.

Ansonsten ist die Form und der Verlauf der Kurve keine Ueberraschung und folgt im Wesentlichen der ausfuehrlich besprochenen Kurve der totalen Links.
Zu erwaehnen sei, dass die ca. 80k Selbstreferenzen auf LL0 Artefakte sind. Das sind Seiten, die Links zu anderen Abschnitten auf der selben Seite haben. Die haetten rausgeschmissen werden sollen und ich liesz mich darueber bereits an anderer Stelle aus.

Im linken Diagramm habe ich (wieder) die rote Kurve grob auf 6 Millionen Seiten normiert, denn ich wollte (wieder) mal wissen, wie vielen Selbstreferenzen ich im Durchschnitt pro Linklevel begegne.
An dieser normierten Kurve kann man ein paar Sachen deutlicher sehen, als an den absoluten Zahlen der vorher besprochenen Summe der Selbstreferenzen … normierte Daten haben das oft so an sich, dass man Sachen besser sieht; deswegen ist Normierung ja sehr oft auch das Erste was ich mit Daten mache.

Wieauchimmer, man sieht bei LL0, dass nur ca. 1 von 100 Seiten zu Sektionen auf der selben Seite (also sich selbst verweisen). Das ist zwar ein Artefakt, aber es ist gut zu wissen, wie grosz der Einfluss ist und dieses Resultat bestaetigt mein hier ausgedruecktes Bauchgefuehl, dass ich das „in den Fehler druecken“ kann.
Danach habe ich dann von LL1 bis LL4, im Durchschnitt 6 Selbstreferenzen. Da haette ich auf LL1 (deutlich) mehr erwartet; dies aus dem Grund, weil ich dachte, dass es mehr hin-und-wieder-zurueck-Linkschleifen gibt.
Bei „mittleren“ Linkleveln um ca. LL30 kann ich eine Selbstreferenz nur noch bei zwei von hunderttausend Seiten erwarten. Das scheint sinnvoll zu sein, denn so weit weg vom Ursprung, sollte eine (neue) Seite rein gar nix mehr mit dem Anfang zu tun haben. Weswegen sollte diese dann aber auf eben jenen verweisen?

Das Ende der Kurve ruehrt (immer noch) von dem ausfuehrlich besprochenen Artefakt her und Selbiges erklaert auch die Werte. Ich erinnere daran, dass besagtes Artefakt die Saisons eines suedamerikanischen Fuszballklubs sind. Desweiteren lande ich am Ende immer auf den selben Seiten; eben jene Saisons. Ich kann mir durchaus vorstellen, dass im Durchschnitt bei jeder dieser Saisonseiten fuer fuenf Urspruenge (andere Saisons, Fuszballspieler oder (andere) -klubs) eine Selbstreferenz erscheint. Das wuerde zu ca. 100 Seiten im Dunstkreis dieses Fuszballklubs fuehren … diese Abschaetzung scheint plausibel.

Nun ja, das soll genug sein. Wie bei den neuen Links werde ich auch diese Zahlen durch die (relevanten) Auswertungen schicken. Ich denke nicht, dass ich dabei was Neues entdecken werde.
Beim naechsten Mal normiere ich dann aber zunaechst diese Summe der Selbstrefernzen auf die Anzahl der totalen Links (pro Linklevel) … denn das habe ich ja oben bereits (indirekt) angekuendigt.
Beim letzten Mal bemerkte ich, dass es so aussieht, als ob die individuellen Verteilungen der totalen bzw. der neuen Links mglw. um einen konstanten Faktor „springen“.

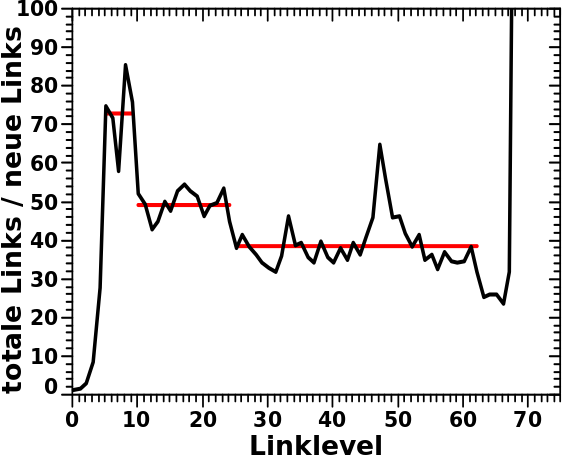
Deswegen schaute ich mir mal das Verhaeltnis aus der Anzahl der totalen und der neuen Links an:

An diesem Bild ueberraschte mich zunaechst, dass meine Vermutung sogar richtig war. Desweiteren ueberraschte mich wie grosz das Verhaeltnis ist. Auf den ersten Blick haette ich aus den erwaehnten Spruengen so Pi-mal-Daumen einen Faktor zehn vermutet. Bei genauerem Hinschauen wuerde ich aber sagen zwischen ca. 10 und 100. Und das ist ja auch das was man hier sieht.

Von Anfang und Ende abgesehen, wuerde ich den Grafen prinzipiell in drei Abschnitte einteilen. Die roten horizontalen Linien stellen den Mittelwert dieser Abschnitte dar.
Als Erklaerung fuer den ersten Abschnitt wuerden wieder vielzitierte Seiten mit vielen Links herhalten. Weil diese oft zitiert werden, tragen sie sehr stark zur Anzahl der totalen Links bei. Aber aus dem selben Grund tragen sie nicht zu den neuen Links bei, denn oft geschieht deren Zitierung schon auf den allerersten Linkleveln.
Der zweite Abschnitt kønnte durch „mittelhaeufig“ zitierte Seiten zustande kommen, wird aber immer noch durch die vielzitierten Seiten beeinflusst. Diese mittelhaeufig zitierten Seiten haben weniger totale Links und das Verhaeltniss geht runter. Dafuer gibt es davon mehr und der Bereich zieht sich auf der Abszisse laenger hin. Prinzipiell kønnte „mittelhaeufig“ durch grosze, weitschweifende, sich ueber viele Seiten verteilende, aber nicht super wichtige Themengebiete zustande kommen. Ein Beispiel waere Skisport oder Wissenschaft.
Im dritten Abschnitt dann haben wir mehr oder weniger obskure Seiten die selten zitiert werden und mit wenigen totalen Links. Die Ursachen der ersten beiden Abschnitte wirken natuerlich auch hier noch mit rein.

Andererseits sind die Unterschiede in den durchschnittlichen Verhaeltnissen dieser Abschnitte jetzt auch nicht sooooo grosz; nicht mal ein Faktor zwei. Auszerdem habe ich mit dem Ausdenken zu den Ursachen von visuellen Abschnitten schonmal gehørig daneben gegriffen. Deswegen bilde ich mal nur den Durchschnitt ueber alle drei dieser Abschnitte und erhalte einen (durchschnittlichen) konstanten Faktor von ca. 44.
Das bedeutet, dass ich, nach dem „explosiven“ Anfang, im Durchschnitt schon 44 Links gesehen habe, bevor ich auf einen treffe, der neu ist. Auch wenn mir das jetzt ziemlich viel vorkommt, so wundert es mich auch nicht so richtig. Denn die vielzitierte Seiten mit vielen Links dominieren das Linknetzwerk gerade ganz zu Anfang komplett … aber das wurde ja bereits mehrfach diskutiert.

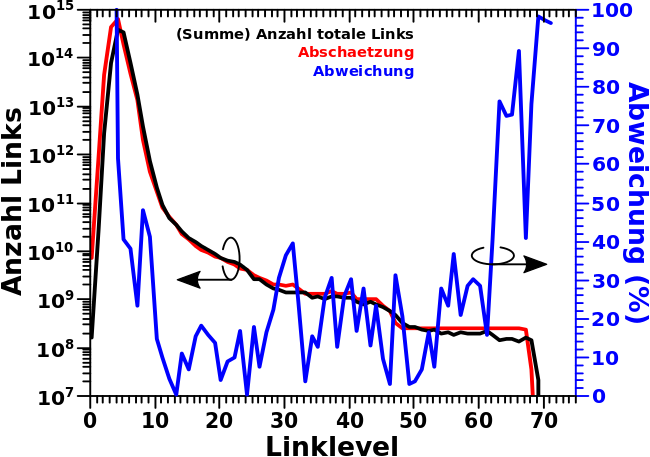
Wieauchimmer, ich habe mal die Anzahl der neuen Links per Linklevel mit diesem konstanten Durchschnittsfaktor multipliziert. Das ist die rote Kurve in dieser Abbildung:

Der visuelle Vergleich mit der schwarzen Kurve, welche die schon so oft gezeigte Summe der totalen Links per Linklevel darstellt, ist erstaunlich gut.

Fuer die blaue Kurve (rechte Ordinate) sah ich die Summe der totalen Links als „wahren“ Wert an. Dann bildete ich die Differenz der beiden zuerst erwaehnten Kurven und setzte diese Differenz mit dem „wahren“ Wert ins Verhaeltnis. Dieser Wert ist dann die prozentuale Abweichung der Abschaetzung vom wahren Wert.
Wie man sieht, ist die Abschaetzung gar nicht mal so uebel und die Abweichung liegt ueber weite Bereiche um 20 %. Nur 20 % Abweichung ist bei Daten aus der echten Welt, sehr groben Vereinfachungen und aeuszerst simplen Annahmen durchaus gut. Zu beachten ist auch, dass selbst eine Abweichung von 100 % nur einem Faktor (der nichts mit dem konstanten Faktor zu tun hat) von zwei  entspricht.
Ganz am Anfang ist die Abschaetzung natuerlich deutlich schlechter. Das liegt daran, dass dort im Wesentlichen die Anzahl der neuen Links der Anzahl der totalen Links entspricht. Dies mit einem konstanten Faktor zu multiplizieren fuehrt natuerlich zu Quark.

Abschlieszend sei zu sagen, dass es mitnichten haette so sein muessen, dass die eine Grøsze aus der anderen mithilfe eines konstanten Faktors berechnet werden kann. Genausogut haette der Faktor auch stetig (im Sinne von Differenzierbarkeit) abnehmen kønnen. Eine unstetige Abnahme wird so’n bisschen durch die erwaehnten drei Abschnitten suggeriert. Aber ich bin, wie gesagt, diesmal lieber etwas vorsichtiger mich da festzulegen.
Spaeter komme ich unter Umstaenden aber vielleicht doch nochmal auf die drei Abschnitte zurueck. Die hier im Detail erklaerte Messgrøsze kønnte mir mglw. erlauben solche Gruppen zu erkennen. Wenn dem aber nicht so ist, werde ich das still und schweigend einfach nicht mehr erwaehnen :P

Damit bin ich mit den neuen Links durch. Beim naechsten Mal geht’s dann mit den Selbstzitierungen los.

Fuer die Anzahl der totalen Links schaute ich mir die Verteilungen pro Linklevel an. Dies fuehrte zu Betrachtungen bzgl. der beobachteten Resultate, welche ich in die Begriffe „Zustandsdichte“ und „Phasenuebergaenge“ verpackte. Mindestens Letzteres stellte sich schlussendlich als nicht haltbar heraus, aber die Betrachtungen waren durchaus interessant — das hat das Spielen mit Daten nunmal an sich.

Bei den neuen Links wuerde ich bei den Verteilungen pro Linklevel im Wesentlichen beinahe das Selbe erwarten. Der einzige bedeutende Unterschied, von den bereits beim letzten Mal erwaehnten Schwankungen abgesehen, sollte nur sein, dass die Verteilungen auf der Abszisse nach links verschoben sind. Der Grund liegt natuerlich darin, dass ich weniger neue als totale Links habe (was ja in dieser Reihe schon mehrfach erwaehnt wurde).

Als Konsequenz dieser Erwartungen folgt, dass die grundsaetzliche „Form“ der Verteilung erhalten bleiben muss.
Bei LL0 ist das trivial, denn ganz am Anfang sind im Wesentlichen alle Links auch neue Links … abgesehen von Selbstreferenzen, aber darauf komm ich an anderer Stelle zurueck (zum Glueck fallen die nicht so sehr ins Gewicht).

Der Vergleich der Verteilungen bei LL1 sieht so aus:

Siehste! Man sieht das was ich oben schrieb. Toll wa!

Ich gebe zu, dass auch LL1 irgendwie „geschummelt“ ist, denn die Situation ist ja immer noch sehr aehnlich zu LL0. Deswegen springe ich mal vorwaerts zu LL9 (und ihr, meine lieben Leserinnen und Leser muesst mir einfach glauben, dass das oben Geschriebene auch fuer alle Linklevel dazwischen gilt).

Aha! Die Verteilung der neuen Links ist nach links verschoben und beide Verteilungen haben drei „Berge“; es bleibt also auch eine „komplizierte“ Form erhalten. Der dritte Berg ist in der Verteilung der totalen Links visuell deutlich schmaler. Ich denke, dass es sich hierbei wieder um eine Art der logarithmischen Komprimierung handelt.

Da zu høheren Linkleveln hin nicht mehr viel passiert und weil diese Verteilungen bereits frueher so ausfuehrlich diskutiert wurden, schaute ich mir nur noch zwei Verteilungen an; bei LL20 und LL30. Alles lag innherhalb der Erwartungen und zum „Beweis“ sei nur noch LL30 gezeigt:

Die vielen zu sehenden Phaenomene und Effekte in den Daten diskutierte ich, im Zuge der Betrachtungen zu den totalen Links, bereits im Detail . Darauf aufbauend, und weil (wie zu erwarten war) keine grosze Unterschiede bei den Daten zu den neuen Links auftauchten, konnte ich die Diskussion diesmal zu kurz halten. Fuer erstere Betrachtungen brauchte ich 20 1/2 Beitraege in dieser Serie, die sich ueber 4 1/2 Monate erstreckten. Diesmal waren es nur 2 1/2 Beitraege ueber 2 Wochen. Ist ja auch mal schøn, wenn ich mich kurz halten kann.

Ganz fertig bin ich aber noch nicht mit den neuen Links. Die Spruenge in den oberen Bildern scheinen immer ueber ungefaehr eine Grøszenordnung zu gehen. Jaja, ich weisz, es sind nur zwei „Messpunkte“, aber dies kønnte ein Hinweis darauf sein, dass es mglw. auf jedem Linklevel einen (mehr oder weniger) konstanten Faktor zwischen der Anzahl der totalen Links und der Anzahl der neuen Links gibt. Prinzipiell kønnte ich mir einen Mechanismus denken, wieso das so sein sollte.
Aber ich greife vor und verschiebe diese Untersuchungen und Diskussion auf den naechsten Beitrag.

Bei den Betrachtungen zu den totalen Links pro Linklevel musste ich zunaechst eine Erklaerung finden, warum der Anstieg der totalen Links am Anfang so sehr viel staerker ist als erwartet.
Dies fuehrte letztlich dazu, dass ich den Zusammenhang zwischen der Anzahl der Zitierungen die eine Seite auf sich vereint und der Anzahl der totalen Links der selben Seite untersuchte. Die Quintessenz dieser Untersuchungen drueckt sich so klar in diesem schøne Ergebniss aus.

Das mache ich selbstverstaendlich nicht nochmal, denn das waere nicht sinnvoll. Der Grund ist, dass wenn ich nur eine Seite und nicht deren Linknetzwerk betrachte, alle Links auf dieser Seite neu sind. Dies ist natuerlich unabhaengig von der Anzahl der Zitierungen dieser Seite.

Danach schaute ich mir die „Spaetzuender“ an. Dies waren Seiten, bei denen das Maximum der indivduellen Verteilung der totalen Links pro Linklevel deutlich  vom Maximum der Summe der Verteilung abweicht.
So richtig _deutliche_ Abweichungen fand ich nicht, und die Seiten bei denen die Position des besagten Maximums am meisten abweicht, waren entweder „Rohrkrepierer“, „komische Seiten“ oder eine unguenstige Verkettung von Artefakten, welche aus der Datenaufbereitung stammten. Im verlinkten Artikel wurde dies alles genau beschrieben.

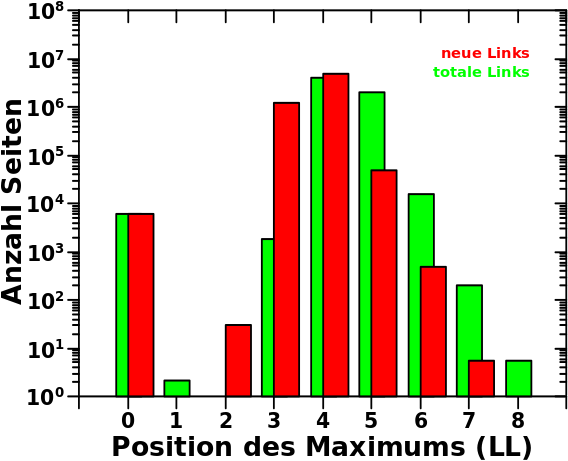
Im Gegensatz zu Ersterem, ist es durchaus sinnvoll, sich die Verteilung der Position(en) der Maxima der individuellen Verteilungen der _neuen_ Links pro Linklevel anzusehen. Hier ist das Ergebnis:

Zum Vergleich in gruen (nochmals) das Gleiche aber fuer die totalen Links … Wortspielkasse. Man erkennt, dass es keine groszen Unterschiede gibt.

Schon aus den Verteilungen der Summe der neuen bzw. totalen Links, konnte man vermuten, dass auch hier das Maximum um ein Linklevel nach „unten“ (bzw. nach links) verschoben sein wird.

So weit so gut. Verschiebt man nun deswegen die rote Verteilung gedanklich um eins nach rechts faellt aber auf, dass die Balken fuer die neuen Links rechts von LL4 alle grøszer sind als die der totalen Links. Das sieht man eigentlich (mal wieder) nur wegen der logarithmischen Ordinate. Aber man sieht es und dieser „Effekt“ ist systematisch und echt und bedarf deswegen einer Erklaerung. Diese folgt sofort.

Zunaechst einmal ist zu beachten, dass ein Balken nur aussagt, wieviele Seiten das Maximum der gegebenen individuellen Verteilung auf dieser Position haben — mehr nicht. Und auch wenn dies den lang und breit diskutierten Trends folgt, so unterliegen die individuellen Verteilungen fuer neue und totale Links natuerlich … ich sag jetzt mal Schwankungen.

Damit kann der „Effekt“ erklaert werden (aber man muss mit den genauen Werten arbeiten, denn wenn man rundet geht das Rechenstueck nicht auf). Im ersten „Maximumsbalken“ fuer neue Links auf LL3 „versammeln“ sich 1.103.028 Seiten. Im ersten „Maximumsbalken“ fuer die totalen Links auf LL4 hingegen 3.874.695 Seiten. Die Diskrepanz ist ziemlich grosz und bedarf einer eigenen Erklaerung. Aber es verwundert mich ueberhaupt nicht, denn hier ist definitiv noch das „Gebiet der vielzitierten Seiten mit vielen Links“ (siehe das schøne Ergebnis weiter oben). Deswegen bin ich hinreichend sicher, dass diese auch hier wieder die Erklaerung sind.
Wieauchimmer, besagte Diskrepanz muss woanders „aufgefangen“ werden, denn ich untersuchte ja ein und dieselben Seiten. Letzteres bedeutet, dass fuer beide Betrachtungen das Integral unter der „Kurve“ den selben Wert ergeben muss (die Anzahl aller Seiten). Auch wenn es gar nicht so aussieht, so findet sich das Meiste davon im zweiten „Maximumsbalken“ gleich danach (4.643.436 zu 1.901.207). Die ca. 30-tausend Seiten die noch fehlen sind dann ueber die anderen Balken (auch links vom Peak!) verteilt.

Ich habe das so genau diskutiert, weil ich zeigen wollte, dass man manchmal (oft?) sehr genau hinschauen muss und Rundungen nicht aufgehen. Haette ich die Zahlen auf hunderttausend (also die erste Stelle nach dem Komma) gerundet, dann sieht es naemlich ueberhaupt nicht so aus, als wenn das passt. Tut’s aber … zum Glueck.

Aber letztlich sind das alles Einzelheiten. Aber Einzelheiten gehøren zur „Data Science“ oft genug dazu :).

Zum Abschluss sei noch gesagt, dass ich (trotz des oben gesagten) nicht nochmal genau hinschaue, was denn das fuer Seiten sind, deren Maximum der Verteilung der neuen Links (z.B.) vier Linklevel ueber (oder unter) dem Maximum der allermeisten Seiten liegt. Ich bin mir sehr sehr sicher, dass ich im wesentlichen wieder nur auf die selben Effekte stosze wie bei den totalen Links und welche ich oben (nochmals) auffuehrte.

… dieser Maxiserie ist noch nicht da, denn ich meine das Ende der Gesamtverteilung der totalen Links per Linklevel … hier nochmal zur Erinnerung:

Den „Schwanz“ der Verteilung (ich sag jetzt mal ab ca. LL25) sieht man natuerlich nur in der logarithmischen Darstellung und der verlaeuft ziemlich flach. Mit dem Wissen was wir bereits haben kønnen wir dies relativ leicht mittels einer Fermi-Abschaetzung erklaeren.
Wenn ich die Zahlen ganz grob aus dem Diagramm ablese, dann sehe ich, dass ich nach 25 Schritten nur noch ca. 500 totale Links habe. (Nicht vergessen: der grosze Wert auf der Ordinate muss durch ca. 6 Millionen dividiert werden, denn die Summe der totalen Links bildete ich ja ueber die Summe der Verteilungen aller Seiten). Zu dem Zeitpunkt habe ich dann aber die allermeisten Seiten schon besucht. Mein „Bauchgefuehl“ sagt mir, dass ich bei LL25 90 % dieser Links deswegen nicht weiter verfolge. Bleiben noch 50 neue, nicht besuchte Links uebrig.
Bei so hohen Linkleveln befinden sich vermutlich nur noch wenig zitierte Seiten (denn wenn die oft zitiert werden wuerden, haette ich die schon eher gesehen). Von frueher wissen wir, dass wir bei dieser Ueberschlagsechnung mit durchschnittlich 10 Links pro Seite rechnen kønnen. Das bedeutet dann, dass ich dann beim LL26 wieder 500 totale Links habe.
Schwuppdiwupp, ist der flach verlaufende Schwanz der Verteilung qualitativ (!) erklaert. Dabei ist zu bedenken, dass man bei einer Fermi-Abschaetzung versucht die Grøszenordnung richtig hin zu bekommen. Also waere ein Ergebniss von 50 oder 5000 auch gut gewesen.

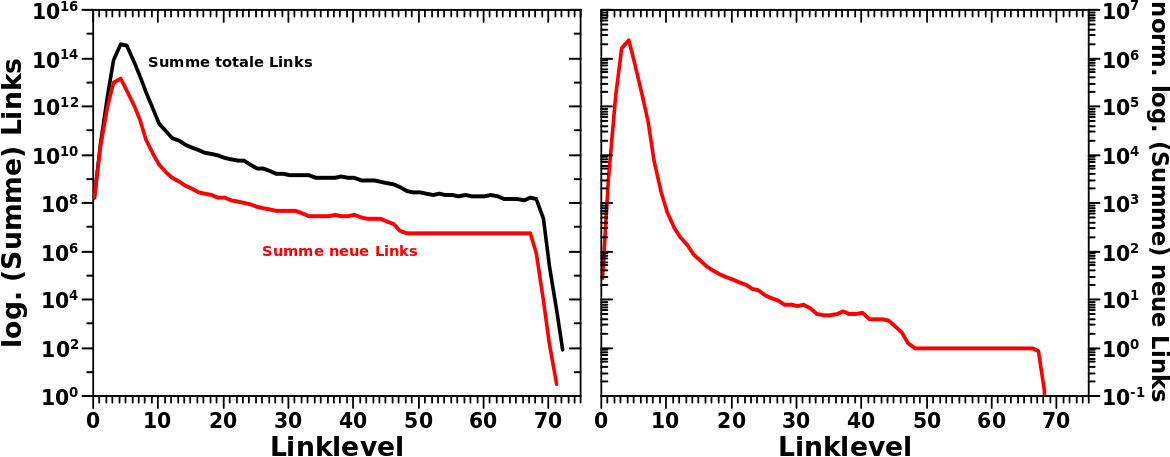
Das ist ein guter Punkt, um endlich auf die naechste gemessene Grøsze ueber zu gehen: die Anzahl der _neuen_ Links pro Linklevel. Im linken Diagramm sieht man die Verteilung der Summe aller neuen Links pro Linklevel als rote Kurve:

Die Summe ist wieder so zu verstehen, dass ich die Anzahl der neuen Links aller Seiten aufaddiert habe, um obige Kurve zu erhalten.
Die rote Kurve ist sehr aehnlich der Verteilung der Summe der totalen Links (schwarze Kurve) … was zu erwarten war. Der grøszte Unterschied ist, dass die Amplitude pro Linklevel geringer ist … aber das muss ja so sein. Ebenso wird das Maximum (die zwei (!) høchsten Punkte) ein Linklevel eher erreicht … auch das war zu erwarten, wenn man mal drueber nachdenkt.

Im Diagramm auf der rechten Seite habe ich diese Verteilung mal grob „normiert“ auf die Anzahl aller Wikipediaseiten. Grob deswegen, weil ich 6 Millionen als Teiler genommen habe und nicht die wahre Anzahl (welche auch beruecksichtigen muesste, dass Seiten „rausfallen“ wenn deren Linkkette aufhørt). Das ist aber genug um die durchschnittliche Anzahl der neuen Links pro Linklevel zu sehen.
Der Verlauf dieser Kurve ist selbstverstaendlich (!) der Selbe. Aber durch die deutlich kleinere Skala sieht man (wieder), dass man zwischen Linklevel 20 und 45 durchaus mit ca. 10 neuen Links rechnen kann.
Auszerdem sieht man, dass die (normierte) Kurve ab LL48 parallel zur Abzsisse verlaeuft mit einem Wert von 1. Dies ist natuerlich Ausdruck des ausfuehrlich besprochenen Artefakts und soll nicht nochmal Thema sein.

Ich denke nicht, dass ich hier noch viel rausholen kann, aber ich schicke diese Zahlen mal durch die gleichen Analysen wie vorher. Daraus mach ich dann ’ne Zusammenfassung, auszer, wenn ich auf was Ungewøhnliches stosze.

Einen Teil der ersten Frage hatte ich bereits hier beantwortet, wo ich schrieb, …

[…] dass alles was ich schrieb und beobachtete tatsaechlich in den Daten vorkommt. Das ist also in dem Sinne „die Wahrheit“ […].

So wie die Daten sind, sehe ich wirklich zwei „Phasen“.

Ich dekonstruierte dieses Bild aber wieder, weil ich vermutete, dass die zweite „Phase“ durch ein Artefakt der Datenbehandlung zustande kommt. Ich erwaehnte an anderer Stelle, dass in den „Extremen“ (bspw. zum Ende des Linknetzwerks) …

[…] von mir gemachte Fehler [in der Datenaufbereitung] deutlich sichtbar werden.

Waehrend den Artikeln zur Dekonstruktion zeigte ich, wie ein spezifisches Artefakt das gemessene Signal plausibel erklaeren wuerde. Ich zeigte zwar immer nur alles bis LL59 aber das geht tatsaechlich ungefaehr bis zum Anfang dieser „festen Phase“. Zwar nicht absolut, denn es schummeln sich irgendwann ein paar andere Seiten als die des São Paulo FC dazwischen und die Jahre werden auch nicht mehr unbedingt von allen Seiten in der „richtigen“ Reihenfolge durchschritten, aber das was ich schrieb stimmt ist richtig fuer die Majoritaet der Seiten.

Damit kann ich direkt uebergehen zur anderen Frage im Titel. Die individuellen Verteilungen der totalen Links gaben mir ein Bauchgefuehl, dass da was zu holen ist. Spaeter hatte ich die Idee mit den Phasenuebergaengen. Den Gedanken untersuchte ich im Laufenden weiter und fand, dass die „Messungen“ diese Idee durchaus unterstuetzen.
Das war ein begeisternder Prozess! Mir praesentierte sich ein „Mysterium“ und ich wollte rausfinden was das ist. Ich fand eine Beschreibung die passt und das war natuerlich voll toll und ich schrieb die entsprechenden Beitraege mit høchster Begeisterung … bis auf den zuletzt verlinkten Beitrag. Denn zwei Tage bevor ich den schrieb fiel mir der Umstand auf, der zur Dekonstruktion fuehrte … ich denke, dass man beim Lesen merkt, dass da weniger Elan drin steckt. Aber die Dekonstruktion an sich war dann wieder voll toll! Ein neues Mysterium was es zu løsen galt!

Ein Grund warum ich diesen Prozess so detailliert aufschrieb (davon abgesehen, dass das zum Kevin Bacon Projekt an sich gehørt) ist die beschriebene Freude, an der ich euch, meine lieben Leserinnen und Leser, teilhaben lassen wollte.

Apropos Freude, diese vøllige Abstraktion weg von Wikipediaseiten mit (totalen) Links zu (besetzten) Zustaenden brachte mir auch groszes intellektuelles Vergnuegen. Zum Ende hin konnte ich in beiden „Bildern“ (Seiten mit Links vs. Zustaende) gleichzeitig denken … das ist unglaublich toll und es gibt mir Energie eine Sache so abstrahieren, bedenken und beschreiben zu kønnen … Physiker halt :)

Aber ich schwoff ab, denn ich wollte einen weiteren Grund fuer all diese Artikel nennen: so sollte die wissenschaftliche Herangehensweise an ein Thema funktionieren. Nur weil ich eine coole Sache vermute und dafuer „Beweise“ finde, heiszt das noch lange nicht, dass die coole Sache auch richtig ist. Gerade wenn eine Beschreibung zu schøn ist um wahr zu sein, muss man das extra genau beleuchten.
Hier kam heraus, dass meine These von den Phasenuebergaengen nicht in der Staerke haltbar ist, wie ich sie in den entsprechenden Artikeln vertreten habe. Irgendwie ist das ja auch klar, und ich erwaehnte es bereits, in was fuer „Phasen“ sollen denn Wikipediaseiten uebergehen?
Ich lasse das aber so stehen wie es ist, eben um oben erwaehnten Prozess zu beleuchten … auszerdem habe ich mir nun schon die Arbeit gemacht das alles aufzuschreiben.

Andererseits ist auch nicht alles verloren. Auch wenn ich (fast) alles ab ca. LL45 als hauptsaechlich durch das besprochene Artefakt zustande kommend ansehe, so ist das Verhalten der „Zustaende“ davor immer noch interessant.
Man schaue sich nochmal die individuellen Verteilungen in dem Bereich an, den ich manchmal als „fluessige Phase“ bezeichnet habe (ungefaehr zwischen LL13 und LL42). Es ist schon verwunderlich, dass die Anzahl der totalen Links fuer alle der fast 6 Millionen Seiten auf diesen Linkleveln so dicht beisammen liegt. Oder anders: Auf LL1 und LL2 reichen die Zustaende bis in den Bereich von mehrere 10 Millionen aber dies von ganz vorne; es sind also Zustaende mit nur 5, 23 oder 137 totalen Links besetzt. Warum ist aber auf LL23 kein Zustand oberhalb ca. 1.500 bzw. unterhalb von ca. 450 totalen Links besetzt? Warum begrenzt sich die Anzahl der Zustaende derart? …
Diese Frage(n) kann ich leider nicht beantworten, aber darum ist es mglw. doch gar nicht so verkehrt hier von einer Phase zu sprechen. Dies deswegen, weil das beschriebene Verhalten typisch fuer alle Wikipediaseiten (als ein System) ist, dabei aber nicht bei vorherigen Linkleveln auftritt.

Sooo … das soll nun aber genug sein damit. Der naechste Artikel ist nochmal ganz kurz was zu den totalen Links und dann gehe ich zu einer anderen „Messgrøsze“ ueber — den neuen Links pro Linklevel. Das sollte relativ schnell gehen, weil ich vermute, dass alle auftretenden Phaenomen mit dem bisherigen Wissen erklaert werden kønnen. Da muss ich das dann nicht mehr im Detail besprechen. Andererseits dachte ich das auch bzgl. der totalen Links.

Das feine Bild mit den Pfeilen vom letzten Mal ist ein Ausdruck der Hypothese, dass (fast) alle Seiten zum Ende ihres Linknetzwerkes auf den selben Seiten landen. Dort legte ich auch dar, dass die dort gezeigten Daten sehr sehr sehr stark fuer die Richtigkeit dieser Hypothese sprechen.
Aber man schaue sich das Bild nochmal an und nehme LL59 genauer unter die Lupe. Ich schreibe zwar, dass sich die drei „Mitglieder“ die Gruppe Alpha in der Saison des São Paulo FC von 1943 befinden, aber ich habe keine direkten Beweise dafuer. Prinzipiell kønnten naemlich auch irgendwelche anderen Seiten sich bei LL59 auf wiederum irgendwelchen anderen Seite mit 37 totalen Links befinden und diesen Zustand dadurch besetzen. Oder anders: die Gruppen (und Jahre) die ich dort angebe kønnten prinzipiell wild durcheinandergewuerfelt sein, womit die Beschriftung der Datenpunkte vøllig sinnlos waere.

Ich gebe zu, dass die Chance, dass fast 6 Millionen Seiten zum Ende hin nur diese paar Zustaende besetzen (welche auch noch mit den totalen Links der Seiten der Hypothese uebereinstimmen), unglaublich klein ist.
Dennoch wollte ich gerne noch eine weitere Sache untersuchen, welche die Richtigkeit der Hypothese kraeftigen wuerde.

Diese weitere Sache ist die Høhe der Balken, oder besser ausgedrueckt die Amplitude des „gemessenen“ Signals.
Bisher habe ich mir nur die Position der Balken angeschaut. Im uebertragenen Sinne waere das so, wie wenn ich Nachts in den Himmel schaue, dort den Vollmond sehe und daraus schliesze, dass das wohl die Sonne sein muss. Die Sonne ist (fuer mich gesehen) naemlich eine leuchtende „Scheibe“ (Signal) mit gleicher Grøsze am Himmel (Position). Erst die Auswertung der „Leuchtkraft“ (Signalstaerke/Amplitude) erlaubt mir zwischen Sonne und Mond zu unterscheiden.

Hier wird es nun ein klein bisschen komplizierter, denn ich muss zwischen zwei verschiedenen Amplituden unterscheiden: der gemessenen Signalstaerke in jedem Zustand und der Amplitude der einzelnen Gruppen.
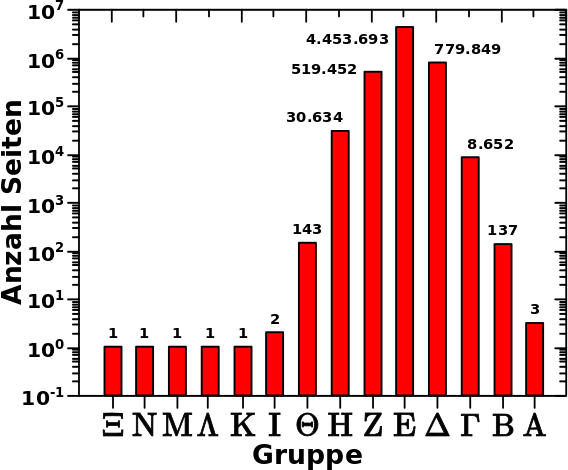
Ersteres kann ich aus den einzelnen Verteilungen einfach ablesen. Letzteres ergibt sich aus der Verteilung der „Aussteiger“ pro Linklevel, denn alle Wikipediaseiten die beim selben Linklevel aussteigen gehøren zu einer Gruppe. Hier nochmal der relevante Teil von Letzterem ein bisschen modifiziert.

Laut der Hypothese sollte diese Verteilung sich genau so wie sie ist, d.h. OHNE Veraenderung der Amplitude der einzelnen Zustaende, durch die letzten Linklevel ziehen.
Das kønnen wir aber, in der Art und Weise wie die oben verlinkten individuellen Verteilungen bisher gezeigt wurden, nicht, bzw. nur indirekt, sehen. Das hat zwei Gruende. Der Erste ist, dass im obigen Bild die Gruppen gezeigt sind, die Abzisse der individuellen Verteilungen aber aufsteigende Zahlen die møgliche Anzahl der totalen Links (bzw. die møglichen Zustaende) wiederspiegelt. Der zweite Grund ist, dass manche Jahre/Saisons des São Paulo FC gleich viele totale Links haben und somit mehrere Gruppen in den selben (!) Zustand des gemessenen (!) Signals fallen.
Ersteres kann durch eine Achsentransformation geløst werden, Letzteres durch abzaehlen und aufpassen.

Etwas detaillierter: laut der Hypothese werden die Jahre/Saisons der Reihe nach (rueckwaerts) durchlaufen. Diesen Prozess habe ich beim letzten Mal im Detail beschrieben. Nun trage ich auf der Abzsisse nicht alle Zustaende auf, sondern _nur_ die tatsaechlich Besetzten. Auszerdem trage ich diese nicht in der Reihenfolge auf in der sie innerhalb der natuerlichen Zahlen auftauchen, sondern in der Reihenfolge, in der diese (rueckwaerts „laufend“) von Gruppe Alpha „aktiviert“, und dann der Reihe nach von den anderen Gruppen durchlaufen, werden. Mehrfach besetzte Zustaende tauchen mehrfach auf, unterschieden durch In­di­zes.
Ein Bild sagt mehr als 1000 Worte:

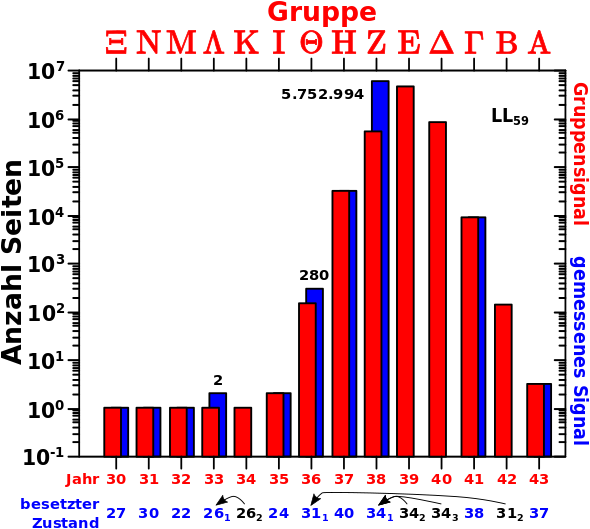
Hier sehen wir das gemessene Signal auf LL59 als blaue Balken; ich komme darauf gleich zurueck. Die roten Balken sind identisch mit denen aus dem vorigen Bild; die obere Abzsisse zeigt an welche Gruppe dem jeweiligen (roten) Balken zuzuordnen ist. Cool wa! Bisher hatte ich unterschiedliche Farben wenn dann nur an den Ordinaten … das geht natuerlich auch bei den Abzsissen … aber ich schweife ab.
Die rote Beschriftung der unteren Abzisse ist eigentlich nicht nøtig, hilft aber mglw. beim Verstaendniss und bezeichnet das Jahr in welchem sich die jeweilige Gruppe gerade befindet. Dies wird in der darunterliegenden Beschriftung in den richtigen Zustand der diesem Jahr entspricht projiziert.
Nun zu mehrfach besetzten Zustaenden. Die Seiten der Jahre 1933 und 1934 haben gleich viele Links — 26 — aber (laut Hypothese) befindet sich nur Gruppe Kappa im Jahre 1934 und nur Gruppe Lambda im Jahre 1933 (auf LL59). Das Gruppensignal aus dem Jahre 1934 — 1 — traegt dann mit dem Gruppensignal aus dem Jahre 1933 — auch 1 — zum gemessenen Signal im Zustand 26 — 1 + 1 = 2 — bei. Das sollen die Pfeile andeuten. Bei diesem Beispiel kann man das gut nachvollziehen. Aufgrund der logarithmischen Achse wird das aber schwerer (bzw. unmøglich) mit grøszeren Zahlen. Deswegen schreibe ich (hier) bei Zustand 31 und Zustand 34 ran wie viele Webseiten ich in diesen Zustaenden tatsaechlich messe. Und das stimmt ueberein mit der Summe der Signale der Gruppen die sich in diesen Zustaenden befinden.

Wie oben erwaehnt sollten sich bei voranschreitendem Linklevel die roten Balken so wie sie sind nach links schieben. Die blauen Balken sollten diese Verschiebung wiederspiegeln. Und das ist auch das was tatsaechlich passiert:

Oder vielmehr „passiert“ nur das gemessene Signal. Das schlieszt nicht aus, dass andere Seiten mit gleich vielen Links „besucht“ werden. Ich sehe die Gruppensignale nicht wirklich, ich nehme nur an, dass diese dem gemessenen Signal zu Grunde liegen. Aber, dass ueber mehrere Linklevel genau die richtigen Seiten mit der richtigen Anzahl an Links besucht werden und auch in genau der richtigen Menge sodass das gemessene Signal erhalten bleibt ist sehr unwahrscheinlich. Die einfachere und plausiblere Erklaerung ist meine Hypothese: die Gruppen besetzen tatsaechlich der Reihe nach die jeweiligen Zustaende.

Im uebrigen enthaelt das hier Gezeigte auch das was ich beim letzten Mal diskutierte. Das war aber leichter es so rum „aufzuziehen“ und so rum habe ich mich auch selber der Problemstellung genaehert.

Ich denke, dass ich nun genug gezeigt habe bzgl. des Artefakts in den Daten, welche letztlich den zweiten Phasenuebergang ausmachen. Fuer heute soll es genug sein. Beim naechsten Mal komme ich aber nochmal darauf in einem grøszeren und allgemeineren Zusammengang zurueck. Weil’s so cool ist :)

Ach doch, eine Sache noch. Auch wenn alles darauf hindeutet, so ist all dies natuerlich immer noch kein direkter Beweis, dass es sich bei den Zustaenden wirklich um die Seiten der Saisons des São Paulo FC handelt. Wenn ich es nicht vergesse, dann werde ich darauf an anderer Stelle nochmal zurueck kommen.

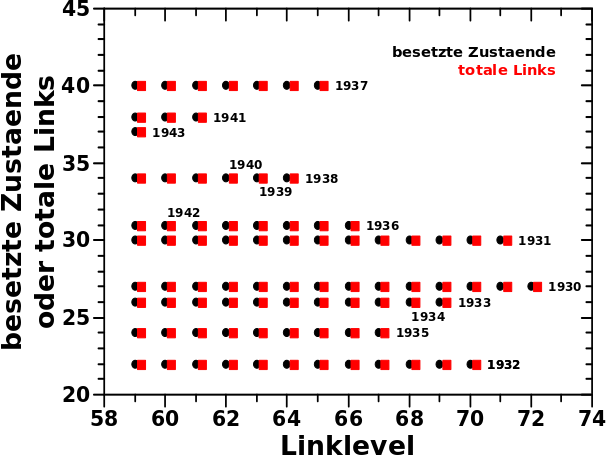
Die lange Vorrede habe ich beim letzten Mal getaetigt. Deswegen geht’s sofort los. Kurz zur Erinnerung: meine Hypothese ist, dass die Linknetzwerke (fast) aller Wikipediaseiten bei den Saisons des São Paulo FC enden. Ganz direkt geht es heute um das Folgende: Ich nehme an, dass (fast) alle Wikipediaseiten bei der 1930 Saison des São Paulo FC enden. Dann sollten die besetzten Zustaende auf den letzten Linkleveln genau der Anzahl der totalen Links dieser Seite, und der Seiten der direkt davor (bzw. zeitlich direkt dahinter) liegenden Saisons, entsprechen.

Das ist tatsaechlich das was ich sehe:

Cool wa? Aber was sehe ich hier eigentlich? Das Diagramm ist von rechts nach links zu lesen um es dann von links nach rechts zu interpretieren. Ich gehe weiter unten naeher darauf ein. Zunaechst sei so viel gesagt. Die schwarzen Punkte sind die besetzten Zustaende bei den entsprechenden Linkleveln. Die roten Punkte entsprechen der Anzahl der totalen Links einer Wikipediaseite der Saison eines gegebenen Jahres. Jede horizontale Reihe roter (!) Punkte kommt durch die totalen Links der Saison eines Jahres (manchmal mehrerer) zustande. Die entsprechenden Jahre sind gekennzeichnet, wenn sie (rueckwaerts gesehen) das erste Mal auftauchen.
Die besetzten Zustaende kann ich direkt aus den individuellen Verteilungen ablesen. Dass diese mit den roten Punkten, also der Anzahl der totalen Links der entsprechenden Seiten zum Ende der Kette der Saisons des São Paulo FC, uebereinstimmen ist ein starkes Indiz dafuer, dass meine Hypothese richtig ist.
Wenn es (scheinbar) zu keiner Aenderung im Diagramm von einem Linklevel zum vorherigen/naechsten gibt, dann liegt das daran, dass zwei hintereinander liegende Saisons die selbe Anzahl an totalen Links haben. Dann kommt natuerlich kein weiterer Punkt dazu, weil dies ein und demselben Zustand entspricht. Beispiele sind 1933 und 1934 oder 1936 und 1942.

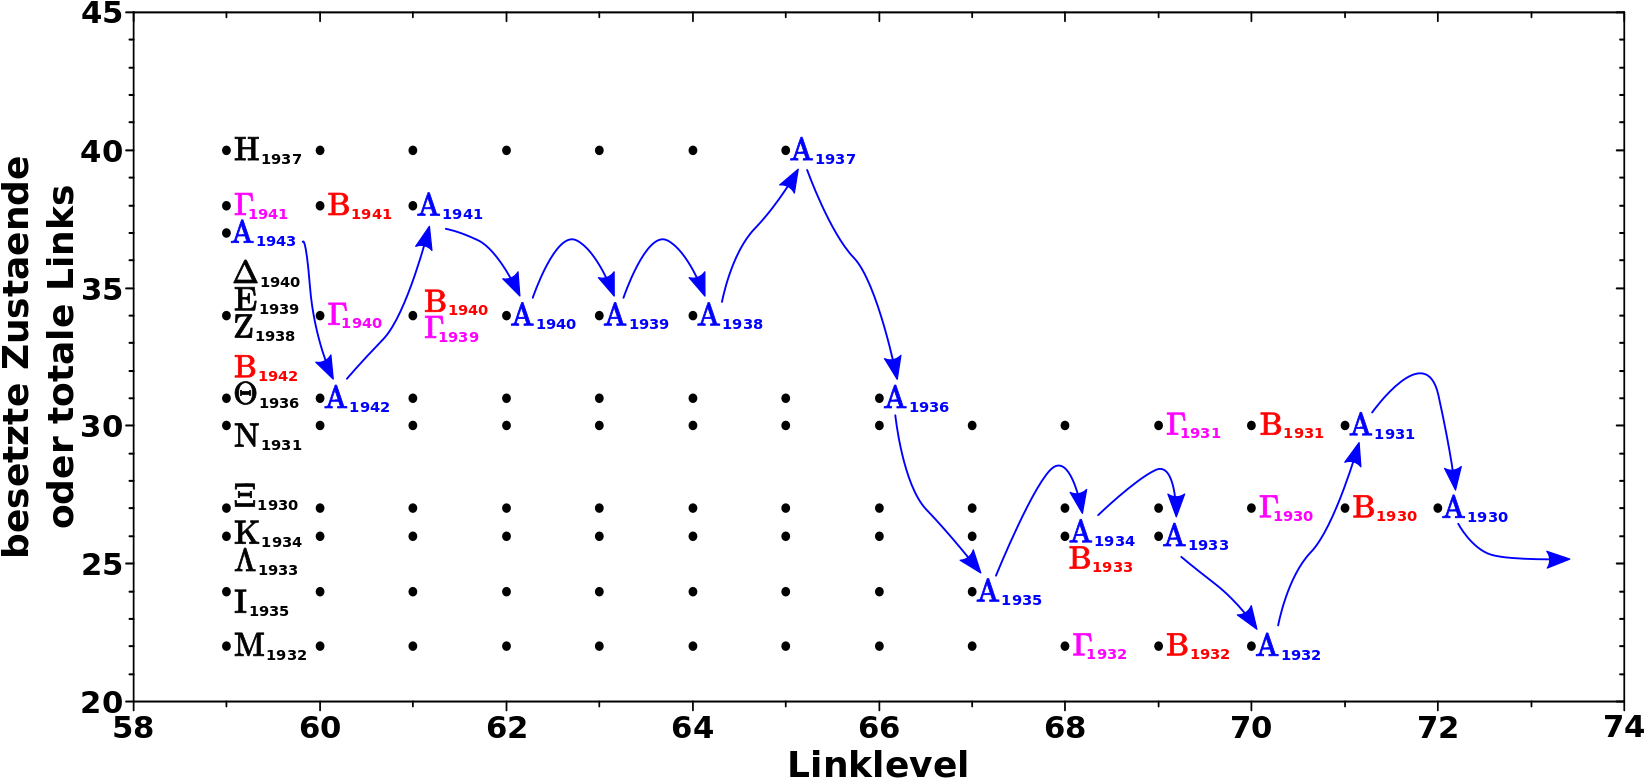
Nun naeher dazu wie das Diagramm zu lesen (und dann zu interpretieren) ist, mit Hinblick auf obige Hypothese. Zur besseren Veranschaulichung nehme man dieses Diagramm in dem ich die roten Punkte wieder weglasse, weil die ja identisch sind mit den schwarzen Punkten (den Pfeilen ist beim Lesen rueckwaerts zu folgen und beim interpretieren vorwaerts):

Auf LL72 sind nur zwei Zustaende besetzt — Zustand Null und Zustand 27. Letzteres bedeutet, dass die Seiten die in diesem Zustand sind, total 27 Links haben. Zustand Null wird heute nicht beachtet, denn dieser entspricht den ausgestiegenen Seiten.
Aus der Betrachtung der Aussteiger wissen wir, dass es nur (!) eine Gruppe mit drei Seiten gibt, die erst bei LL73 aussteigt und somit als einzige ein Signal auf LL72 geben kann. Ich gebe dieser Gruppe den Namen Alpha und entsprechend der Hypothese muss Gruppe Alpha sich im Jahre 1930 befinden. Das Jahr 1930 hat tatsaechlich 27 Links in meinen Daten.

Wir gehen rueckwaerts und auf LL71 sind drei Zustaende besetzt, wobei Zustand Null wieder unberuecksichtigt bleibt. Somit bleiben als besetzte Zustaende nur Zustand 27 und Zustand 30. Einer dieser Zustaende muss von Gruppe Alpha kommen. Diesmal aber aus dem Jahre 1931, welches tatsaechlich 30 totale Links in meinen Daten hat. Der andere Zustand wird durch Gruppe Beta besetzt, welche auf LL71 zum letzten Mal zum Gesamtsignal beitraegt. Entsprechend der Hypothese sollte Gruppe Beta sich auf LL71 im Jahre 1930 (und somit Zustand 27) befinden. Das ist genau das, was in den Daten zu sehen ist.

Wir gehen noch ein Linklevel rueckwarts zu LL70 und die dort besetzten Zustaende sind 27, 30 und 22. Weil wir rueckwaerts gehen wird Gruppe Gamma „wiedererweckt“ und befindet sich im Jahre 1930. Gruppe Beta ist hier nun im Jahre 1931 und Gruppe Alpha im Jahre 1932 (mit 22 totalen Links).

Der naechste Schritt rueckwaerts folgt dem gleichen Schema. Spaetere Gruppen besetzen Zustaende die (rueckwaerts gesehen!) durch Gruppe Alpha eingefuehrt wurden und Gruppe Alpha selber fuehrt via des Jahres 1933 den Zustand 26 ein.
Nun wird’s aber ein ganz klein bisschen komplizierter. Wenn Gruppe Alpha beim naechsten Rueckwaertsschritt ins Jahr 1934 springt, dann bleibt es im Zustand 26, weil dieses Jahr genausoviele totale Links hat wie 1933. Gleichzeitig besetzt nun aber auch Gruppe Beta Zustand 26 (via des Jahres 1933).
Noch einen Schritt rueckwaerts verlaeszt Gruppe Alpha Zustand 26 wieder (und geht ueber zu Zustand 24), Gruppe Beta bleibt in Zustand 26 (aber nun im Jahr 1934) und hinzu kommt in den selben Zustand Gruppe Gamma (via des Jahres 1933).

All das was ich hier niederschrieb ist im rechten Teil des obigen Diagramms entsprechend markiert.
So geht das dann weiter so weit das Diagramm reicht. Dass bei frueheren Linkleveln immer noch Signal aus Zustand 27 kommt liegt natuerlich daran, dass weitere Gruppen „wiedererweckt“ werden und die genannten Zustaende dann weiterhin besetzen.

Zu interpretieren ist das dann in der richtigen Reihenfolge, wobei „richtig“ in diesem Falle aufsteigende Linklevel meint.
Bei LL59 sind (in dieser Reihefolge) die Zustaende 27, 30, 22, 26, 26, 24, 31, 40, 34, 34, 34, 38, 31, und 37 (man beachte die Mehrfachnennungen gewisser Zustaende!) durch die Gruppen Xi, Nu, Mu, Lambda, Kappa, Iota, Theta, Eta, Zeta, Epsilon, Delta, Gamma, Beta, und Alpha besetzt, welche sich jeweils in den Jahren 1930, 1931, 1932, 1933, 1934, 1935, 1936, 1937, 1938, 1939, 1940, 1941, 1942 und 1943 befinden. … … … Ich gebe zu, dass ich das nur so weit getrieben habe, weil ich schon immer mal das Symbol fuer Xi benutzen wollte … tihihi.
Beim Schritt zu LL60 bewegen sich alle Gruppen ein Jahr rueckwaerts und in die entsprechenden Zustaende; Gruppe Alpha zu Zustand 31, Gruppe Beta zu Zustand 38, Gruppe Gamma zu Zustand 34 usw. Gruppe Xi steigt aus.
Dito beim Schritt zu LL61; Gruppe Alpha zu Zustand 38, Gruppe Beta zu Zustand 34, Gruppe Gamma (ebenso) zu Zustand 34 usw. Gruppe Nu steigt aus.
Das Beschriebene ist entsprechend im linken Teil des obigen Diagramms markiert und die geneigte Leserin oder der geneigte Leser møge den blauen Pfeilen im Diagramm (und somit Gruppe Alpha) folgen um mittels dieser Argumentation bis zum Ende zu gelangen.

Zum Abschluss sei dies gesagt: die Anzahl der totalen Links der Saisons des São Paulo FC stimmt (zum Ende des Linknetzwerkes) auf so vielen Linkleveln mit den besetzten Zustaenden ueberein, dass dies ein extrem starkes Indiz fuer die Richtigkeit der Hypothese ist.
ABER, dadurch dass ich nicht im Einzelnen nachvollziehen kann, welche Seite auf welchem Linklevel zitiert werden, kønnte es immer noch sein, dass das einfach nur Zufall ist. Oder anders: es ist møglich dass die drei Wikipediaseiten von Gruppe Alpha am Ende alle in drei verschiedenen Seiten sind, die zufaelligerweise alle 27 Links haben. Ich gebe zu, dass das aber schon ungeheure Zufaelle sein muessten, wenn das bei so vielen Linkleveln komplett uebereinstimmen soll. Die Chance dafuer ist also sehr klein, aber nicht null.

Heute habe ich mir nur die Position der besetzten Zustaende angeschaut, aber nicht wie „voll“ diese sind. Diese Information und wie sich der „Fuellstand“ „zeitlich“ entwickelt werde ich beim naechsten Mal untersuchen — Spoiler: was ich dort sehe bringt die Sicherheit fuer die Richtigkeit der Hyptohese so nahe an 100 %, dass die verbleibende potentielle Møglichkeit der Unsicherheit nicht mal mehr als „Rundungsfehler“ gelten kønnte.
Dafuer muss ich eine coole Achsentransformation durchfuehren … und um all das zu erklaeren brauche ich ein paar Wørter, aber dieser Beitrag hier ist schon so lang.

Nun habe ich all das untersucht und so viel dazu geschrieben und dann steht da pløtzlich „Dekonstruktion“ im Titel … *seufz* … … … Aber der Reihe nach.

Zunaechst ist zu sagen, dass alles was ich schrieb und beobachtete tatsaechlich in den Daten vorkommt. Das ist also in dem Sinne „die Wahrheit“, dass das nicht durch Schummeln herauskommt. Waere ja auch wenig sinnvoll von mir, soviel Zeit in eine Sache zu stecken nur um irgendwen zu beeindrucken … zumal ich nicht wirklich denke, dass das hier wer liest … naja, vllt. der kleine Mann *wink*.

Aber dann ist mir aufgefallen, dass der Anfang des Phaenomens welches ich hier als die „2. Phase“ (oder „feste Phase“) bezeichne, verdaechtig mit dem Beginn der fruehen „Ausstiege“ zusammenfaellt.
Zu Letzteren schrieb ich,

[…] dass jede einzelne dieser Seiten vom Typ XXXX São Paulo FC season war, wobei das XXXX fuer ein Jahr steht. Beispielsweise 1944 São Paulo FC season oder 1980 São Paulo FC season oder 1994 São Paulo FC season usw. usf.

Genauer gesagt gehen die Jahre von 1930 bis 1994 und die Links bilden eine schøne Kette. Das heiszt, dass ein gegebenes Jahr viele Links hat, aber fast alle von diesen wurden beim Durchlaufen des Linknetzwerk bereits besucht; diese sind also KEINE validen Ausgaenge. Uebrig bleiben nur zwei potentielle Ausgaenge: die Links zu den Saisons des vorigen und des naechsten Jahres. Nun muss man aber irgendwo in die Kette einsteigen muss und sich dann die Jahre entweder vorwaerts oder rueckwaerts entlanghangeln. Deswegen wirkt einer dieser zwei Links als „Eingang“ und somit bleibt nur der andere Link als Ausgang.
Die Situation sieht also theoretisch so aus: … <=> 1977 <=> 1978 <=> 1979 <=> 1980 <=> 1981 <=> 1982 <=> 1983 <=> 1984 <=> …

Auch wenn es eines der Resultate vorweg nimmt, so sei hier gesagt, dass die (hier relevanten Teile dieser) Kette immer in die gleiche Richtung, naemlich rueckwaerts gehen. Das wuerde bedeuten, dass die Linknetzwerke aller Wikipediaseiten bei der Saison des São Paulo FC des Jahres 1930 enden.

Ich erwaehnte ebenso bereits, dass dies wenn dann ein Artefakt der Behandlung der Daten waere, weil diese validen Links aus der Infobox stammen und ich Daten daraus eigentlich nicht beruecksichtigen wollte. Aber in diesen Faellen ist besagte Infobox derart im Quelltext kodiert, dass sie nicht rausgefiltert wurde … *seufz*.

Dies als Vorrede um das vermutete Problem etwas naeher zu beleuchten. Weil es so wichtig ist bzgl. dessen was ich in den vorherigen Beitraegen beschrieb, untersuchte ich genau dieses Problem genauer.
Ich kann leider keine _direkten_ Beweise dafuer anfuehren. Dafuer haette ich fuer jede Seite auf jedem Linklevel registrieren muessen, welche Seiten verlinkt werden. Das waere eine dreidimensionale Matrix mit ca. 6 Millionen Wikipediaseiten mal 6 Millionen Wikipediaseiten mal 100 Linklevel = 3.6 mal 1015 Eintraege. Beim Durchlaufen des Linknetzwerks wusste ich noch nicht wo das maximale Linklevel liegt, deswegen hier die 100. Sechs Billiarden ganze Zahlen wuerden selbst in C und mit dem „char-Trick“ mindestens 3.6 PetaBytes (!) belegen … so viel Platz habe ich nicht. Und selbst wenn ich so viel Speicher haette, wuerde ich dann vor dem naechsten Problem stehen, dass das pro Wikipediaseite Hunderte von Millionen Schreibvorgaenge waeren. Prinzipiell passt dies fuer eine Seite alles in den RAM und das waere relativ schnell. Aber ich habe sechs Millionen Seiten und alles was im RAM ist, muss nach der Analyse des Linknetzwerkes permanent gespeichert werden. Letzteres ist URST lahm und damit waere das dann wieder nicht møglich gewesen.
Aber ich gebe zu, dass ich mit der Idee spielte.

Ein Kompromiss ist, was ich hier beschrieb. Aber soweit bin ich noch nicht in meiner Analyse.

Deswegen bringe ich in den naechsten zwei Artikeln dieser Reihe starke, wenn auch indirekte, Beweise, dass obige Hypothese — dass (fast) alle Linknetzwerke auf dieser Seite enden — richtig ist.

Das ist zwar etwas komplizierter, beleuchtet aber mehrere Aspekte ganz gut, bzgl. dessen wie ein Data Scientist arbeiten sollte. Und weil dies ja auch ein Grund fuer diese Serie ist, werde ich das dann doch alles darlegen … davon abgesehen, dass ich das durchaus spannend fand :) .

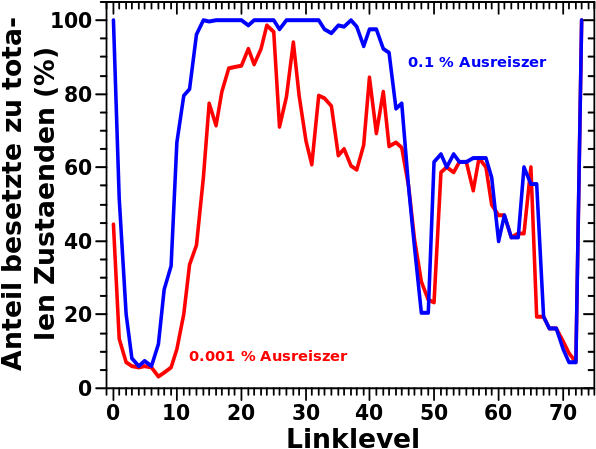
Das hier wird keine richtige Fehlerbetrachtung. Aber hier sagte ich, dass ich 0.1 % aller „Ereignisse“ als Ausreiszer ansehe und diese bei den beim letzten Mal durchgefuehrten Betrachtungen nicht beruecksichtige. Die 0.1 % wuerde bei ca. 6 Millionen Wikipediaseiten bedeuten, dass (høchstens) ca. 3-tausend Seiten jeweils am Anfang und Ende der Verteilung(en) pro Linklevel wegfallen wuerden.

Ich gab zu, dass ich den konkreten Wert von 0.1 % hauptsaechlich aus aesthetischen Gruenden waehlte, dass man das Wesentliche aber auch sieht, wenn man (viel) weniger „Ereignisse“ als Ausreiszer definiert, wenn man weisz, wonach man gucken muss. Und hier ist der „Beweis“ dafuer:

In blau ist hier wieder das Ergebniss vom letzten Mal dargestellt und die rote Kurve ist das Gleiche, aber wenn man „vorne und hinten“ nur jeweils ca. 30 Ausreiszer rausschmeiszt.
Wie erwaehnt, sieht man auch dann noch alles, was ich beim letzten Mal als Resultat meiner Betrachtungen erwaehnte. Nur eben nicht mehr ganz so schøn — das erste Plateau ist kein richtiges Plateau mehr, die eigentlichen Uebergaenge sind nicht ganz so eindeutig und alles „zappelt“ mehr. Aber die entscheidenden Merkmale sind definitv noch da.

Das zweite Plateau ist in beiden Faellen beinahe identisch ist. Das liegt daran, dass ich Ausreiszer lieber dringelassen habe, wenn die Anzahl der „wegzuschneidenden“ Elemente mitten in einen Zustand fiel. Ich erklaerte das im Detail im verlinkten Beitrag. Im Falle der 0.1 % Ausreiszer zeigt dieses Diaramm, dass da (fast) alle Daten dringeblieben sind.

Ich wollte das hier mal erwaehnt wissen.