Archive for the ‘Kevin Bacon’ Category

Wie beim letzten Mal gesagt, heute nun endlich:

„Butter bei die Fische“.

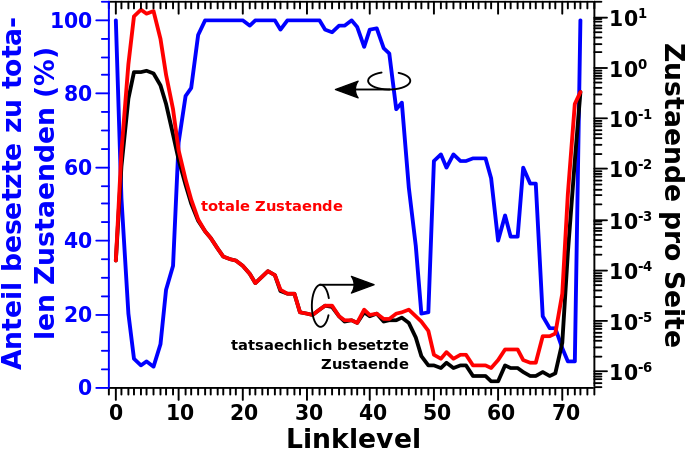
Und nach den langen Vorreden die letzten Male, gehe ich heute gleich in die Vollen und zeige sofort das Ergebniss (ACHTUNG: bei den hier dargestellten Daten wurden die Ausresizer rausgeschmissen, so wie beim letzten Mal diskutiert):

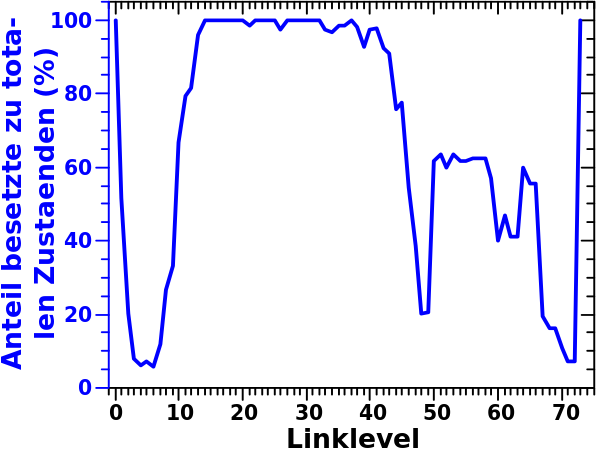
Cool wa! … Aber was ist hier eigentlich dargestellt?
Nun ja, das steht an der Abzsisse dran: ich habe mal geschaut, wie sich der Anteil der tatsaechlich besetzten Zustaende in Bezug zur Anzahl aller møglichen (und plausiblen) Zustaenden entwickelt.

OK, das ist leicht zu verstehen … aber was passiert hier eigentlich? … Øhm, das zu erklaeren dauert etwas laenger.
In der „Gasphase“ ganz am Anfang sind alle møglichen Zustaende auch mit mindestens einem „Partikel“ / Wikipediaseite besetzt. Waehrend des „Aufheizens“ steigt die Anzahl der _møglichen_ Zustaende stark. Beim vorletzten Mal haben wir gesehen, dass die Anzahl der tatsaechlich besetzten Zustaende auch stark ansteigt. Ersteres geht schneller als Letzteres und deswegen wird der hier dargestellte Quotient (multipliziert mit 100 um den Anteil zu erhalten) entsprechend kleiner. Das Tal zwischen LL3 und LL7 liegt daran, dass ich nur ca. 6 Millionen „Partikel“ habe. Die Konsequenzen dieser Limitierung wurde auch bereits beim vorletzten mal besprochen.
Waehrend des „Abkuehlens“ nimmt die Anzahl der møglichen Zustaende ab und das System besetzt mehr und mehr dieser _møglichen_ Zustaende, die somit _tatsaechlich besetzte_ Zustaende werden. Irgendwann sind alle „Partikel“ „kondensiert“ und (im Wesentlichen) wird jeder møgliche Zustand ab LL13 auch (von mindestens einer Seite) besetzt. Das System ist komplett von der „gasførmigen“ in die „fluessige Phase“ uebergegangen und dieser Phasenuebergang fuehrt zu einem „Plateau“ in der blauen Kurve. Dies bleibt so bis ca. LL43/44. Dann passiert etwas Interessantes: Der Anteil der besetzten Zustaende faellt sprunghaft auf 60 %. Das ist das erwaehnte pløtzliche „Gefrieren“ — ein weiterer Phasenuebergang.

Das das Signal am Ende so „zappelt“ liegt daran, dass ich hier im Bereich unterhalb von 100 Zustaenden, ab ca. LL50 sogar unterhalb von 10 Zustaenden arbeite. Da fuehren dann bspw. zwei zusaetzliche besetzte Zustand zu einem deutlichen Unterschied im Signal. Aber trotz dieser unguenstigen Voraussetzungen erkennt man dennoch eindeutig, dass die „feste Phase“ ein zweites, unabhaengiges Plateau bildet.
Umgekehrt sind diese unguenstigen Voraussetzungen auch genau der Grund warum ich meinem Bauchgefuehl echte Daten folgen lassen wollte. Denn das Gefrieren in nur ganz wenige Zustaende haette ja auch eine Art optische Taeuschung sein kønnen. Durch die logarithmische Komprimierung sehe ich naemlich gar nicht, ob bei 10-tausend totalen Links nicht vielleicht auch nur 50 % aller møglichen Zustaende besetzt sind.

Und das ist sooo krass, dass man durch „richtige“ Betrachtung der Daten den Phasenuebergang von „fluessig“ zu „fest“ (und eigentlich auch von „gasførmig“ zu „fluessig“) so klar sieht.

Ich bin aber noch nicht fertig damit, doch bevor ich weitermache zunaechst ein kurzer Einschub: normalerweise mag ich diese Art der Darstellung in einem Liniendiagramm nicht. Ich bevorzuge Punktdiagramme, denn die Linien sind ueberfluessig, gar irrefuehrend. Die Daten sitzen an bestimmten Punkten und dazwischen gibt es nix. Manchmal benutze ich diese Art der Darstellung dennoch, weil es dem Auge des Betrachters eine Art „Stuetze“ gibt, die hilft dem Verlauf besser zu folgen. Ich erwaehne dies, weil Daten oft bescheuert praesentiert werden und so viel vom Informationsinhalt unter und deswegen oft verloren geht.
Heute habe ich diese Form nicht als Stuetze fuer das Auge gewaehlt. Der Verlauf ist hier (erstmal) nicht so subtil, dass das vonnøten waere. Aber im naechsten Diagramm gibt es (mehr oder weniger) subtile Unterschiede die man besser sieht, wenn man eine Linie (anstatt von Punkten) benutzt. Damit das konsistent bleibt auch im obigen Diagramm eine Linie.

Letzteres ist auch der Grund warum die obige Linie ausnahmswiese blau ist. Die Farben rot und schwarz habe ich beim vorletzten Mal benutzt. Dort habe ich auch versprochen, dass diese Daten nochmals (in leicht modifizierter Form) auftreten werden. Nun ja, hier sind sie nun (in leicht modifizierter Form):

Die rechte Ordinate ist fuer die schwarze und die rote Kurve(n). Diese Kurven entstanden, indem ich die Anzahl der tatsaechlich besetzten (schwarz) und totalen Zustaende (rot) durch die Anzahl der (noch nicht ausgeschiedenen) Seiten dividiert habe.

Die Gruende fuer den Verlauf der Kurve wurde bereits oben (und beim letzten Mal) besprochen. Wie zu erwarten ist der Wert der Amplitude des Maximums der schwarzen Kurve ungefaehr eins (etwas kleiner, weil ca. 15 % aller Zustaende mehrfach besetzt sind) und die Anzahl der møglichen Zustaende (rote Kurve) ist ungefaehr zehn mal grøszer.
Etwas Interessantes passiert bei ca. LL23/13: hier fallen beide Kurven zusammen. Auch das war zu erwarten, denn die blaue Kurve geht bei diesem Linklevel zum ersten Plateau ueber mit einem Wert von 100 %. Das Interessante ist also nicht unerwartet.
Aus den selben Gruenden ist die Separation der beiden Kurven bei ca. LL44/45 nicht unerwartet. Nun wird’s aber interessant.

Der Grund fuer den Unterschied zwischen der roten und der schwarzen Kurve im Maximum waehrend des „gasførmigen Phase“ war, dass es einfach zu viele Zustaende gibt und diese mit der begrenzten Anzahl an „Partikeln“ nicht besetzt werden kønnen. Das ist aber bei der „festen Phase“ mitnichten der Fall! Jeder møgliche Zustand kønnte dort mehrere hundertausend Mal besetzt werden. Es sollte also keine Separation geben! Dass es diese dennoch gibt, ist natuerlich ein weiterer Hinweis darauf, dass das System der Wikipediaseiten (oder mglw. das System der Linknetzwerke) tatsaechlich „physikalisch“ zwei sehr unterschiedliche Dinge bei hohen bzw. niedrigen Linkleveln ist.
Was genau diese zwei „Dinge“ sind kann ich nicht beantworten. Denn „fluessig“ und „fest“, wie in der physikalischen Bedeutung dieser zwei Wørter, sind die Seiten ja schlieszlich nicht. Und wie eben kurz in der Klammer im vorigen Satz erwaehnt, sind es mglw. auch gar nicht die Wikipediaseiten selber, sondern deren Linknetzwerk (was ja noch einen Schritt „aetherischer“ ist).

Aber genug fuer heute. Ich bin maechtig stolz darauf, dass ich zwei Phasenuebergaenge entdeckt habe. Oder vielmehr habe ich das intuitiv in den Daten erkannt und die eigentlich spannende Information dann aus selbigen herausgekitzelt.

Die beim vorletzten Mal eingefuehrte Analogie, in der Wikipediaseiten angesehen werden wie Partikel eines idealen Gases, welche bei bestimmten „Temperaturen“ (Linklevel) bestimmte Zustaende (Anzahl der totalen Links) einnehmen kønnen, hilft mir beim naechsten Mal zwei Phasenuebergaenge dingfest zu machen.
Aber weil’s so wichtig ist, møchte ich heute darueber sprechen, dass ich die Daten die ich beim letzten Mal praesentiert habe, nicht einfach so nehmen kann, wie sie sind.  Der Grund ist (wie ich beim vorletzten Mal schrieb), dass ich […]

[…] die Zustaende zwischen dem kleinsten und dem grøszten besetzten Zustand einfach abzaehle und damit dann die Anzahl aller (plausiblen) Zustaende auf einem gegebenen Linklevel erhalte.

Es gibt aber in jeder Verteilung Zustaende die so weit weg sind vom Rest der Verteilung, dass die alles „kaputt“ machen. Oder anders: durch den Abstand eines einzigen Zustands vom Rest der Gruppe entstehen so viele leere plausible Zustaende, dass die aus der Anzahl aller plausiblen Zustaenden errechnten Ergebnisse nicht mehr sinnvoll sind.

Bei richtigen Messungen nennt man sowas „Ausreiszer“ und die dtsch. Wikipedia schreibt dazu:

[…] man [spricht] von einem Ausreißer, wenn ein Messwert […] allgemein nicht den Erwartungen entspricht.

Das ist korrekt, aber etwas zu spezifisch. Denn ich habe keine Erwartungen, oder vielmehr wiesz ich nicht, was ich erwarten soll. Denn trotz der Analogie sind die Wikipediaseiten eben doch kein ideales Gas, von dem ich erwarte, dass es sich auf bestimmte Art und Weise verhaelt. Entpsrechend habe ich keinen Erwartungswert um den rum ich eine gewisse Streuung der „Messwerte“ als normal ansehe und alles was auszerhalb des Bereiches faellt falsch sein muss.

Deswegen gefaellt mir (mal wieder) besser, was die englische Wikipedia schreibt:

[…] an outlier is a data point that differs significantly from other observations.

AHA! Das ist doch mal was. Mich duenkt, die dtsch. Wikipedia wollte das so sagen, aber die spezifischen Worte die gebraucht wurden druecken das nicht aus, wenn man mal naeher drueber nachdenkt.

Das hilft mir in diesem Fall zwar weiter, ist aber _zu_ diffus um irgendwas quantifizieren zu kønnen. Wo høren die validen Beobachtungen auf und wie signifikant ist signifikant? In der Praxis ist man da oft genug bei der Streuung um den Erwartungswert zurueck. Und das ist ja auch richtig so, denn das macht die Reproduzierbarkeit aus.

Es gibt ein paar mathematische Tests fuer Ausreiszer. Leider bauen diese wieder darauf auf, dass man etwas erwartet. Also entweder verteilt sich (wieder) alles um einen (oder mehrere) Erwartungswert(e) oder, dass bei „wilden“ Verteilungen (bspw. mit mehreren Maxima oder Verteilungen die sich aus mehreren Normalverteilungen zusammen setzen etc. pp.) die mathematische Beschreibung der besagten Verteilung bekannt ist.
Die Verteilungsfunktion der Zustaende der Wikipediaseiten ist mir nicht bekannt und veraendert sich im gegebenen Fall auch von Linklevel zu Linklevel. Und was sind die Erwartungswerte, wenn sich die Zustaende ueber mehrere Grøszenordnungen erstrecken?
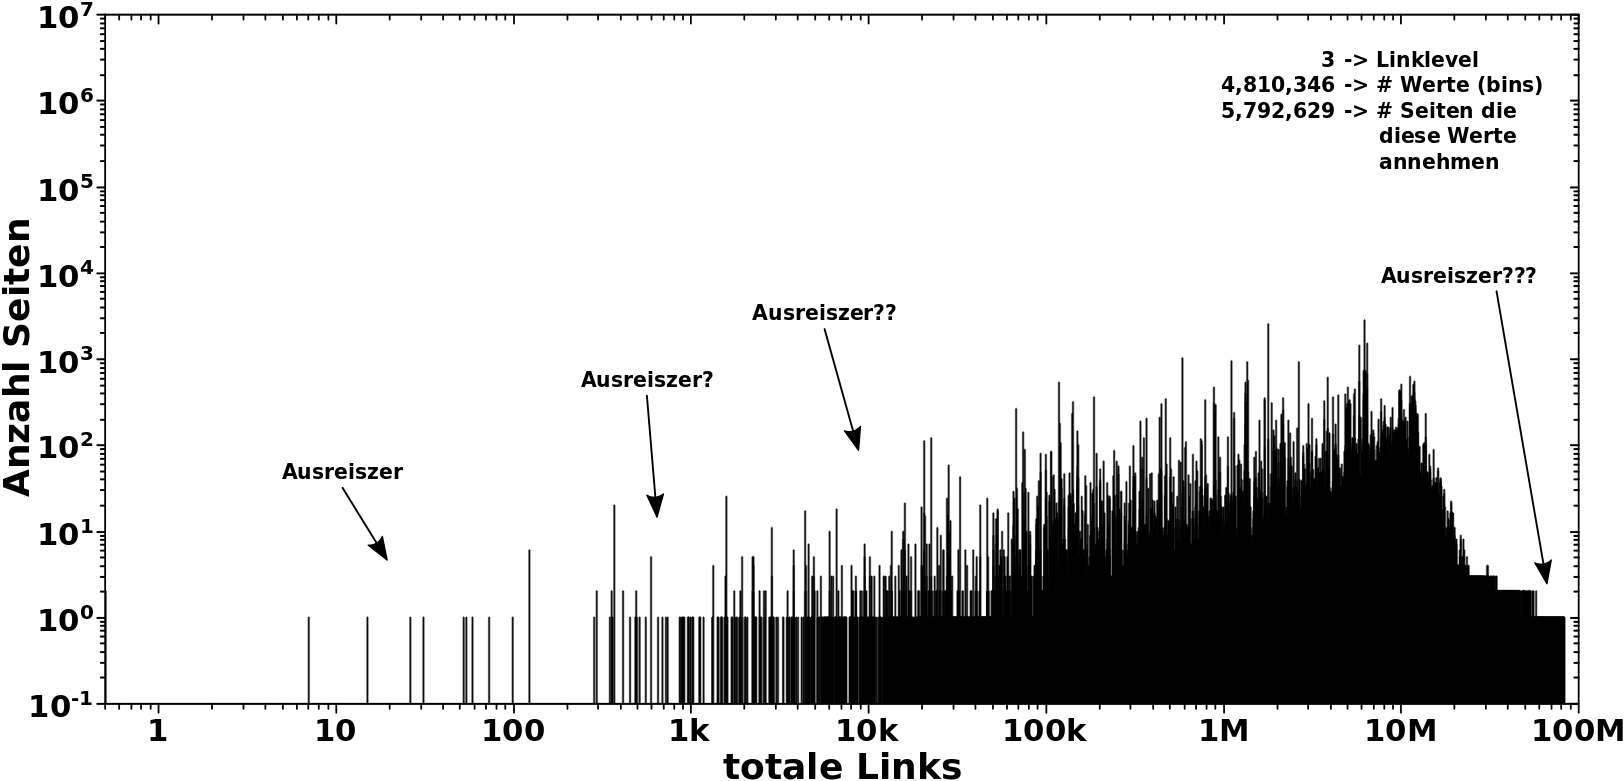
Im Wesentliche stehe ich vor dem „Das-sieht-ma-doch“-Problem, was sich aber mathematisch nicht klar ausdruecken laeszt. Als Beispiel zur Illustration nehme man die Verteilung der Zustaende auf LL3:

Die paar Zustaende ganz links, zwischen Werten von 7 und ca. 120 totalen Links, sind eindeutig Ausreiszer … das sieht man doch. Aber was ist mit den Werten zwischen ca. 180 und 100 totalen Links? Die sehen ja aus, als ob die schon noch dicht genug an den anderen Observationen liegen. Andererseits ist das ’ne logarithmische Achse und das ist sicher OK die als Ausreiszer zu definieren.
Mhmm … wenn ich das so sage, was ist denn dann mit den Zustanden zwischen 10-tausend und ich sag jetzt mal ca. 50-tausend totalen Links? Das Maximum der Verteilung liegt eindeutig bei ca. 10 Millionen totalen Links, das ist ganz schøn weit weg.
Und dann die Zustaende zum Ende der Verteilung! Aufgrund der logarithmischen Komprimierung sehen die zwar aus wie ganz dich am Rest, aber da gibt es bei lineraer Achse sicherlich deutlich grøszere Leerraeume als bei den ganz eindeutigen Ausreiszern ganz am Anfang. Sind Letztere dann vielleicht doch keine Ausreiszer?

Wie man sieht ist das alles nicht so einfach. In meiner zweiten Doktorarbeit habe ich mich damit professionell herumgeschlagen. Leider kann die dort entwickelte Methode der Detektierung (und Korrigierung) von Ausreiszern, wenn man nicht weisz was man erwarten soll, hier nicht angewendet werden.

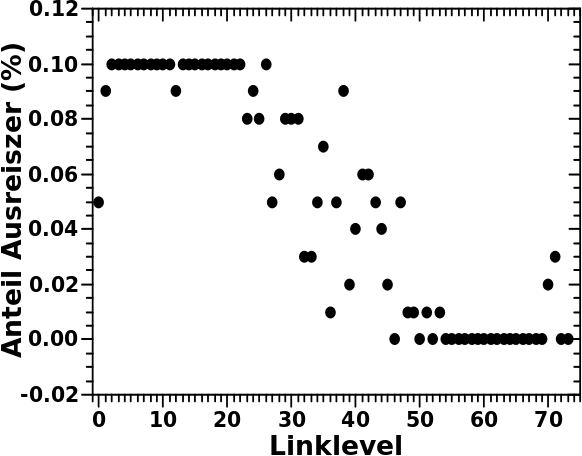
Deswegen bin ich dann doch darauf zurueckgefallen, dass ich die jeweils ersten und letzten 0.05 % aller Zustaende einfach abschneide (insgesamt schlieszt das 0.1 % aller Zustaende aus).
Aber Achtung das sind Maximalwerte und in den meisten Faellen schliesze ich weniger Zustaende aus:

Der Grund ist, dass ich einen mehrfach besetzten Zustand nicht aufteile in „gut“ und „schlecht“. Alle Seiten („Partikel“) in diesem Zutand sind gleichwertig. Oder anders: sollte die Ausschlieszungsgrenze von 0.05 % in die Mitte eines mehrfach besetzten Zustandes fallen, dann werden vielmehr alle Seiten die in diesem Zustand sind als „gut“ gewertet und in den auszuwertenden Datensatz uebernommen.

Der Gebrauch des Wertes 0.1 % bedeutet, dass (bei ca. 6 Millionen Seiten) an beiden Enden im Extremfall ca. 3000 Zustaende ausgeschlossen werden.
Ich gebe zu, dass ich mich entschied 0.1 % als Kriterium bzgl. des Ausschlieszens von Ausreiszern zu nehmen, weil ich einen praktikablen Kompromiss finden musste, zwischen „aesthetischen Gruenden“ und dem Wunsch so viele Daten wie møglich hinzuzunehmen. Wobei Ersteres dominierte, weil ich bei diesem Wert die Phasen (deren Vorhandensein zwar vermutet wird, aber der Nachweis noch ausstand; bzw. in dieser Reihe noch aussteht) besser unterscheiden kann.
Man sieht aber alles bereits deutlich, wenn man nur 30 Zustaende an den Enden wegschneidet. Ja selbst wenn ich nur die 3 aeuszersten Werte ausschliesze, treten die entscheidenden Merkmale bereits sichtbar hervor. Und wenn man weisz wonach man sucht, sieht man es auch im kompletten Datensatz … aber das war ja das Problem, ich wusste zunaechst nicht so richtig wonach ich suche, wie sich das in den Daten ausdrueckt und wo das konkret ist … selbst wenn ich Vermutungen diezbezueglich hatte.

Trotz aller Rhe­to­rik bzgl. der Integritaet der Wissenschaft(ler) ist diese Herangehensweise insb. in den sog. „angewandten Wissenschaften“ sehr weit verbreitet. Daran ist erstmal nix auszusetzen, solange das ordentlich diskutiert wird und Ergebnisse nicht pløtzlich verschwinden, wenn man die Daten anders „aufbereitet“. Leider passiert Ersteres so weit ich weisz nie und Letzteres vermutlich (deutlich) øfter als uns lieb ist … *seufz*. … Und auch wenn ich oben explizit die sog. „angewandten Wissenschaften“ erwaehne, ist das im Groszen und Ganzen in allen (Teil)Gebieten der Wissenschaft so … mit ein paar Ausnahmen, wie bspw. die Hochenergiephysik oder (heutzutage) einige (viele?) groszangelegte klinische Studien, die mehr und øfter vorregistriert werden … wobei das auch nicht immer hilft, am Ende doch noch was „schick zu machen“, damit das imponierender bei der Publizierung aussieht.

Das soll genug sein fuer heute, beim naechsten Mal gibt’s dann endlich „Butter bei die Fische“.

Beim letzten Mal habe ich eine Analogie eingefuehrt, in der ich davon sprach, dass man Wikipediaseiten ansehen kann wie Partikel eines idealen Gases. Das Linklevel entspricht in der Analogie erhøhten oder erniedrigten Temperaturen. Das Durchlaufen von einem Linklevel zum anderen kønnte dann gleichgesetzt werden mit dem „Aufheizen“ und danch wieder „Abkuehlen“ der Wikipediaseiten (gesehen in ihrer Gesamtheit als ein System). Dabei scheint es zu Phasenuebergaengen zu kommen. Schlussendlich kann die Anzahl der totalen Links die eine Seite auf einem gegebenen Linklevel hat, als ein „Zustand“ angesehen werden, den diese Seite bei der gegebenen „Temperatur“ annehmen kann.
Im Weiteren werde ich den Begriff des Zustands (den eine Seite annehmen kann) sehr haeufig benutzen. Dabei ist immer zu beachten, dass dies nicht buchstaeblich gemeint ist. Dieses Denkmodell ist nur eine gedankliche Stuetze, die mir hilft gewisse Dinge innerhalb eines (in der Physik etablierten) Konzepts zu vereinen und zu interpretieren und in bessere Zusammenhaenge zu bringen.

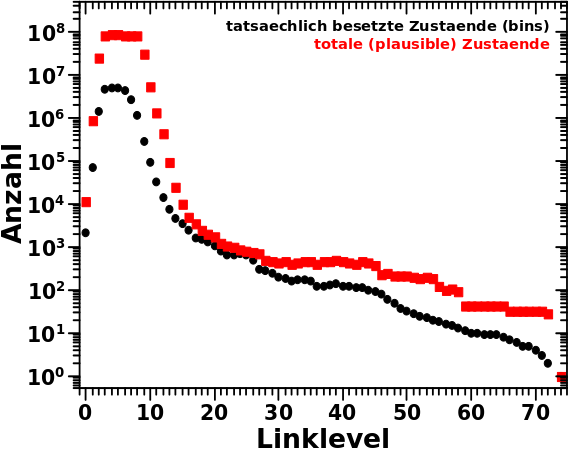
Hier ist nun die Anzahl der „besetzten“ Zustaende und die daraus errechnte Anzahl der totalen (plausiblen) Zustaende:

Das „Aufheizen“ am Anfang fuehrt dazu, dass immer mehr Zustaende „besetzt“ werden (die schwarzen Punkte haben høhere Werte). Oder anders: fast jede Wikipediaseite ist „allein“ in ihrem Zustand denn die Anzahl der totalen Links einer Seite auf bspw. LL5 ist anders als die der allermeisten anderen Seite.
Allerdings habe ich nur ca. 6 Millionen Wikipediaseiten und deswegen bleiben die schwarzen Punkte immer unter diesem Wert.

Wie beim letzten Mal beschrieben, erhalte ich die Anzahl der møglichen (plausiblen) Zustaende (die roten Quadrate), indem ich …

[…] die Zustaende zwischen dem kleinsten und dem grøszten besetzten Zustand einfach abzaehle […].

Weil die Anzahl der totalen Links bei einigen Seiten bis fast 90 Millionen geht, kann die Anzahl der møglichen Zustaende die der tatsaechlich besetzten Zustaende im Maximum um mehr als eine Grøszenordnung uebersteigen. In dem Fall gibt es also plausible Zustaende, die kønnen aber nicht besetzt werden, weil ich keine „Partikel“ habe die die besetzen kønnten.

Danach folgt die „Abkuehlung“ und die Anzahl der besetzten und møglichen Zustaende nimmt (wie zu erwarten war) ab.

In der Phase der „Kondensierung“ sammeln sich mehr und mehr „Partikel“ in den selben (!) Zustaenden; die schwarzen Punkte haben Werte weit unter 6 Millionen. Dennoch, einige Zustaende bleiben unbesetzt. Dadurch ist die Anzahl der møglichen Zustaende wieder grøszer als die Anzahl der besetzten Zustaende, aber hier aus einem ganz anderen Grund! Man schaue sich bspw. LL40 an. Dort habe ich ca. 500 møgliche Zustaende, aber nur ca. 100 besetzte Zustaende. Die 6 Millionen Seiten kønnten locker alles auffuellen. Das passiert aber nicht … kein Wunder, dass mein Bauchgefuehl mir sagte, dass da doch was sein muss.

Andererseits kann ich das nicht an den „totalen Zahlen“ sehen, die hier dargestellt sind. Denn hier liegen die roten Punkte immer ueber den schwarzen Punkten. Deswegen komme ich (nach einem wichtigen Einschub beim naechsten Mal) nochmals auf diese Kurve (in etwas modifizierter Form) zurueck.

UI! Manchmal kann ich mich kurz halten!

Beim letzten Mal zeigte ich die Verteilungen der totalen Links fuer jedes Linklevel und ich teilte alles in 4 Abschnitte ein. Ich erwaehnte auch, dass der Uebergang von Abschnitt drei zu Abschnitt vier total krass ist, und dass es wie ein Phasenuebergang aussieht, wenn der „Wald der Balken“ sich so pløtzlich massiv lichtet.

Aber warum erinnerte mich das an einen Phasenuebergang? Und was ist das ueberhaupt? Und was fuer „Phasen“ sollen denn Wikipediaseiten annehmen? Und wie sollen Wikipediaseiten von einer „Phase“ in eine andere „Phase“ wechseln?

Nun ja, ich dachte dabei zunaechst an die Bildung von Cooper-Paaren oder ein Bose-Einstein-Kondensat. Aber beide diese Effekte kenne ich nur rein phaenomenologisch (bzw. ist mein Verstehen der Gleichungen bzgl. der Cooper-Paarbildung mittlerweile 20 Jahre her).
Deswegen ein anderes Beispiel, von dem ich hoffe, dass es zu mehr Klarheit beitraegt: unterkuehltes Wasser, das pløtzlich gefriert. Etwas bildlicher: in fluessiger Form kann ein Wassermolekuel viele Geschwindigkeiten (und Orte) annehmen, pløtzlich gefriert dann alles und in der festen Form nehmen alle Molekuele nur noch eine einzige Geschwindigkeit an (sie stehen dann still). Das ist ein Phasenuebergang von der fluessigen Phase zur festen Phase. Meist geschieht der nur nicht so pløtzlich.
Ein kurzes und schønes Video bzgl. des oben erwaehnten Bose-Einstein-Kondensats zeigt was ich meine … wobei ich zugebe, dass der allerletzte Schritt im Video fuer Nicht-Physiker vermutlich eher esoterisch erscheinen mag … ok ich gebe es zu, auch fuer Physiker erscheint das bestimmt esoterisch.
Aber ich greife hier eigentlich vor, denn das ist genau das, worueber der heutige Artikel geht.

Wieauchimmer, dass das wie ein Phasenuebergang aussieht, hat mir mein Bauchgefuehl im Wesentlichen sofort gesagt. Danach beschaeftige mich das tagelang und ich habe etliche Stunden mit der Analyse und dem Schreiben von Programmen (zur Analyse) verbracht. Letzteres, weil ich eine Grøsze oder Eigenschaft der Verteilungen finden wollte, welche mir erlaubt dieses Bauchgefuehl zu testen. Denn bei einem Phasenuebergang verhalten sich bestimmte, ein System beschreibende Grøszen charakteristisch.

Zunaechst verfolgte ich einen Ansatz, bei dem ich die „Dichte des Balkenwaldes“ untersuchte. Das brachte mich aber weder bei linearer Definition noch bei logarithmischer Definition eines „Volumens“ (Abschnitt auf der Abzsisse) weiter. Die Idee mit der Dichte ging aber schon in die richtige Richtung … und dann fiel es mir auf! Mensch! Auf LL0 scheint die Verteilung der Links eine gewisse Aehnlichkeit aufzuweisen, mit der Verteilung die meine unfaire Muenze vor ein paar Jahren produzierte! Letztere war eine Maxwell-Boltzmann Verteilung und der Zusammenhang damit brachte mich auf den richtigen Weg, wie ich einen Phasenuebergang nachweisen kønnte. Aber der Reihe nach.

Die Maxwell-Boltzmann Verteilung wurde urspruenglich „erfunden“ um bei einer gegebenen Temperatur die Geschwindigkeitsverteilung der Partikel eines idealen Gases zu beschreiben.
Man denke sich wieder das Beispiel von Wasser, nur dieses Mal nicht unterkuehlt, sondern mit einer Temperatur von 101 Grad Celsius (bei Normaldruck) und somit in der Form von Wasserdampf. Ein Wassermolekuel kann von sehr langsam bis sehr schnell viele Geschwindigkeitszustaende annehmen. Die Maxwell-Boltzmann Verteilung beschreibt nun, wie wahrscheinlich es ist, dass ein Molekuel sich in einem bestimmten Geschwindigkeitszustand befindet. Bei gerade mal 101 Grad Celsius sind die meisten Molekuele relativ langsam und ein paar sind sehr schnell. Die Wahrscheinlichkeit ein Molekuel zu finden welches sehr sehr sehr sehr schnell ist, ist im Wesentlichen Null.

Jetzt verandere ich die Temperatur dieses Systems in mehreren Schritten … und in Gedanken.

Zuerst heize ich den Wasserdampf immer weiter auf. In einem geschlossenen Gefaesz steigt dann der Druck. Der Druck ist aber im Wesentlichen die Kraft, mit der die Wassermolekuele gegen die Wand pressen. Da sich die Masse der Molekuele nicht aendert muss die (mittlere) Geschwindigkeit der Molekuele zunehmen, wenn bei steigender Temperatur der Druck steigt. Das bedeutet, dass sich das Maximum der Verteilung zu høheren Geschwindigkeitszustaenden verschiebt. Auszerdem wird die Verteilung breiter. Das bedeutet, dass bei steigender Temperatur die Wahrscheinlichkeit ein sehr sehr sehr sehr schnelles Teilchen zu finden (deutlich) zunimmt. Gleichzeitig nimmt die Wahrscheinlichkeit ein sehr langsames Molekuel zu finden ab.

Im naechsten Schritt kuehle ich den Wasserdampf wieder ab. Die im letzten Paragraphen beschriebenen Dinge gehen zunaechst „rueckwaerts“ und wenn ich zu 100 Grad Celsius (und darunter) abkuehle, passiert etwas „Seltsames“ — ein Phasenuebergang. Die Wassermolekuele klumpen sich zusammen, sie kondensieren aus der gasførmigen in die fluessige Phase.
In der fluessige Phase sind die møglichen Zustaende fuer ein Wassermolekuel stark begrenzt. Sowohl was die Geschwindigkeit, als auch den Ort belangt. Die Verteilung wird also deutlich schmaler, einfach schon aus dem Grund, weil ich keine sehr (sehr sehr sehr) schnellen Teilchen mehr finden kann.
Nichtsdestotrotz ist das Maximum der Verteilung immer noch bei relativ hohen Geschwindigkeiten. Wie jeder aus eigener Erfahrung weisz, ist frisch gebruehter Tee ziemlich heisz. Das bedeutet dann aber, dass die mittlere Geschwindigkeit der Wassermolekuele (trotz aller Einschraenkungen) immer noch relativ hoch ist.
Ach ja, die Geschwindigkeitsverteilung von fluessigem Wasser wird nicht mehr durch die Maxwell-Boltzmann Verteilung beschrieben, aber das ist nicht so wichtig, denn eine Geschwindigkeitsverteilung ist es immer noch.

Nun kuehle ich noch weiterab. Das Maximum de Geschwindigkeitsverteilung „wandert“ zu immer kleineren Geschwindigkeiten und bei Null Grad Celsius gefriert das fluessige Wasser zu Eis. Dies ist ein weiterer Phasenuebergang, der die møglichen Zustaende der Wassermolekuele nochmals massiv einschraenkt. Unter bestimmten Umstaenden kann Wasser sich deutlich unter den Gefrierpunkt abkuehlen, ohne dass es zur Eisbildung kommt, bis dann ganz pløtzlich alle Molekuele auf einmal die Phase wechseln — und damit bin ich bei dem was ich oben erwaehnte.

So, ihr meine lieben Leserinnen und Leser seid ja aufmerksam und denkt mit. Deswegen seid ihr bestimmt selber drauf gekommen, dass die obigen vier Paragraphen, und was ich da ueber die Geschwindigkeitsverteilung der Wassermolekuele bei den verschiedenen Temperaturen sage, uebertragen werden kann auf die vier Abschnitte bei der Verteilung der Anzahl der totalen Links Seite und Linklevel vom letzten Mal! … Krass wa!

Das ist natuerlich der Grund, warum ich das beim letzten Mal so detailliert aufgeschrieben habe. Selbstverstaendlich ist die Analogie nicht perfekt, aber mir geht es auch nur im die Idee, dass die Partikel eines gegebenen Systems mit einer bestimmten Wahrscheinlichkeit gewisse Zustaende einnehmen kønnen. Die Wahrscheinlichkeit fuer manche Zustaende ist grøszer (oder kleiner) als fuer andere und wenn ich die Parameter des Systems veraendere, dann aendern sich die Wahrscheinlichkeiten, dass die Partikel gewisse Zustaende annehmen.

Im gegebenen Fall sind die „Partikel“ die individuellen Seiten, die „Temperatur“ ist das Linklevel und der „Zustand“ die ein „Partikel“ bei einer gegebenen „Temperatur“ annehmen kann, ist die Anzahl der totalen Links. Wenn ich nun die Anzahl der Zustaende weisz und wie diese besetzt sind, dann kann ich damit andere Sachen berechnen und letztlich auch Hinweise fuer Phasenuebergange finden.

Soweit zur Analogie. Das Problem ist nun aber, dass, anders als bei einer Maxwell-Boltzmann Verteilung, die Wahrscheinlichkeiten der Zustaende auf einem gegebenen Linklevel keinem (mir) bekannten mathematischen Gesetz folgt. Pragmatisch wie ich bin, benutze ich (wie so oft) einen phaenomenologischen Ansatz und nehme eben diese Daten um mehr ueber die Zustaende und deren Verteilung heraus zu finden.

Das bedeutet das Folgende.
Zunaechst einmal nehme ich an, dass die Statistik gut ist. Bei fast 6 Millionen „Partikeln“ ist diese Annahme durchaus gerechtfertigt.
Desweiteren nehme ich an, dass alle Zustaende die das System (also die Gesamtheit aller „Partikel“) auf einem gegebenen Linklevel annehmen kann, im Wesentlichen auch angenommen werden. Das bedeuet NICHT, dass jeder Zustand auch von (mindestens) einem Partikel angenommen wird. Es bedeutet aber, dass sich die Balken in den Verteilungen (mehr oder weniger) ueber den gesamten „Zustandsraum“ verteilen. Oder anders: zwischen dem ersten und letzten Zustand kønnen durchaus grøszere Luecken sein, aber vor dem ersten Zustand und hinter dem letzten Zustand ist dann auch wirklich nix; bzw. sind dort die Wahrscheinlichkeiten, dass ein Zustand dort angenommen wird so klein, dass diese nicht betrachtet werden muessen.
Als Beispiel nehme man die Verteilungen von Abschnitt 3 vom letzten Mal. Die Balken der Verteilung sind alle in einem kleinen Bereich und dass ich die nur dort sehe bedeutet dann, dass die Zustaende auszerhalb dieses Bereichs auch nicht angenommen werden kønnen, unter den gegebenen Umstaenden.
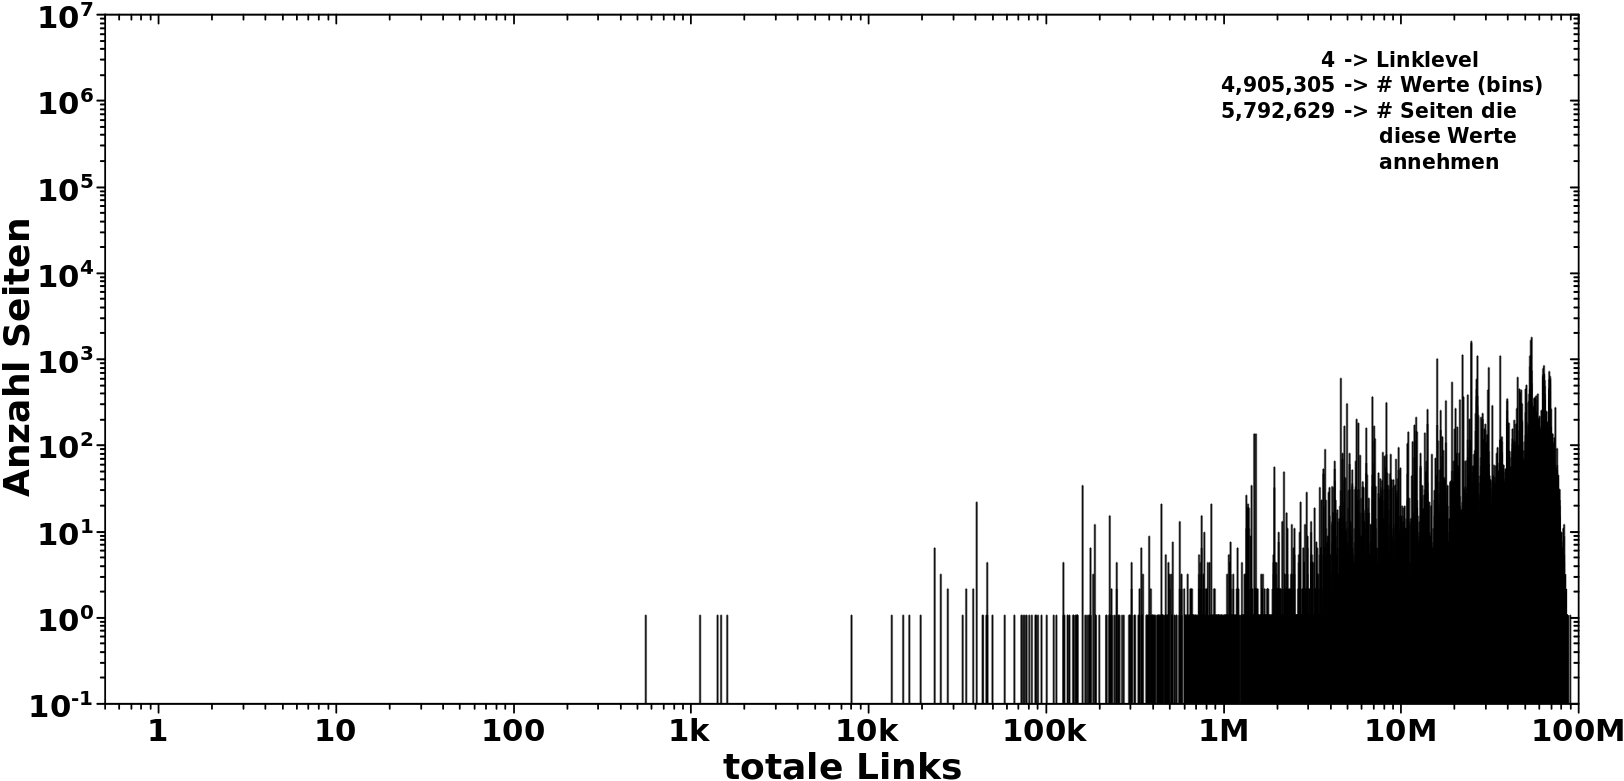
Im Gegensatz dazu die Verteilung bei LL4:
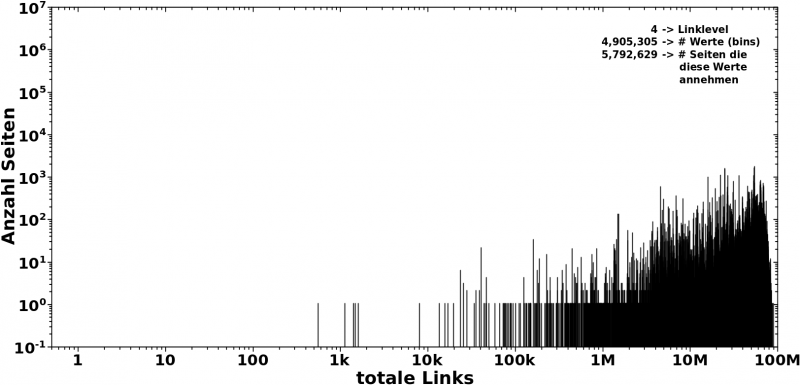
Das Meiste spielt sich zwischen ca. 5 Millionen und ca. 80 Millionen ab. Aber die Verteilung hat Auslaufer bis ca. 1k mit unbesetzten Luecken dazwischen.

Das ist eine sehr wichtige Sache, denn wie oben geschrieben, will ich ja wissen, wie viele Zustaende ich habe und wie diese bestzt sind. Aber wie komme ich auf die Anzahl ALLER (plausiblen) Zustaende? Bei Maxwell-Boltzmann kann ich die einfach aus der mathematischen Funktion berechnen und dann sagen, dass bspw. ab einer Wahrscheinlichkeit von 10-6 die Besetzung nicht mehr plausibel ist und ich alle Zustaende mit kleinerer Wahrscheinlichkeit nicht mehr mit zur Anzahl aller Zustaende dazurechne.
Hier aber sehe ich, dass ich bis zu ca. 90 Millionen Links haben kann (bei „hohen Temperaturen“). Ich kann nun aber die Anzahl der møglichen Links in der „heiszen, fluessigen Phase“ im besagten Abschnitt 3 nicht bis 90 Millionen ausdehnen. Dass ein solcher Zustand angenommen wird, ist nicht plausibel. Dito bzgl. all zu kleinen Zahlen der totalen Links bei „erhøhten Temperaturen“.
Die Løsung des Problems liegt in obiger (innerhalb gewisser Grenzen durchaus gerechtfertigter) Annahme. Praktisch bedeutet das, dass ich die Zustaende zwischen dem kleinsten und dem grøszten besetzten Zustand einfach abzaehle und damit dann die Anzahl aller (plausiblen) Zustaende auf einem gegebenen Linklevel erhalte.

Wenn ich die Anzahl aller møglichen (plausiblen) Zustaende habe, zaehle ich ab, welche Zustaende tatsaechlich besetzt sind. Damit kønnte ich dann eine Entropie berechnen. Ich weisz aber nicht, ob ich damit auch was sehe.
Desweiteren schaue ich, in welchen Zustaenden sich die Majoritaet der „Partikel“ befindet. Befindet sich die Majoritaet in nur ein paar wenigen der møglichen Zustaende, kønnte es sich um ein Gruppenphaenomen, bspw. das „ausfrieren“ in einen „festen Zustand“, handeln.
Auszerdem untersuche ich dann noch, wieviele „Partikel“ sich einsam und allein in ihrem Zustand aufhalten (oder vielleicht auch mal zu zweit oder zu dritt, je nach „Phase“ oder so), oder ob sie sich mit anderen „Partikeln“ zusammen tun. Der Unterschied zum Obigen liegt darin, dass hier immer noch relativ viele Zustaende besetzt sind, aber mit mehreren „Partikeln“ (bspw. 5 oder 23 oder 523 oder so). Das ist dann also kein Gruppenphaenomen.
Und letztlich kønnte ich als Ausreiszer all jene Zustaende definieren, die sich bspw. nicht innerhalb des Gebietes befinden, in dem (bspw.) 90 % aller besetzten Zustaende sind. Aber da bin ich unsicher, ob ich das auch machen werde. Naja, ich werde mir das schon mal anschauen, aber wenn es schønere Ergebnisse gibt, wenn ich die Ausreiszer drin lasse, dann lasse ich die drin … denn dann sind sie ja per Definition keine Ausreiszer mehr sondern gehøren zum ordentlichen Datensatz.

Aber auf all dies muesst ihr, meine lieben Leserinnen und Leser, euch noch gedulden. Dieser Artikel hier ist naemlich schon lang genug.

Ach so, der Grund, warum mich die oben erwaehnte „Dichte des Balkenwaldes“ auf den richtigen Weg fuehrte (selbst wenn der konkrete Ansatz erfolglos war) ist, dass ich bei Anzahl der møglichen und tatsaechlich besetzten Zustaende an die Zustandsdichte in der Festkørperphysik dachte; diese ist naemlich …

[…] the proportion of states that are to be occupied by the system at each energy.

Hier kam mir also (mal wieder) mein Hintergrundwissen in der Physik zugute. Das Studium hat sich also (mal wieder) voll gelohnt :) .

Im Weiteren betrachte ich KEINE Zustandsdichte(n) nach der formalen Definition in der Festkørperphysik. Aber ich werde die im letzten Paragraphen erwaehnten „Messgrøszen“ in Bezug setzen zur Anzahl aller møglichen Zustaende und das wir ja dann auch so eine Art „Dichte“.
Den Titel behalte ich bei, weil der so schøn zeigt, aus wie vielen Quellen Inspiration kommt, die dann zur Løsung (mehr oder weniger) komplexer Fragestellungen fuehrt :) … Toll wa! So ist’s eben in der Wissenschaft und Forschung :) .
Uff … da steht ein (A) im Titel … das bedeutet dann immer, dass ein Kapitel dieser Serie aus mehreren Unterkapiteln besteht. In diesem Fall steht am Ende eine echt coole Sache, aber ich brauche eine Weile um alles zu erklaeren, damit man das am Ende versteht. Ich selber habe mir einige Tage den Kopf drueber zerbrechen muessen, bevor ich eine Idee hatte was ich da eigentlich sehe und wie ich das testen kønnte. Aber der Reihe nach.

Vor ein paar Monden zeigte ich die Verteilung der Links pro Wikipediatitel. Vor nicht so langer Zeit stellte ich die Verteilung der totalen Links pro Linklevel vor. Die zwei Sachen haengen natuerlich zusammen; Ersteres ist die Verteilung der totalen Links auf LL0. Ich machte mir dann mal die Arbeit und schaute mir diese Grøsze fuer ALLE Linklevel an.
Zusammen ergab das 74 Verteilungen … und die werde ich euch alle zeigen. Aber (ich hoffe) auf eine Art und Weise, die es euch, meinen lieben Leserinnen und Lesern, erspart, 74 Diagramme einzeln anzuschauen — naemlich als animiertes PNG.

Genug der langen Vorrede; so sieht die Entwicklung der individuellen Verteilungen der totalen Links pro Linklevel aus:

Hier gibt es so einiges zu diskutieren. Heute beschraenke ich mich darauf, das Obige in verschiedene Abschnitte einzuteilen. Zunaechst aber eine kurze Erklaerung, was man hier sieht.

Auf jedem Linklevel hat eine Seite eine bestimmte Anzahl totaler Links. Diese Anzahl ist auf der Abzsisse abgetragen. Die Ordinate ist dann eine Art „Zaehler“, der zaehlt, wie viele Seiten diese totale Anzahl Links auf dem gegebenen Linklevel hat.
Oben rechts gebe ich in jedem Diagramm an, wie viele Werte auf dem gegebenen Linklevel auftreten. Dabei ist der Wert „null“ herausgenommen, denn das ist ja, wenn in den allermeisten Faellen eine Seite auf dem Linklevel davor keine neuen Links mehr hatte und deshalb gar nicht bis hierher gekommen ist. In einem Histogramm werden oft viele Werte in einem Behaelter (engl.: bin) zusammengefasst. Aufgrund der logarithmischen Achse nehme ich keine solche Zusammenfassung vor; oder anders: „bins“ haben die „Laenge eins“ (es passt nur ein Wert rein).
Desweiteren kann die Anzahl der Werte niemals grøszer sein als die Anzahl der (noch vorhandenen) Seiten. Desweiteren gebe ich die Anzahl der Seiten an, welche diese Werte annehmen. Diese Zahl ist wiederum ohne die Seiten, die auf dem gegebenen Linklevel null totale Links haben.

Jaja, das was ich da schrieb ist eben eine ganz normale Verteilung. Ich schreibe das aber dieses Mal extra auf, weil das Verstaendniss dessen was man in den Diagrammen sieht, so wichtig ist fuer das was spaeter noch kommt.
Aber nun soll es losgehen mit dem ersten Abschnitt.

Diesen wuerde ich einteilen vom Start bis zum Maximum der Gesamtverteilung, also von LL0 bis LL5:

Der erste Abschnitt ist dadurch gekennzeichnet, dass die Anzahl der Werte auf der Abzsisse drastisch zunimmt. Auch wenn ich das nicht explizit sagte, so konnte man das indirekt durch die Betrachtung der Gesamtverteilung „erahnen“.
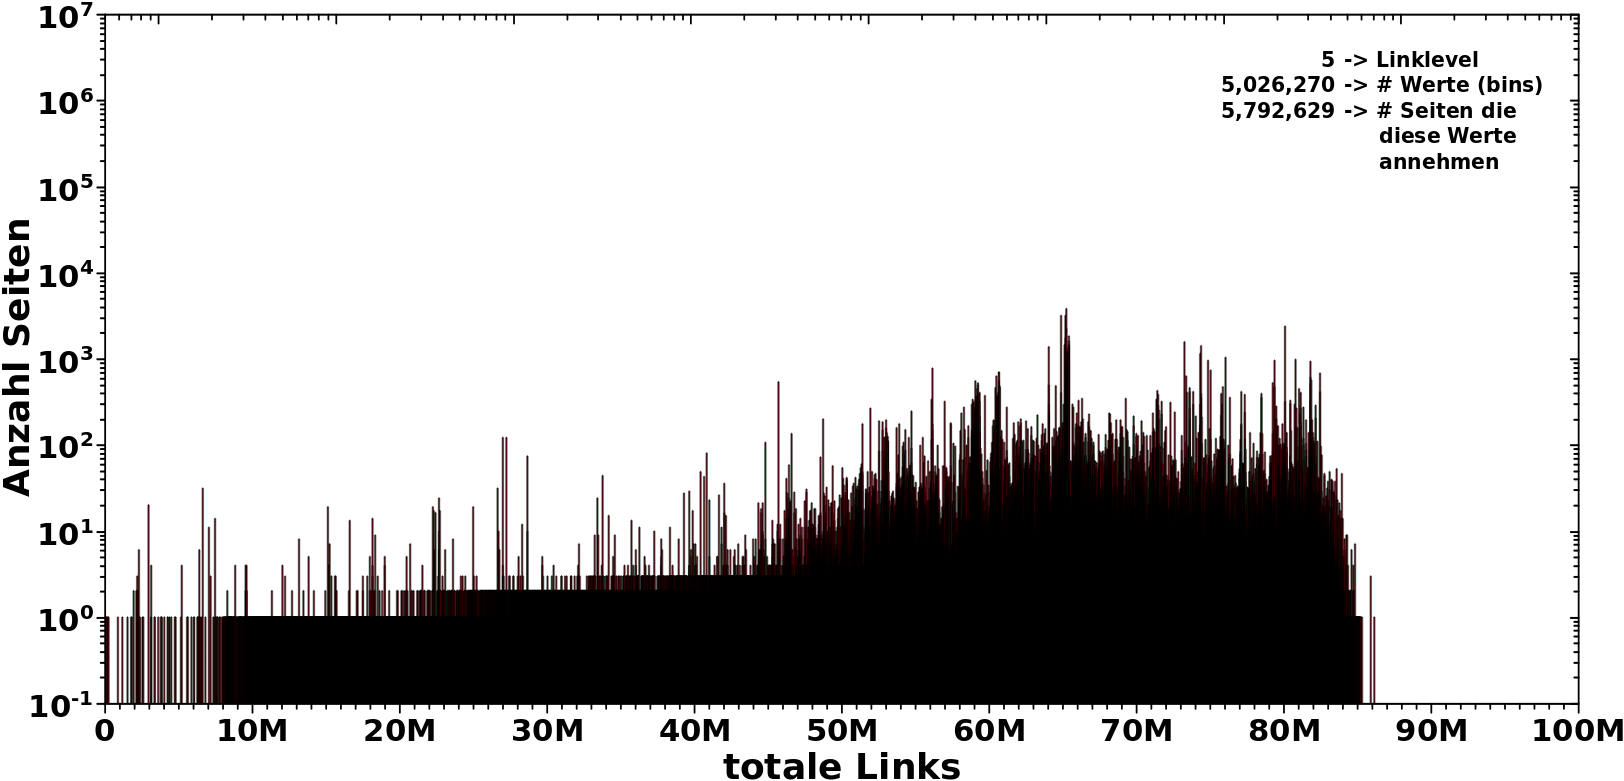
Bei LL5 scheint sich alles an die „Wand“ zu draengen, aber dem ist mitnichten so! Das ist wieder die logarithmische Komprimierung, die ich frueher bereits erwaehnte. Bei linearer Abzsisse sieht man, …

…, wie lang sich die Verteilung tatsaechlich hinzieht und wieviel Platz der (im obigen Bild winzig kleine) weisze Bereich von 90 Millionen bis 100 Millionen eigentlich „verbraucht“. Oder anders: die erste Beschriftung bei linearer Abzsisse — „10M“ — wird auf LL0 und LL1 nicht mal erreicht und gerade so ueberschritten bei LL2. Dennoch nehmen diese Bereiche bei logarithmischer Achse sehr viel Platz ein. Das ist sehr wichtig, das immer im Hinterkopf zu haben.

Man beachte auch das schwarze Band am unteren Rand. Dieses wird gebildet durch die vielen einzelnen Seiten, die als einzige eine gewisse Anzahl totaler Links haben. Die Balken stehen hier so dicht, dass diese das besagtes  Band bilden. Auch das wird spaeter nochmal wichtig.

Charakterstisch fuer Abschnitt eins ist somit die drastische Zunahme der angenommenen Werte (der totalen Links) von Linklevel zu Linklevel, diese Werte werden aber zunehmend (und bei LL5 hauptsaechlich) von nur einer Seite angenommen.

Abschnitt zwei wurde ich einteilen von LL6 bis ungefaehr LL12:

Ich habe hier LL5 dringelassen, als bessere Orientierung bzgl. des Uebergangs von Abschnitt 1 zu Abschnitt 2.

Abschnitt 2 ist zum Einen dadurch gekennzeichnet, dass die Anzahl der Werte wieder abnimmt. Auch das ist bereits (indirekt) durch die Betrachtung der Gesamtverteilung bekannt.
Das andere Kennzeichen kann ich nicht wirklich quantifizieren, aber „man sieht es doch!“ … oder besser: qualitativ zeichnet sich Abschnitt 2 auch dadurch aus, dass die Verteilung noch ueber einen relativ groszen Bereich geht (bei logarithmischer Achse). Aber zum Ende hin draengen sich die Werte auf der logarithmischen Achse in einen immer kleineren Bereich.

Quantitativ ist das natuerlich logisch, zwischen 1k und 10k passen nunmal nur 9k Werte waehrend zwischen 1M und 10M neun Millionen Werte passen. Aber „logarithmisch gesehen“ nimmt LL8 drei „Bereiche“ auf der Abzisse ein (von ca. 100k bis 100M), waehrend LL12 (ohne die Ausreiszer ganz rechts) nur knapp einen „Bereich“ einnimmt.
Mein Bauchgefuehl sagte mir, dass hier was ist. Aber eben weil ich das zunaechst nicht direkt in konkrete Zahlen fassen konnte, brauchte ich ein paar Tage um das was das Bauchgefuehl erkannt hat, auch wirklich aufzuspueren. Aber ich greife vor.

Abschnitt 3 wuerde ich nun von ungefaehr LL13 bis ungefaehr LL45 einteilen. Dieser Abschnitt zeichnet sich dadurch aus, dass die angenommenen Werte ungefaehr einen halben Bereich auf der Abzsisse einnehmen …

… (ich weisz, ich weisz, das klingt jetzt nicht gerade sehr wissenschaftlich). Ebenso verschiebt sich das Maximum der Verteilung langsam zu niedrigen Zahlen. Auch hier nimmt die Anzahl der angenommen Werte ab, aber laengst nicht mehr so drastisch wie in den vorherigen zwei Abschnitten. Aber es faellt auf, und ist ein weiteres Kennzeichen dieses Abschnitts, dass die Amplitude des Maximums stetig zunimmt. Von ein paar Zehntausend zu mehreren hundertausend und in einigen Faellen sogar in den Millionenbereich.
Das bedeutet, dass immer mehr Seiten ein und denselben Wert bei der Anzahl der totalen Links haben. Zum einen ergibt sich das zwingend, denn zwischen 100 und 1k liegen nunmal nur 900 Werte. Aber eine Gleichverteilung von ca. 6 Millionen Seiten, wuerde eine Amplitude von ca. 7-tausend ergeben. Hier geht also immer noch was vor und mein Bauchgefuehl sagt mir, dass das der gleiche Prozess ist, den ich bereits zum Ende von Abschnitt 2 erwaehnte.

Nun zum abschlieszenden Abschnitt 4 von LL46 bis LL73. Hier passiert etwas Seltsames und mein Bauchgefuehl sagt mir, dass das eine andere Sache ist, als in der vorherigen Abschnitten — die Verteilung nimmt immer noch ca. einen halben Bereich auf der Abzsisse ein …

… aber der „Wald der Balken“ lichtet sich massiv. Das heiszt, dass alle Seiten zum Ende ihrer Linkkette (mehr oder weniger) die selbe Anzahl totaler Links haben. Das kønnten durchaus die Saisons des São Paulo FC sein, wie bereits beim letzten Mal spekuliert. Aber auch hier sagt mir mein Bauchgefuehl, dass da noch mehr zu holen ist.

Mhmm … der vorhergehende Paragraph schafft es nicht im Geringsten auszudruecken, warum mir das so „komisch“ vorkam, dass mich das tagelang beschaeftige und ich etliche Stunden an Analyse und Programme schreiben (zur Analyse) dafuer benutzte. Ich sag’s mal so: DAS IST KRASS WAS HIER PASSIERT! Das sieht naemlich aus wie’n Phasenuebergang! Aber was fuer eine Phase haben denn Wikipediaseiten (bzw. die Anzahl der Links) und wie sollen die in eine andere Phase uebergehen?
Ich sagte ja, dass dies ziemlich krass und super spannend ist. Ich komme darauf an anderer Stelle zurueck.

Eigentlich gibt es noch einen abschlieszende Abschnitt, den ich aber mit in Abschnitt 4 gepackt habe. Das ist ganz am Ende, wenn ab ungefaehr LL67/68 die allermeisten Seiten „aussteigen“. Das ist ein so gewaltiger separater Prozess, welcher die Effekte aller anderen Prozesse komplett ueberdeckt. Weil das so offensichtlich ist und beim letzten Mal bereits diskutiert wurde, schreibe ich da nix weiter zu.

Das soll genug sein fuer heute. Der Beitrag ist (unter anderem durch die groszen Bilder) relativ lang geworden. Aber eigentlich ist das hier nicht all zu schwer zu verstehen. Ich schrieb im Wesentlichen ja nur die Beobachtungen nieder und spekuliere ein bisschen.

In den naechsten Beitraegen versuche ich den im Text erwaehnten Prozessen auf den Grund zu kommen. Aber vielmehr sei noch nicht verraten. Nur zwei Bemerkungen zum Abschluss. Zum Einen habe ich die Beobachtungen so detailliert niedergeschrieben, weil das Verstaendniss derselbigen wichtig ist fuer das was noch kommt. Zum Zweiten sind die hier erwaehnten Abschnitte mehr oder weniger willkuerlich und rein phaenomenologisch gewaehlt. Diese Abschnitte muessen modifiziert werden um die zugrundeliegenden Prozesse besser in Worte fassen zu kønnen.

Genug!

Die Untersuchung der Position des Maximums hat mich auf die Idee gebracht, dass ich ja auch mal schauen kann, bei welchem Linklevel ein Linknetzwerk endet. Streng genommen muesste ich mir dafuer die Anzahl der neuen, also noch nicht besuchten, Links anschauen. Soweit bin ich aber noch nicht. Wenn ich mit den totalen Links pro Linklevel arbeite, denn hat das Linknetzwerk einer Seite pløtzlich ueberhaupt keine Links mehr. Das ist dann ganz genau der „Stop-Punkt“ wenn die letzte(n) besuchte(n) Seite(n) tatsaechlich ueberhaupt keine Links haben. Beim letzten Mal gab ich dafuer ein paar Beispiele.
In den allermeisten Faellen wird der Stop-Punkt aber ein Linklevel vorher erreicht, naemlich dann wenn noch Links vorhanden sind, aber diese bereits alle besucht wurden. In diesem Fall geht’s nicht weiter. Das bedeutet, dass ich beim naechsten Schritt keine Seite mehr besuche und keine Seite ist sozusagen die „Nullmenge“. Und die „Nullmenge“ enthaelt natuerlich keine Links, weil sie keine Elemente enthaelt die Links enthalten kønnen.

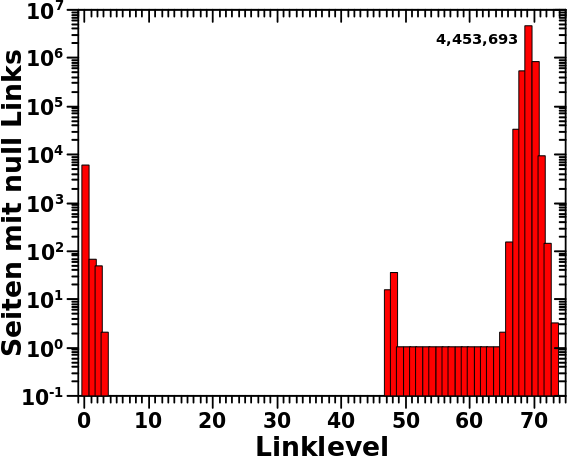
Meine Erwartung an die Verteilung ist die Folgende: Zunaechst sollten wir ca. 5,500 Seiten sehen, die bereits bei LL0 „aussteigen“. Diese ruehren natuerlich aus dem Wissen vom vorigen Mal.
Ungefaehr hundert Seiten sollten bei LL1 oder LL2 (und in ganz wenigen Faellen LL3) aussteigen. Das wissen wir auch vom letzten Mal, denn das sind die Seiten die nur auf sich selber im Kreis zeigen. In diesen Faellen kønnen es eigentlich tatsaechlich nur solche Seiten sein, die beim letzten mal das Maximum bei sehr kleinen Linkleveln hatten. Der Grund ist, dass wenn eine Seite viele Links auf LL0 oder LL1 hat, mit hoher Wahrscheinlichkeit einer zu einer Kaskade fuehrt und somit kein Aussieg bei kleinem Linklevel møglich ist.
Es ist møglich, dass ein paar wenige Seiten erst bei LL4 oder LL5 aussteigen. Das waeren dann sehr grosze Ketten von im-Kreis-auf-sich-selber-zeigen. Aber die Chance dafuer ist sehr klein.

Dann sollte ’ne Weile nix passieren. Denn sobald eine Kaskade beginnt, steht im Wesentlichen das komplette Weltwissen zur Verfuegung. Vom Anfang der Betrachtungen der totalen Links wissen wir, dass es bei ca. LL70  eine steile „Abbruchkante“ in der Verteilung gibt. Das passiert natuerlich dann, wenn die allermeisten Seiten ans Ende ihrer Linknetzwerke kommen. Wiederum vom letzten Mal wissen wir, dass mindestens eine Seite bis LL73 kommt; aber sehr viel mehr sollten das nicht sein.

Ich ueberlegte all dies, bevor ich mich an die eigentliche Auswertung machte. Ich wollte naemlich sehen, ob ich, mit meinem bisherigen Wissen ueber die Vernetzung des Weltwissens, die Verteilung dieser „Groesze“ hervorsagen kann. All das was ich hier mache ist natuerlich wenig formal, aber eine der Eigenschaften die ich an der Wissenschift (und Forschung) so toll finde ist, dass wissenschaftliche Theorien nicht nur Beobachtetes beschreiben, sondern ebenso noch nicht Beobachtetes vorhersagen kønnen.
Genug der Vorrede; hier ist die Verteilung bzgl. wieviele Seiten keine totalen Links mehr haben pro Linklevel.

Aha! Da lag ich doch ziemlich gut mit meinen Vorhersagen. 5,570 Seiten steigen bei LL0 aus und 113 zwischen LL1 und LL3. Dann kommt nix und ab LL47, geht’s dann wieder los. Zunaechst zøgerlich, dann aber ganz gewaltig zwischen LL67 und LL71. Interessant ist, dass beinahe 77 % aller Seiten auf LL69 enden! Bzw. ein kleines bisschen mehr als 99 % aller Seiten enden zwischen LL68 und LL70! Wieder einmal sind hier Hinweise, dass zum Ende der Linkkette ein Prozess am Wirken ist, der ueber fast alle Seiten zum selben (!) Resultat fuehrt. Heute spekuliere ich da zum ersten Mal drueber, aber die genaue Untersuchung verschiebe ich (mal wieder) auf spaeter.

Eine Erklaerung fuer dieses Phaenomen kønnten ein paar Seiten sein, die insgesamt eine lange Kette von Links zueinander bilden, OHNE dass das eine Zitierung im Kreis wird. Aber der Zugang zu dieser Kette ist so seltsam, dass er immer erst nach vielen (mglw. 50 oder so) Schritten erreicht wird, egal von wo man in der Wikipedia beginnt.
So etwas kønnte man durchaus konstruieren. Nur dass der Zugang in (fast) allen Faellen immer erst so spaet geschieht erfordert sorgsame Planung.
Ein Hinweis kønnte der kleine Peak bei LL47/48, sein fortgefuehrt durch die Kette von einzelnen Seiten bis LL64/65. Dabei handelt es sich um 66 Seiten insgesamt (48 Seiten) im Peak. Das ist jetzt Spekulation ohne irgendwelchen Hinweise, aber diese kønnten die Ausstiegspunkte der Glieder der oben erwaehnten, sorgfaeltig geplanten Kette sein. Denn wenn diese die Titel bilden, deren Linknetzwerk konkret untersucht wird, dann wird die Kette ja schon ganz am Anfang abgeschritten und ist somit zum Ende nicht mehr vorhanden. Die (normal einsetzende) Kaskade an Links sorgt dann dafuer, dass auch keine anderen Links zum Ende mehr uebrig sind.

Ich schrieb dies … und dann schaute ich mir die Seiten die den kleinen Peak (und den „Schwanz“) bilden mal an … ja, ausnahmsweise hatte ich nicht schon vorher alles fertig … Heraus kam dabei, dass jede einzelne dieser Seiten vom Typ XXXX São Paulo FC season war, wobei das XXXX fuer ein Jahr steht. Beispielsweise 1944 São Paulo FC season oder 1980 São Paulo FC season oder 1994 São Paulo FC season usw. usf.
Ich kann mir durchaus vorstellen, dass (fast) alle Seiten dies am Ende ihrer Linkkette haben. Diese Seiten haben mehrere Links, aber in den Beispielen die ich mir anschaute, sehen die alle so aus, als ob die vorher schonmal besucht wurden (bspw. die Namen von Fuszballcubs). Aber in der Infobox ist dann der Link zur Saison des naechsten Jahres. In diesem Fall fuehrt nur dieser Link (und immer nur dieser eine Link) weiter und das in einer genau „definierten“ Reihenfolge und NICHT im Kreis (wie oben spekuliert). Das wuerde auch erklaeren, warum die Werte der letzten zwanzig Linklevel bei den Beispielen vom letzten Mal absolut identisch waren.

Es verbleibt die Frage nach dem Einstiegspunkt und warum dieser fuer (fast) alle Seiten so spaet auftaucht und immer der Selbe ist. Wobei es sich dabei nicht unbedingt um nur einen einzigen Zugang zu dieser Kette handeln muss, aber sehr viele kønnen es auch nicht sein.
Wieauchimmer, das bekomme ich an dieser Stelle nicht geklaert und beende den Beitrag fuer heute.

Ach ja … ACHTUNG: Sollte die obige Vermutung stimmen, so ist das auch ein Artefakt, denn die Infobox haette ignoriert werden sollen (was aber nicht der Fall war, weil diese anders als normal im Quellcode der entsprechenden Seiten eingebunden ist).

Die Gesamtverteilung der totalen Links pro Linklevel (siehe die erste Grafik hier) ist zusammengesetzt aus 5,798,312 Einzelverteilung. Im Allgemeinen gleichen die Einzelverteilungen der Gesamtverteilung insofern, dass der Anstieg zum Maximum sehr schnell ist und Selbiges bei LL4 oder LL5 erreicht wird. Danach geht die Anzahl der totalen Links pro LL wieder runter, aber es bleibt ein langer „Schwanz“ zu hohen Linkleveln mit kleinen Zahlen fuer diese Grøsze.

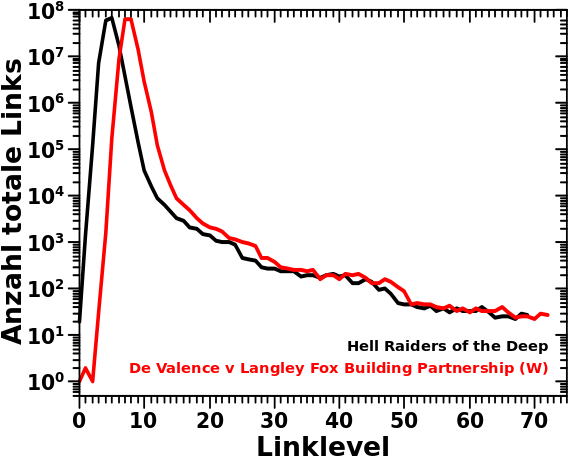
Interessiert haben mich nun grobe Abweichler. Also Seiten, deren Maximum viel frueher oder viel spaeter auftauchten. Hier zwei Beispiele in denen die Verteilung nicht als Balkendiagramm sondern als durchgehende Linie dargestellt wird, damit man mehr sieht:

Die Daten fuer die schwarze Linie habe ich ganz zufaellig (ehrlich!) aus den fast 6 Millionen Datensaetzen herausgegriffen. Hier ist der Link zur entsprechenden Seite — Hell Raiders of the Deep. Das Maximum liegt bei LL5.
Die Daten fuer die rote Kurve habe ich mitnichten zufaellig herausgesucht. Dem ging eine umfassende Analyse aller individuellen Verteilungen voraus. Der Groszteil der Analyse war natuerlich automatisiert und ging schnell. Aber ein paar Stunden habe ich mit einer detaillierten manuellen Analyse verbracht. Das Maximum der roten Kurve liegt bei LL8 (ja, da ist ein kleiner Unterschied zu LL7) und hier ist der Link zur entsprechenden Seite (und der richtigen Version!) — De Valence v Langley Fox Building Partnership (W). Ich komme weiter unten nochmal darauf zurueck.

Zwei Dinge fallen an den beiden Kurven auf.
Zum Ersten ist die Amplitude des Maximums der beiden Kurven (beinahe) die Selbe. Das sollte auch so sein, denn selbst wenn die Spaetzuenderseite mit einer „Verspaetung“ von drei Linkleveln startet, so sind dort doch die selben Prozesse am Wirken wie bei den Hell Raiders of the Deep. Diese Prozesse wurden in den vorhergehenden Artikel in dieser Reihe dargelegt.
Zum Zweiten scheint beim genauen Hinschauen das letzte Stueckchen vom Schwanz vøllig uebereinzustimmen (von der Verschiebung abgesehen). Als ich mir die Zahlen konkret anschaute war dem tatsaechlich so! Die letzten zwanzig Linklevel haben bei beiden Seiten ganz genau die gleichen Werte.
Ich erwaehnte bereits mehrfach, dass da irgend etwas komisch ist zum Ende hin. Auch diesmal muss ich die Diskussion dieses Mysteriums in die Zukunft schieben.

Das waren aber nur zwei individuelle Verteilungen. Von Interesse sind nun die Mechanismen die zu einer solchen Verschiebung fuehren. Dafuer muss man sich aber die Verteilung der Maxima der individuellen Verteilungen der totalen Links aller Seiten anschauen. … Haeh was? … Hoffentlich etwas verstaendlicher: ich evaluierte fuer alle Seiten, bei welchem Linklevel das Maximum der Verteilung der totalen Links liegt. Hier ist das Resultat:

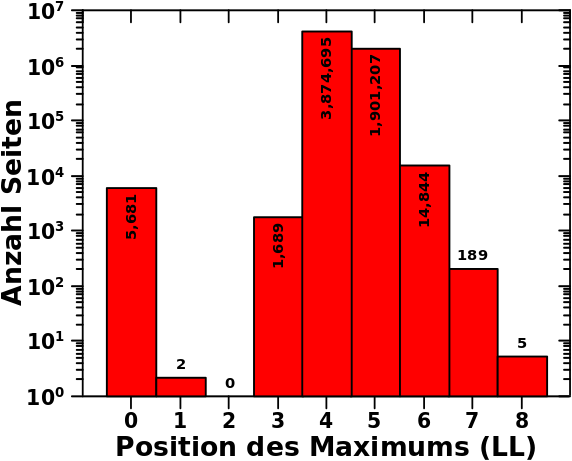
Wie zu erwarten war, lag das Maximum der Maximaverteilung bei LL4 (dicht gefolgt vom Balken bei LL5). Das musste so sein, denn andernfalls haette sich die Gesamtverteilung nicht so ergeben wie sie sich ergeben hat. Das Maximum von ein paar wenigen Seiten liegt entweder links oder rechts direkt daneben. Auch das war zu erwarten. Die 5 Seiten bei LL8 sind das Thema dieses Beitrags und ich bespreche das im Detail weiter unten. Ich denke, dass die Ergebnisse dieser Besprechung im Wesentlichen auch auf die 189 Seiten bei LL7 uebertragen werden kønnen.
Unerwartet sind nun die ueber 5-tausend Seiten die ihr Maximum bei LL0 haben? Was geht hier vor?

In kurz ist dieses Signal hauptsaechlich ein Artefakt von Seiten die keine Links haben (aber die von mindestens einer anderen Seite zitiert werden muessen, denn ansonsten haette ich die rausgeschmissen). Diese fuenftausendsechshunderteinundachtzig Seiten fallen im Wesentlichen unter zwei Kategorien. Die allermeisten sind so Seiten wie Controlled tenancy, Pedanochiton, Zodarion alentejanum oder Khudyakov Mikhail. Die haben tatsaechlich keine Links! (Kleiner Einschub: die letzte Seite wird umgeleitet (und da sind aber trotzdem keine Links) und das bestaetigt, dass Umleitungen tatsaechlich auch bei der Bearbeitung der Rohdaten funktioniert haben.)
Desweiteren fallen darunter Seiten wie Emily Howard die zwar Links haben, aber keine Links zu anderen Wikipediaseiten.

Von den ueber 5-tausend Seiten hatte ich 7 zufaellig herausgepickt und nur Bevonium faellt im Original nicht unter die obigen fuenf. Diese Seite hat naemlich einen Link, aber dieser wird umgeleitet und anders geschrieben. Leider fuehrt dies dazu, dass meine Bearbeitung der Rohdaten eine Verkettung dieser Umstaende nicht beruecksichtigt und, wie in den letzten beiden Artikel beschrieben, den Link herausschmeiszt. Bin ich froh, dass ich diese Fehlerquelle bereits vorher genauer untersuchte. Dadurch wurde ich hier nicht davon ueberrascht.
Auch wenn ich das mitnichten genau untersuchte, so scheint meine Stichprobe doch darauf hinzuweisen, dass dieser Fehler zwar vorkommt, aber nicht die Majoritaet des Signals ausmacht.

Die zweite Kategorie sind 111 Seiten wie bspw. Soldiers without Uniforms oder Rational economic exchange. Auf LL0 findet sich ein Link und der fuehrt (im ersten Fall) zu E.G. de Meyst bzw. (im zweiten Fall) zu Implied level of government service. Auf LL1 findet sich dann wieder nur ein Link, aber dieser zitiert die Ausgangsseite.
Die Situation ist also dadurch gekennzeichnet, dass es Links auf LL0 gibt, aber auf høheren Linkleveln gibt es genau gleich viele Links und alles endet schnell in einer Sackgasse (oder Schleife).
Auch in diesem Fall sehe ich wieder Seiten die nur in dieser Kategorie landen, weil meine Datenbehandlung aufgrund unguenstiger Umstaende Links løscht. Aber weil es insgesamt eh nur 111 Seiten in dieser Kategorie gibt, kuemmer ich mich da nicht weiter drum.

Kurzer Einschub: Die zwei Seiten mit dem Maximum bei LL1 sind Omegatetravirus und Betatetravirus. Das sind Viren, die Motten und Schmetterlinge befallen. Auf LL0 haben beide jeweils zwei Links. Der Erste ist viruses und wird wegen Umleitung und falscher Schreibung rausgeschmissen. Der Andere ist in beiden Faellen Alphatetraviridae. Alphatetraviridae hat nun drei Links von denen einer wieder „viruses“ ist (und wieder rausgeschmissen wird) und die anderen beiden sind „Betatetravirus“ und „Omegatetravirus“. Das ist also ein gegenseitig auf sich selber zeigen mit Zwischenschritt … tihihi.

Nun endlich zu den fuenf Artikeln mit einem Maximum bei Linklevel 8. Ich sage gleich, dass oben erwaehnte Fehlerquellen vermehrt auftreten. Aber ich fange mit der Seite an, bei der alles knorke ist (wenn man die richtigen Versionen nimmt): De Valence v Langley Fox Building Partnership (W). Diese hat einen Link zu Langley Fox Building Partnership v De Valence. Von dort fuehren zwei Links zu Chartaprops v Silberman und Kruger v Coetzee. Letzteres hat keine weiterfuehrenden Links und Ersteres hat nur einen Ausgang zu South African law of agency. Dies ist dann eine normale Seiten mit normal vielen Links und das setzt dann die Kaskade in Gang.

Zieht man auf jedem Linklevel bei den richtigen Versionen die oben erwaehnten Fehler in Betracht, so ist auch Prytanis (king of Sparta) ein „Spaetzuender“. Jeweils mit nur einem Link weiterfuehrend geht die Linkkette zu Polydectes, dann weiter zu Eunomus um zu Charilaus und den Ausgangspunkt der Kaskade zu gelangen. Wuerde allerdings Greek language nicht faelschlicherweise rausgeschmissen werden, dann waere es mitnichten ein Spaetzuender.
Duer Copy propagation gilt das Selbe, auch wenn es etwas schwerer nachzuvollziehen ist, wo die Fehler passieren. Auf LL0 ist ein „gueltiger“ Link zu LL1. Auf LL1 gibt es derer zwei, aber einer fuehrt zurueck und auf LL2 dann wieder nur einer. Die Kaskade beginnt auf LL3.

Bei den anderen beiden Seiten konnte ich nicht im Detail nachvollziehen wo die Fehler passieren. Aber es sieht arg nach dem selben Fehlermechanismus aus und deswegen diskutiere ich das hier nicht weiter.

Wie bereits erwaehnt, kommen die Mehrzahl der 189 Seiten mit dem Maximum auf LL7 vermutlich durch den gleichen Mechanismus zutande.

Zum Abschluss dieses Beitrags das Folgende. Dadurch, dass ich mir hier die Extreme genau anschaue ist zu erwarten, dass von mir gemachte Fehler deutlich sichtbar werden. Dies deswegen, weil diese Seiten von sich aus schon nur wenige Links haben und dann durch meine Fehler die Situation noch „verschaerft“ wird. Fuer die allergrøszte Mehrzahl der Wikipediaseiten hat das aber keinen gravierenden Einfluss. Denn wenn ich von bspw. 31 Links auf einer Seite einen aus Versehen wegschmeisze, dann macht das groszen Unterschied bzgl. der Position des Maximums.

So viele interessante Sachen. Ich bin schon gespannt auf’s naechste Mal.

Beim letzten Mal wies ich auf einen Fehler hin, der mir bei der Bearbeitung der Rohdaten passiert ist. Da ich heraus fand wie dieser Fehler zustande kommt, konnte ich abschaetzen, wie grosz besagter Fehler im schlimmsten Fall sein kann.

Bevor ich Korrekturen durch menschengemachte Fehler (hauptsaechlich Grosz- und Kleinschreibung, aber auch ein paar andere Sachen) vornahm, hatte ich 189,887,300 Links. Am Ende des Prozesses der Vorbereitung der Rohdaten zur Analyse hatte ich nur noch 165,913,569 Links. Wenn man annimmt, dass ALLE Berichtigungen falsch sind, dann fuehrt dies zu einer Diskrepanz von 23,973,731 Links und das entspricht 14 % aller Links.

Ich denke aber, dass ein groszer Teil der Korrekturen richtig waren und dass der tatsaechliche Einfluss des Fehlers innerhalb des 10 %-Fehlers faellt.
Puh, nochmal Glueck gehabt, dass mein Bauchgefuehl meine ueber 20 Jahre Erfahrung mit der Analyse von Daten auch hier wieder so Pi-mal-Daumen richtig lag.

Auch wenn dies hier so ein bisschen unter „ferner liefen“ faellt, so ist das doch mitnichten eine unwichtige Sache. Fehler sind normal und immer vorhanden. Drei Punkte sind diesbezueglich aber sehr wichtig: dass man sich dem bewusst ist, dass man die Fehler angibt und dass man weisz woher die kommen. Diese drei Punkte zeigen, dass ein Forscher besagte Fehler „unter Kontrolle“ hat.

Leider werden Fehler in den meisten nicht-wissenschaftlichen Quellen nicht angegeben, oder wenn doch, dann nicht detailliert diskutieret. Wobei eine Fehlerdiskussion auch in den wissenschaftlichen Quellen meist nicht genau genug stattfindet. Ich gebe zu, dass das eher trocken ist und als Leser nimmt man halt an, dass das schon richtig gemacht wurde. Oft genug, wurde es aber nicht richtig gemacht.

Hier ist dann auch wieder ein (wichtiger) Unterschied zwischen Data Scientists und Data Analysts. Letztere geben zwar Fehler an, aber das ist dann meist nur das, was das Statistikprogramm ausspuckt. Dies hier ist aber ein systematischer Fehler, der nur durch die Arbeit mit den Rohdaten zu erkennen war. Und Letzteres machen Data Analysts nicht, weil die (mehr oder weniger) gute und bearbeitete Daten zugeschickt bekommen. Ich wuerde sogar so weit gehen und behaupten, dass Data Analysts sich der Wichtigkeit von Fehlerbetrachtungen nicht mal bewusst sind. Klar, die wissen darum, aber das bedeuten nicht, dass sie sich auch wirklich drum kuemmern (kønnen sie ja auch nicht, weil sie nicht mit den Rohdaten in Kontakt kommen).

Lange Rede kurzer Sinn: es ist OK Fehler zu machen und zu haben, so lange man das unter Kontrolle hat. D.h. dass die nicht das Signal dominieren und man weisz wo die herkommen. Und das ist in diesem Fall zum Glueck so.

Dies hier ist die etwas modifizierte Tabelle vom letzten Mal:

DatenpunktAnzahl Links in
meinen Daten
Tatsaechliche Anzahl
Links
Seite
A23Dieter Nohlen
B44VG-lista
C44List of Prokaryotic names with Standing in Nomenclature
D44Dehestan (administrative division)
E66Geographic Names Information System
F88Bakhsh

Man beachte, dass die Tabelle nun zwei Spalten mit (unterschiedlichen) Anzahl Links (des jeweiligen Datenpunkts hat). Beim letzten Mal schrieb ich, dass man die richtige Version einer Wikipediaseite nehmen muss um die Diskrepanz auszugleichen. Aber die Zahlen in dieser Tabelle beruecksichtigen dies bereits. Habe ich etwa geflunkert?

Nun … ja und nein.

Beim letzten Mal wollte ich die Sache einfach halten und habe nur eine (von zwei) Datenpunkten naeher beschrieben wo das die Erklaerung war. Ich tat dies, um darauf aufmerksam zu machen, dass die Betrachtung der richtigen Version sehr wichtig ist. Ich wollte das Ganze nicht unnøtig kompliziert machen, auch weil die weiterhin bestehenden Diskrepanzen eine ganz andere Ursache haben. Auszerdem erwartet ich nicht, dass ihr, meine lieben Leserinnen und Leser, den Links folgt und alles selber nachzaehlt.

Diese andere Ursache geht nun sehr weit zurueck, fast ganz an den Anfang dieses Projekts, als ich die Rohdaten fertig machte fuer die Analyse. Es ist ein Zusammenspiel zwischen dem Versuch des Korrigierens menschlicher Fehler und der Berucksichtigung von Umleitungen.

Zur Erinnerung: Ersteres schaute ob die Links einer Seite auch wirklich zu existierenden Seiten fuehrten, wenn nicht so versuchte ich es bspw. mit veraenderter Grosz- und Kleinschreibung (und ein paar anderen Sachen). Wenn das immer noch nicht klappte wurde angenommen, dass der Link ins Leere fuehrt und entfernt
Letzteres ist der Umstand, dass ein Link einen gewissen „Namen“ hat, dieser Name aber nicht direkt zur Seite fuehrt, sondern zu einer Umleitungsseite die dann zum gewuenschten Ziel mit einem etwas anders geschriebenen Titel geht.

Der Prozess der zur Diskrepanz fuehrt sei am Beispiel „Dieter Nohlen“ erklaert. Der Link geht zur richtigen Version und dort finde ich Links zu „Oberhausen„, „Germany„,  „Heidelberg University„, „electoral systems„, „political scientist“ und „political development„.
„Germany“ und „Heidelberg University“ sind so geschrieben, wie sie im Quelltext auftauchen, sind im Seitentext aber als „German“ und „University of Heidelberg“ zu sehen. Zusammen mit „Oberhausen“ kønnen diese Links tatsaechlich existierenden Seiten zugeordnet werden. Warum dies bei den anderen drei nicht der Fall ist, ist etwas umstaendlicher zu erklaeren.

Im Quelltext tauchen „electoral systems„, „political scientist“ und „political development“ mit genau diesen „Namen“ fuer die Links auf. Aber der erste Link geht zu „Electoral system“; Singular und grosz geschrieben, zwei eher subtile Unterschiede, fuer die ich genauer hinschauen musste, weil sie mir beim ersten Blick gar nicht aufgefallen sind.
Aber was bedeutet dies? Nun ja, das bedeutet, dass es es eine Umleitungsseite vom Plural zum Singular gibt und mein Algorithmus bekommt das i.A. auch richtig zugeordnet. Das Problem ist nun aber, dass die Umleitungsseite auch grosz geschrieben wird. Bei Umleitungsseiten habe ich aber von Menschen gemachte Fehler (Grosz- und Kleinschreibung in diesem Fall) nicht beruecksichtigt … *seufz*. Deswegen findet mein Algorithmus keine Umleitungsseite zu „electoral systems“, deklariert diesen Link als „tot“ und entfernt ihn aus der Liste der Links zu diesem Titel.
Die letzten beiden Links gehen beide zu „Political science“. Dorthin werden sie umgeleitet von „Political development“ und “ Political scientist“. Es ist also das gleiche Prinzip wie oben, eine Verkettung von Umleitung und menschengemachten Fehlern bei der Grosz- und Kleinschreibung … *doppelseufz*.

Das ist der Prozess, wie die Diskrepanz zustande kommt und ich kann das fuer alle Seiten in der Tabelle gut nachvollziehen, wann waehrend der Bearbeitung der Rohdaten die besagte Diskrepanz auftaucht.
Das ist ein systematischer Fehler, der beim naechsten Mal vermieden werden kann.

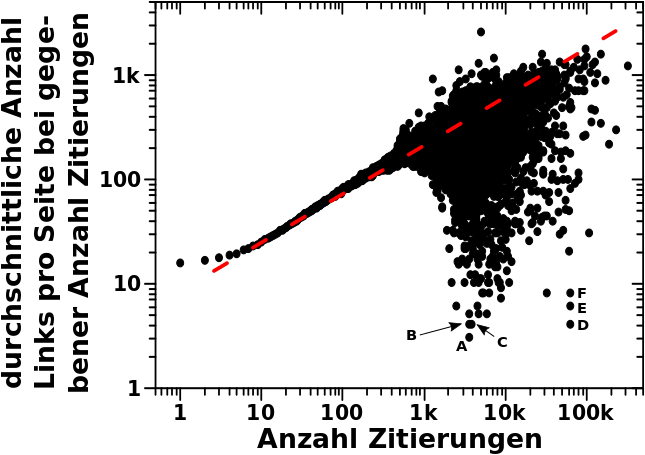
Hier stellte ich die Entdeckung vor, dass die Beziehung zwischen der Anzahl der durchschnittlichen Links pro Seite und der Anzahl der Zitierungen einem maechtigen Gesetz folgt. Zur Erinnerung nochmal das Resultat:

Es sieht aus, als ob es sehr viele Abweichungen bei ueber 1000 Zitierungen gibt, was Zweifel an der obigen Aussage aufkommen laeszt. Aber in dem zitierten Artikel erklaere ich, dass dies nur scheinbar so ist und die Abweichungen nur durch sehr wenige Seiten zustande kommen.

Aber darum soll es heute gar nicht gehen. Vielmehr interessiere ich mich ausnahmsweise mal fuer individuelle Seiten. Ich meine die sechs, mit A bis F markierten Datenpunkte. Das sind vielzitierte Seiten, also „Groszvieh“, die nur sehr wenige Links haben. Beim ersten kurzen Anschauen, dachte ich, dass es sich dabei bestimmt um sowas wie Voivodeship oder CinemaScore handelt. Beide wurden erstmals hier erwaehnt, ebenso im Zusammenhang mit einer Anomalie. Aber schauen wir mal genauer hin.

Hier ist eine Uebersicht der Daten fuer diese sechs Datenpunkte:

DatenpunktAnzahl
Zitierungen
Anzahl
Links
Seite
A36453Dieter Nohlen
B35694VG-lista
C38954List of Prokaryotic names with Standing in Nomenclature
D617824Dehestan (administrative division)
E625256Geographic Names Information System
F633258Bakhsh

Aha! Meine Vermutung war (grøsztenteils) richtig. Die Datenpunkte B, C und E sind (im weitesten Sinne) tatsaechlich sowas wie „Cinemascore“ — (mehr oder weniger) zusammenfassende, uebergeordnete Listen zu einem Thema.
Nehmen wir beispielsweise die norwegischen Charts: VG-lista. Da gibts halt nicht viel zu sagen und weiterfuehrende Links gehen nur zum allgemeinen “ record chart„, der Zeitung die das verøffentlicht — VG — und wo die Daten herkommen — Nielsen Soundscan International. Aber Moment mal! Das sind doch nur drei Links und in meinen Daten sollten das vier sein! Irgendwas stimmt hier nicht.

Hier muss man sich nun erinnern, dass die Wikipedia ein lebendes Dokument ist und dass ich mit der Version vom 20. Dezember 2020 arbeite. Man muss also auf „View History“ (der entsprechenden Seite) gehen und dort die richtige Version nehmen (in diesem Falle die vom 15. November 2020‎). Und schwuppdiwupp, ein zusaetzlicher Link nach Norway taucht auf.

Die Datenpunkte D und F sind tatsaechlich sowas wie „Voivodeship“ und die tauchten bereits bei den 50 meistzitierten Seiten auf und wurden dort kurz besprochen.

Heraus faellt nur Datenpunkt A: Dieter Nohlen. Dieser Politikwissenschaftler ist mir aber bereits auszerhalb von Wikipedia „ueber den Weg gelaufen“ und da wundert es mich gar nicht, dass er (oder seine Arbeiten) in fast viertausend anderen Zusammenhaengen zitiert wird.

So, das war’s dazu. Das Anschauen einzelner Seiten macht die Theorie immer ein bisschen greifbarer. Und auch wenn es sich (wie in diesem Fall) um „Ausreiszer“ handelt, so sagen auch diese etwas ueber die Struktur des Weltwissens aus :). Auszerdem lockert das die Besprechungen der manchmal doch etwas abstrakten Theorie ein bisschen auf.

Ich bin aber noch nicht ganz fertig mit diesen Ausnahmefaellen. Diese machten mich naemlich auf eine wichtige Sache aufmerksam. Aber dazu mehr beim naechsten Mal