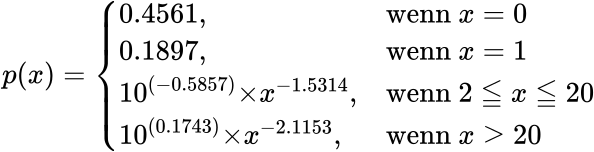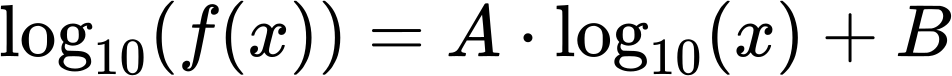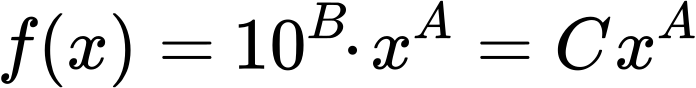Archive for the ‘Kevin Bacon’ Category

Obligatorischer Videoschnipsel.

Neben den in den letzten zwei Beitraegen diskutierten Aussteigern gibt es auch das entgegengesetzte Phaenomen: Seiten die nach dem Abbruch der Kette von Selbstzitierungen dann auf einem høheren Linklevel pløtzlich wieder neue Selbstreferenzen aufweisen.
Bevor ich naeher darauf eingehe, muss ich zunaechst zwei Sachen nochmals explizit sagen. Zum Einen, sind bei den Daten mit denen die Entwicklungsparameter bestimmt wurden weder Aussteiger noch reaktivierte Seiten dabei. Sobald fuer eine Seite die Kette von Selbstreferenzen abgebrochen ist, wurde besagte Seite nicht weiter beruecksichtigt bei den erwaehnten Daten.
Zum Anderen kønnen (so wie bei den Aussteigern) auch hier wieder Doppelzaehlungen auftreten. Eine Kette an Selbstreferenzen kann mehrfach abbrechen und reaktiviert werden. Aber wie bei den den Aussteigern denke ich nicht, dass diese all zu sehr ins Gewicht fallen.

Zunaechst ist zu sagen, dass es zahlenmaeszig erstaunlich viele Reaktivierungen gibt:
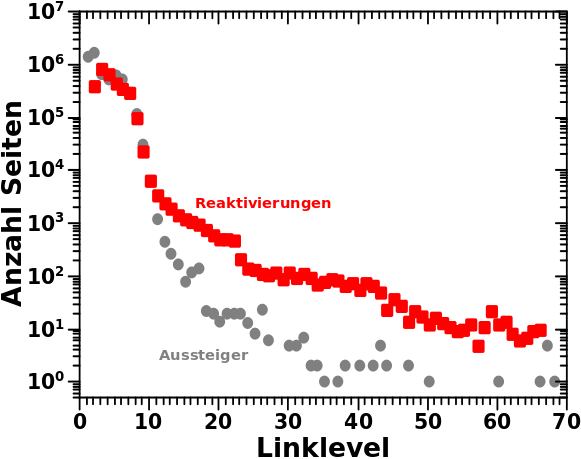
Ab LL11 dann sogar mehr als Aussteiger und bei spaeteren Linkleveln bis zu einer Grøszenordnung mehr. Aber die absoluten Zahlen sind dann schon nur noch im Bereich von hundert oder weniger Seiten.

Mhmm … was mache ich denn nun mit diesen Daten? Ist ja auch ein bisschen peinlich, denn die letzten Mal wollte ich zu viel simulierte Seiten los werden und nun sollen die wieder dazu kommen? … Mist … ich komme wohl nicht drumrum mir das mal genauer anzuschauen. Mir sind die vielen Verteilungen aber langsam ueber, weswegen ich das heute mal ‚wieder als  Heatmaps darstelle. Es gibt zwei Aspekte von Interesse: wie lang eine reaktivierte Kette wird und wieviele Seiten im Durchschnitt dazu kommen … pro Linklevel natuerlich.
Ich vermute aber, dass Reaktivierungen in der Mehrzahl „Blips“ sind, also wenn eine Seite eher aus „Versehen“ noch ein Mal (und nur ein Mal) zitiert wird. Diese Vermutung wird durch die Daten bestaetigt:
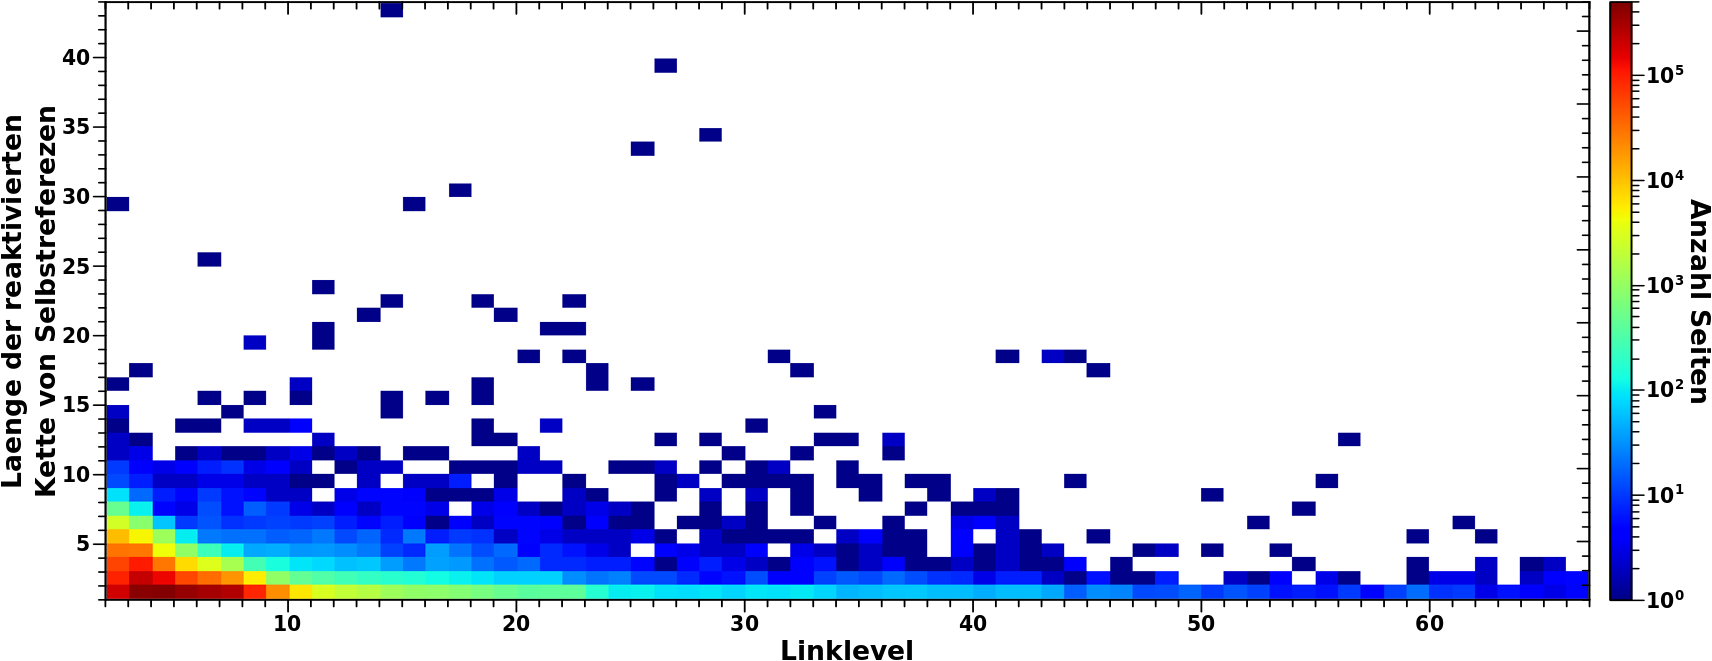
Zwei Dinge sind zu beachten. Zum Einen geht die Skala fuer das Linklevel erst bei 2 los. Auf LL1 kann nix reaktiviert werden, weil ja (von Artefakten abgesehen) keine Seite auf LL0 Selbstreferenzen haben kann. Das bedeutet, dass der frueheste Ausstieg auf LL1 und die frueheste Reaktivierung auf LL2 stattfinden kann.
Zum Anderen ist die Farbskala logarithmisch … also die Farbskala an sich ist natuerlich linear, aber praesentiert logarithmische Werte.

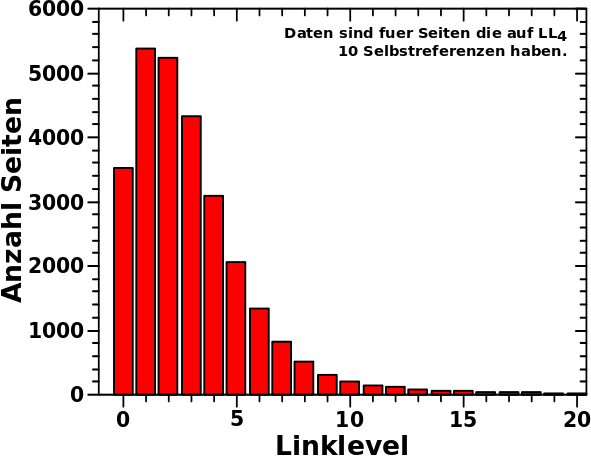
Wie man sieht, ist die Aussage mit den „Blips“ bereits hier zu 50 % bestaetigt. Dies aeuszert sich in dem roten Bereich in der linken unteren Ecke. Es werden zwar ganz viele Seiten reaktiviert (im Maximum fast 500-tausend) die Laenge der reaktivierten Kette ist aber nur eins.
Irgendwie war das zu erwarten. Auf LL2 bis so ca. LL5 sind die Seiten thematisch noch relativ nah und aufgrund der totalen Anzahl an zur Verfuegung stehenden Seiten kann dann doch nochmal die eine oder andere Selbstreferenz auftreten.

Dem schlieszt sich ein schmales gruenes Band an welches fuer Seiten mit „mittellangen“ Ketten steht. Hier kommt aber die Logarithmushaftigkeit der Farbskale ins Spiel, denn „gruen“ bedeutet, dass es sich dabei nur noch um hunderte, bis høchstens ein paar wenige tausende Seiten handelt. Auf das gruene Band folgt ein relativ breiter blauer Bereich an laengeren Ketten. Davon gibt es dann aber meist nur eine einzige Seite die derart reaktiviert wird.

Die Anzahl der durchschnittlichen Selbstreferenzen die dazu kamen hat mich etwas ueberrascht:
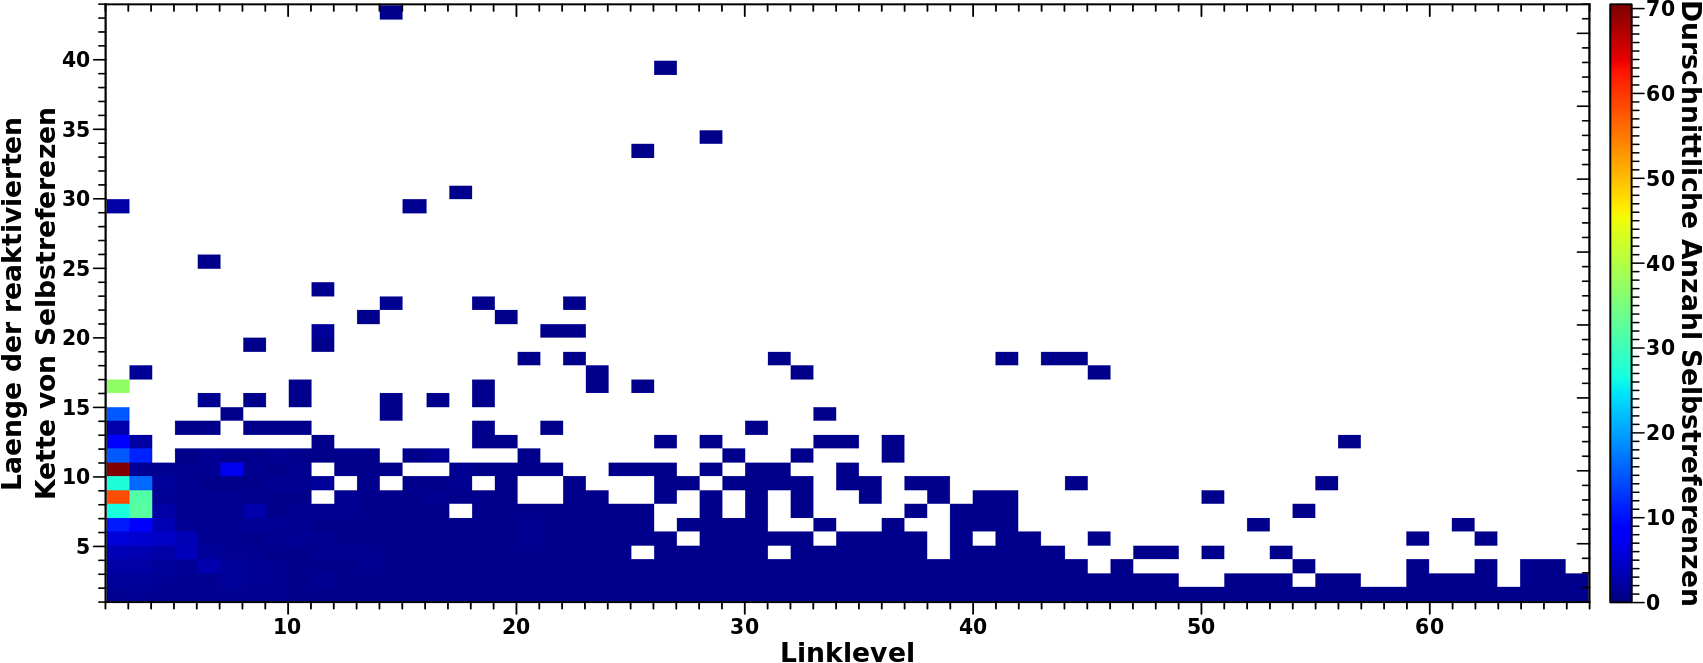
Der Durchschnitt berechnete sich auf die folgende Weise. Fuer jede Seite mit einer gegebenen (reaktivierten) Kettenlaenge sind alle in dieser Kette enthaltenen Selbstreferenzen aufsummiert worden. Am Ende wurde dieser Wert durch die Anzahl der relevanten Seiten und besagte Kettenlaenge dividiert. Das ist also zwei Mal „durchgeschnitten“.

Die Ueberraschung liegt nun darin, dass die durchschnittlich dazukommende Anzahl an Selbstreferenzen unabhaengig von der Kettenlaenge ungefaehr Eins betraegt. Mit Ausnahme der nicht-blauen Punkte am linken Rand; aber dazu komme ich gleich.
Eigentlich ist das nicht komplett ueberraschend. Fuer relativ kurze Ketten hatte ich das erwartet und das waeren dann die fehlenden 50 % fuer die Bestaetigung der Aussage mit den „Blips“. Also das ist gut.
Seiten die lange reaktivierte Ketten (also die separaten Punkte ueber dem „blauen Feld“) aufweisen, haette ich aber zunaechst erwartet, dass es sich dabei um wichtige Seiten handelt und die einen entsprechend (viel?) høheren Durchschnitt an Selbstreferenzen aufweisen.
Ein Beispiel waere der oberste Datenpunkt bei LL14. Diese Seite weist eine Kette auf die ueber 43 weitere Linklevel geht. Aber jedes Mal wird die Seite nur ein einziges Mal zitiert. Ich vermute, dass es sich hierbei auch wieder um eine Art von Artefakt handelt.

Wenn ich aber laenger drueber nachdenke, dann passt diese Ueberraschung nicht mit den „Blips“ zusammen. Warum sollte die Kette an Selbstreferenzen fuer eine wichtige Seite abbrechen und dann stark weitergehen? Da scheint es durchaus sinnvoller zu sein, dass ein paar wenige Seiten oftmals hintereinander „blipsen“. Rein statistisch gesehen wuerde ich das bei fast 6 Millionen Seiten durchaus fuer møglich halten.

Der nicht-blaue Streifen am linken Rand hingegen drueckt diese Vermutung dann doch aus. Aus der ersten Heatmap sehen wir, dass die nicht-blauen Punkte durch relativ wenige Seiten zustande kommen. Es ist durchaus leicht vorstellbar, dass spaeter (relativ) vielzitierte Seiten auf LL1 keine Selbstzitate haben. Einfach weil die Anzahl der dort „verfuegbaren Seiten“ welche die Ursprungsseite zitieren kønnen stark begrenzt ist. Und dann geht’s halt los mit der Kette auf LL2 oder LL3.
Der rote Punkt an sich kommt durch nur 10 Seiten zustande. Da braeuchte nur eine einzige mit vielen Selbstzitaten auf LL2 dabei sein und das wuerde einen hohen Durchschnittswert ergeben.
Ein anderes Beispiel sind die zwei gruenen Datenpunkte darueber. Die kommen jeweils durch nur eine Seite zustande auf die das Vermutete dann wohl zutrifft.
Der Rest des nicht-blauen Bereichs ist im Wesentlichen eine Variation dessen, dass hier relativ wenige Seiten zum Signal beitragen und deswegen schon eine Ausnahme den Durchschnitt stark verschieben kann.

Lange Rede kurzer Sinn: Reaktivierungen spielen an sich nur fuer kleine Werte von Selbstzitierungen ein Rolle. Das kann in der totalen Anzahl an Selbstreferenzen pro Linklevel durchaus einen signifikanten Beitrag zur Folge haben aber nicht in der Gesamtheit der Datenpunkte der einzelnen Verteilungen.
Das ist natuerlich gut, denn die ich versuchte ja eigentlich Seiten los zu werden, weil ich insgesamt zu viele simuliere. Andererseits kønnte es durchaus sein, dass bei mittelhohen Linklevel solche Reaktivierungen zum Signal im „Schwanz“ beitragen..

So, das soll genug sein fuer heute. Beim naechsten Mal schauen wir mal kurz auf die Ausreiszer und dann sollte es das endlich gewesen sein mit den Selbstreferenzen.

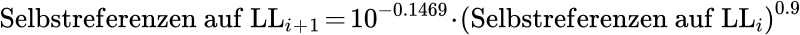
Zum Ende des letzten Beitrags zeigte ich (an drei Beispielen), fuer wieviele Seiten die Kette an Selbstreferenzen abbricht. Dies in Abhaengigkeit vom Linklevel und von der Anzahl der Selbstreferenzen. Ich erwaehnte auch, dass man diese Information nutzen kann um die Diskrepanzen zwischen Simulation und Messung (auf Seiten der Simulation) zu reduzieren (oder zumindest zu erklaeren).

Wie ebenso beim letzten Mal erwaehnt, so muesste man, um das ordentlich zu machen, den (mehr oder weniger) allgemeingueltigen Zusammenhang zwischen Anzahl der „Aussteiger“, Linklevel und Anzahl der Selbstreferenzen in Form einer Funktion ermitteln … was mir zu viel Arbeit ist. Da ich nur mal schauen will, wie gut diese einfache Korrektur funktioniert, werde ich hier einen hybriden Ansatz verfolgen, bei der ich Simulationsresultate und Beobachtungen „vermischen“ werde. Fuer eine richtige Simulation kann man das natuerlich nicht so machen.
Das Ganze werde ich auch nicht allgemein machen sondern an einem sehr konkreten Beispiel: die Diskrepanz zwischen Simulation und Messung auf LL7 fuer Seiten die auf LL7 10 Selbstreferenzen haben. Ihr meine lieben Leserinnen und Leser seid sicher schlau genug das verallgemeinernte Prinzip dahinter zu erkennen.

Zur Erinnerung nochmals der Vergleich zwischen Simulation und Messung (linkes Diagramm) und auszerdem die Anzahl der Aussteiger in Abhaengigkeit von der Anzahl der Selbstreferenzen fuer LL4 bis LL6.

Los geht’s mit der simplen Beobachtung, dass die simulierte Anzahl Seiten auf LL7 mit 10 Selbstreferenzen gleich 3428 ist waehrend der „gemessene“ Wert nur 967 betraegt. Das ist eine Diskrepanz von 2461.

Der simulierte Wert ergibt sich aus der simulierten Entwicklung des Systems, welche mit diesem maechtigen Gesetz beschrieben wurde:

Von hier aus muessen wir rueckwaerts rechnen um heraus zu finden, welche Seiten auf LL6 zu Seiten mit 10 Selbstreferenzen auf LL7 gefuehrt haben. Wenn man das tut erfaehrt man, dass auf LL6 Seiten mit 17, 18, 19 und 20 Selbstreferenzen anteilsmaeszig zu Seiten mit 10 Selbstreferenzen auf LL7 gefuehrt haben.
Wie bitte? Wie kønnen denn 4 verschiedenartige Seiten zu nur einem Wert fuehren? Die Antwort darin, dass die Anzahl an Selbstreferenzen nur ganzzahlig sein kann und erklaert warum das Wørt „anteilszmaeszig“ im obigen Satz wichtig ist. Ein Beispiel macht das Ganze etwas anschaulicher.

Eine Seite mit 17 Selbstreferenzen auf LL6 hat nach dieser Formel 9.129 Selbstreferenzen auf LL7. Kønnte man ja erstmal denken, dass das leicht auf 9 abzurunden ist. Aber wie beim letzten Mal explizit erwaehnt, wird mit der Entwicklungsgleichung nur der Durchschnitt der Selbstreferenzen auf dem naechsten Linklevel berechnet. Nun habe ich aber mehr als eine Seite mit 17 Selbstreferenzen auf LL6 und wenn ich das Ergebniss fuer alle auf 9 abrunde, dann stimmt das nicht mehr mit der Formel ueberein.
Deswegen habe ich mich entschieden, dass (fuer diesen Fall, was aber repraesentativ ist fuer den allgemeinen Fall) 12.9 % (also der Anteil nach dem Komma) aller Seiten mit 17 Selbstreferenzen auf LL6 zehn Selbstreferenzen (also eine mehr) auf LL7 haben wird. Damit stimmt der Durchschnitt wieder.
Von den Seiten mit 18, 19 bzw. 20 Selbstreferenzen auf LL6 tragen jeweils 61.0 %, 91.0 % bzw. 43 % zu Seiten mit zehn Selbstreferenzen auf LL7 bei.

Das war die erste Sache. Nun muessen wir im rechten Diagramm nachschauen, wie viel Seiten mit 17 (bzw. 18, 19 oder 20) Selbstreferenzen auf LL6 es in Echt niemals bis LL7 schaffen (die ich aber in der Simulation „mitschleife“). Das sind 130 (bzw. 100, 104 und 76) Seiten. Davon darf ich fuer den ganz konkreten Fall hier natuerlich nur den Anteil beruecksichtigen, der dem obigen Anteil entspricht. Das heiszt ich kann vom simulierten Wert von 3428 Selbstreferenzen nur 205 (= 17 + 61 + 94 + 33) Seiten abziehen.

Zwischenbemerkung: den Wert kann man einfach abziehen, denn die Anzahl der Aussteiger muss NICHT korrigiert werden bezueglich der Aussteiger auf frueheren Linkleveln. Das liegt daran, weil die „experimentellen“ Daten bzgl. der Aussteiger pro Linklevel natuerlich _nur_ anhand der „Ueberlebenden“ ermittelt wurden. In der Messung werden schlieszlich keine Seiten „mitgezogen“ die da nicht sein sollten.
Auch wenn es hier nichts ausmacht, so ist es wichtig solche Sachen zu diskutieren, denn da kann man u.U. schnell in eine „Falle“ tappen.

Das war aber nur der erste (Rueckwaerts)Schritt und muss fuer den Uebergang von LL6 zu LL5 und dann nochmal von LL5 zu LL4 wiederholt werden. Dabei erweitert sich der Bereich der beitragenden Seiten zunaechst auf alle Seiten mit 32 bis 42 Selbstreferenzen auf LL5 und dann noch mehr auf alle Seiten mit 67 bis 95 Selbstreferenzen auf LL4.
Die Summe der aussteigenden Seiten betraegt 199 auf LL5 und 82 auf LL4. Die letzte Zahl wird trotz des erweiterten Bereichs beitragender Seiten kleiner, weil die Anzahl der aussteigenden Seiten mit wachsender Anzahl an Selbstreferenzen so schnell abnimmt. Das ist auch der Grund, warum in (!) diesem Fall der Schritt zu LL3 (dem Ausgangszustand) nicht gemacht werden muss, denn das faellt nicht mehr signifikant ins Gewicht. Aber Vorsicht! Betrachtet man Seiten mit deutlich weniger als 10 Selbstreferenzen auf LL7 so gilt das im Allgemeinen nicht!
Summa summarum verringert sich durch diese Korrektur die Diskrepanz zwischen gemessenen und simulierten Werten auf 1975.

1975 hørt sich erstmal immer noch voll viel an, aber das entspricht ca. 20 % des unkorrigierten Wertes. Das ist aber eigentlich ziemlich gut, denn eine „Erklaerungskraft“ von 20 % mit einer solch einfachen Erklaerung ist im Allgemeinen nicht zu erwarten. Das miss inbesondere mit Hinblick auf die Einfachheit des Modells gesehen werden und dass wir wissen, dass die Entwicklungsparameter eigentlich NICHT konstant sind, dadurch ein groszer „Fehlerbeitrag“ von Anfang an zu erwarten ist.

Dies alles ist uebrigens warum ich beim letzten Mal schrieb:

[d]as waere sogar eine Korrektur mit „langfristiger“ Wirkung.

Aber was ist nun mit den restlichen 80 % Diskrepanz? Eine weitere relativ simple Korrektur ist der Grund warum ich (auch) beim letzten Mal sagte:

Der ziemlich grosze Unterschied […] zwischen Median und Mittelwert wird beim naechsten Beitrag nochmal wichtig.

Ich merke nun, dass ich damit stark uebertrieb, denn ich werde das hier nicht im Detail erlaeutern. Aber kurz gesagt wuerde ich vermuten, dass der Gebrauch des Medians anstelle des Mittelwerts zur Ermittlung der Entwicklungsparameter, zu (in der Summe) weniger Selbstreferenzen im jeweils naechsten Schritt fuehren wuerde. Eine solche Korrektur wird vermutlich einen weiteren nicht zu vernachlaessigenden Beitrag leisten. Mein Bauchgefuehl sagt mir so nochmal 20 %
Noch besser waere natuerlich, wenn man eine Verteilung um den Mittelwert (oder Median) nehmen wuerde. Beide Sachen sind leicht einzusehen, aber ich habe keine Lust mehr das alles nochmal zu machen.

Aber selbst damit wuerde ich nur ca. 50 % der Diskrepanz erklaeren kønnen. Der Rest ist halt so und liegt (wieder) an der Einfachheit des Modells und dass die Entwicklungsparameter in Wirklichkeit nicht konstant sind.

Puuh … genug fuer heute und im Wesentlichen genug zur Simulation an sich. Ich denke, dass die Selbige hinreichend erfolgreich war … hab ja auch genuegend Zeit damit verbracht.
Beim naechsten Mal werde ich die Simulation zwar nochmal kurz erwaehnen aber nur als Ueberleitung um mir mal anzuschauen wie es aussieht, wenn ausgestiegene Seiten nochmal „zurueck kommen“.

Bei der Simulation hat man gesehen, dass diese systematisch zu zu hohen Werte fuehrt. Zum Einen lag das daran, dass die Parameter besagter Entwicklung konstant gehalten wurden. Die Entwicklungsparameter wiederum entsprechen der Regressionsgeraden und diese ist im Wesentlichen der Mittelwert zu einer gegebenen Anzahl an Selbstreferenzen. Das ist nicht falsch und funktioniert, wie beim letzten Mal diskutiert, im Mittel gar nicht so schlecht. Aber dieser Mittelwert entsteht aus einem „Blob“ an Datenpunkten.
Oder anders an einem Beispiel: in der Simulation wird fuer jede Seite die auf LL4 zehn Selbstzitierungen hat berechnet, dass diese den Schritt zu LL5 macht und dort dann oben erwaehnten Mittelwert an Selbstzitierungen annimmt. Hier treffen also zwei Dinge zusammen: jede einzelne Seite macht zwingend (!) den Schritt zum naechsten Linklevel und jede Seite hat dort die gleiche Anzahl an Selbstzitaten.

In Wahrheit sieht die Verteilung der Selbstzitate auf LL5 fuer alle Seiten die auf LL4 zehn Selbstreferenzen hat aber so aus:

(Korrektur 2025-04-22: Die Abszisse muss „Anzahl Selbstreferenzen“ anstatt „Linklevel“ als Beschriftung haben!)

Das ist also eine Verteilung um den Mittelwert (aber keine Normalverteilung). Der (nicht aus den gewaehlten Entwicklungsparametern sondern hier genau berechnete) Mittelwert fuer 10 Selbstreferenzen auf LL4 fuehrt zu einem Wert von ca. 3 Selbstreferenzen auf LL5 und „ueberhøht“ somit das „mittlere Verhalten“ einer Seite. Letzteres deswegen weil, wie man am obigen Diagramm sieht, dass die Haelfte dieser Seiten zwei oder weniger Selbstreferenzen auf LL5 haben. Der ziemlich grosze Unterschied (hier 50 %!) zwischen Median und Mittelwert wird beim naechsten Beitrag nochmal wichtig.
Eigentllich muesste man diese Verteilung in die Simulation einbauen. Aber dafuer muesste man fuer jedes Linklevel und fuer jede Anzahl an Selbstreferenzen diese Verteilung ermitteln, analysieren und dann modellieren fuer die Simulation. Ersteres ist an sich gar nicht so schwer, denn das kann automatisiert werden. Zweiteres ginge prinzipiell auch noch. Die Betonung liegt auf „prinzipiell“, denn dabei handelt es sich sicherlich um Tausende von Verteilungen. Desweiteren nehme ich an, dass die aus der Analyse herausfallenden Parameter signifikant streuen. Womit man wieder in der gleichen Situation wie bei der Bestimmung der letztlich benutzten Entwicklungsparamter ist und dann mglw. doch wieder nur alles (unzureichend?) vereinfachen muesste. Deswegen spare ich mir das lieber gleich.

Eine andere Sache die bereits erwaehnt wurde ist aber viel einfacher zu korrigieren: Seiten deren Kette an Selbstreferenzen gebrochen ist, die also null Selbstreferenzen auf dem naechsten Linklevel haben, kønnen „rausfliegen“. Das waere sogar eine Korrektur mit „langfristiger“ Wirkung. Nicht nur tragen solche „ausgestiegenen“ Seiten faelschlicherweise zum Signal auf dem naechsten Linklevel bei, sondern auch bei den Linkleveln die danach kommen. Wie man am obigen Diagramm sieht, kann es sich mitunter um eine signifikante Menge an „Aussteigern“ handeln und deren Bezug auf eine sich erhøhende Diskrepanz zwischen gemessenen und simulierten Werten ist leicht einzusehen.

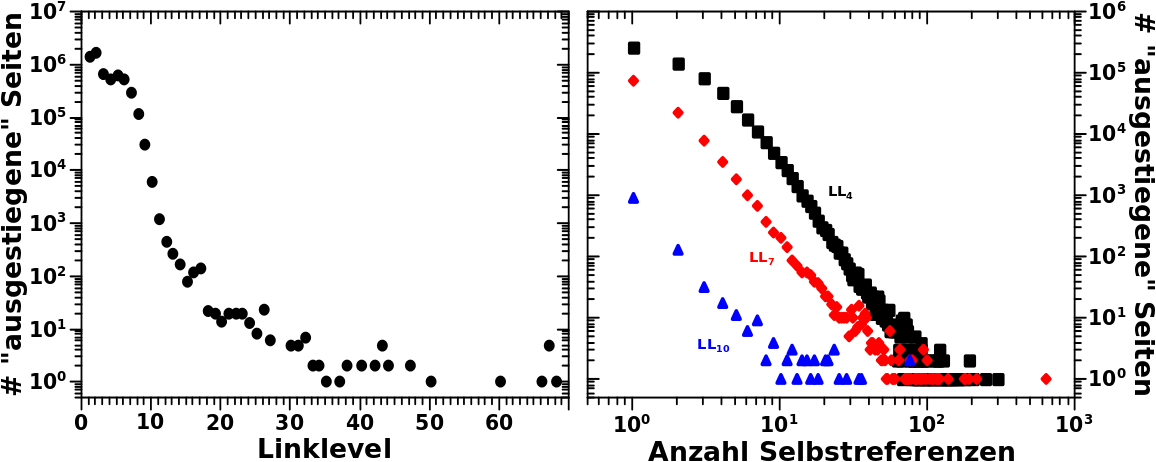
Deswegen habe ich hier im linken Diagramm mal aufgetragen, wie viele Seiten pro Linklevel aussteigen:

Das sind ja insbesondere auf den ersten Linkleveln ganz schøn viele! Selbst unter dem Aspekt, dass es mich bis LL3 nicht kuemmert, denn die bis dahin ausgestiegenen Seiten wurden in der Praeparierung des Ausgangszustands beruecksichtigt.
Nun ist aber die Anzahl der aussteigenden Seiten nicht nur vom Linklevel sondern auch von der Anzahl der Selbstreferenzen auf diesem Linklevel abhaengig. Dieser Sachverhalt ist an drei Beispielen im rechten Diagramm gezeigt. Wie zu erwarten war, steigen (deutlich) mehr Seiten mit wenigen Selbstreferenzen auf einem gegebenen Linklevel auf, als solche mit vielen Selbstreferenzen. Aber wenn man diese Information pro Linklevel hat, dann kann man sich an eine Korrektur machen.
Dazu komme ich aber erst beim naechsten Mal.

Ach so, eine letzte Sache noch. Bei diesen Grafen kann (und soll) Doppelzaehlung auftreten.
Ein Beispiel: Wenn fuer eine Seite die Kette von Selbstreferenzen auf LL3 abbricht, so steigt diese auf LL3 aus. Man nehme nun an, dass auf LL5 und LL6 (aber nicht danach) jeweils eine weitere Selbstreferenz auftritt. Dann hat man eine neue Kette, die auch wieder abbricht. Somit steigt diese Seite zwei Mal aus und wird entsprechend doppelt gezaehlt.
Aber ich nehme an, dass diese Mehrfachaussteiger insgesamt nicht sehr zahlreich sind und deshalb nicht all zu sehr ins Gewicht fallen werden. Der Grund liegt darin, dass man sich thematisch immer schneller von der Ursprungsseite entfernt und es sehr schnell unwahrscheindlich wird eine Selbstreferenz zu erhalten (und somit neue Ketten aufzubauen).
Mit einer Ausnahme: sehr fruehe Linklevel und wenn es sich nur im eine (reaktivierte) Selbstreferenz handelt. Aber diese sind bei der Korrektur der Simulation nicht all zu sehr von Interesse, denn zum Einen ist der Ausgangszustand fuer die Simulation erst bei LL3 und dass die Simulation ein Problem mit zu vielen einfachen Selbstreferenzen hat ist bekannt und an entsprechender Stelle bereits diskutiert worden.

Nachdem nun der Ausgangszustand praepariert ist und ich weisz wie die Entwicklung des Systems vonstatten geht, kann ich mir nun jede simulierte Seite aus Ersterem hernehmen und mit dem Wissen von Letzterem die Anzahl der Selbstreferenzen pro Linklevel berechnen. Daraus sollte mindestens qualitiativ dann wieder das herauskommen was auch gemessen wurde.

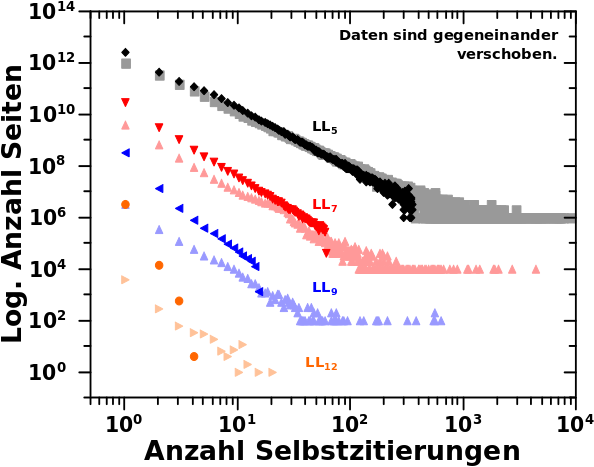
Zunaechst ein paar repraesentative Verteilungen der Selbstreferenzen, denn diese sind das direkte Resultat der Simulation:

Die Daten sind fuer jedes beispielhafte Linklevel farbkodiert, wobei die schwachfarbigen Punkte die Messungen sind und die starkfarbigen Punkte die Simulation.
Die Datenpunkte fuer jedes beispielhafte Linklevel sind gegeneinander verschoben damit man besser sieht was vor sich geht.

Man sieht, dass die Simulation zunaechst ganz gut passt. Hier beispielhaft an den Daten fuer LL5 gezeigt. Das ist nicht verwunderlich, wurden die Parameter der Entwicklung doch vor allem mit Hinblick auf die ersten paar Linklevel gewaehlt.
Ziemlich schnell kommt es aber zu Diskrepanzen, die mit fortlaufender Entwicklung grøszer werden. Letzteres macht sich dadurch bemerkbar, dass sich die simulierten Punkte immer weiter von den gemessenen Punkten entfernen. Auch dies ist nicht verwunderlich, denn die realen Entwicklungsparameter werden schnell kleiner, waehrend ich sie fuer diese Simulation konstant (und auf (relativ) hohen Werten) halte.

Desweiteren faellt auf, dass der „Schwanz“ der simulierten Verteilungen „abgeschnitten“ ist. Das kommt natuerlich weil ich schon im Ausgangszustand den Sehr-viele-Selbstzitierungen-Schwanz weglasse; da kann der nicht fuer høhere Linklevel pløtzlich auftreten.

Eine weitere Sache ist der Wert fuer die Anzahl der Seiten (pro Linklevel) die nur eine Selbstzitierung aufweisen. Dieser ist eigentlich fast immer zu hoch, bei spaeteren Schritten VIEL zu hoch. Das liegt zum Einen wieder daran, weil die Entwicklungsparameter konstant bleiben; da hat dann auch eine Seite mit nur einer Selbstzitierung auf dem naechsten Level in ueber 70 Prozent der Faelle wieder eine Selbstzitierung. Der zweite Grund haengt indirekt damit zusammen, denn ich erlaube keine „(mehr oder weniger) spontanen Aussteiger“. Also Seiten deren Kette von Selbstzitierungen abbricht (egal ob es nun 23 oder nur eine waren). Die gibt es in Wirklichkeit aber und die tragen dann natuerlich nicht weiter zum gemessenen Signal bei.

Zum Abschluss ist zu sagen, dass die simulieten Daten mehr oder weniger nur bis LL12 sinnvoll sind. Danach habe ich im wesentlich nur noch einen oder zwei Datenpunkte. Auch das ist nicht verwunderlich, folgt dies doch aus dem oben Gesagten und selbst bei den gemessenen Daten sind die dort noch vorhandenen Punkte wahrscheinlich alles eher Ausnahmen, als die Regel.

Trotz Allem ist es aber wichtig zu sehen, dass dieses sehr einfache Model qualitativ gar nicht so falsch ist. Zum Einen werden die Diskrepanzen zwischen simuliertem und gemessenem Singal nicht unendlich grosz. Eine Grøszenordnung (spaeter etwas mehr) ist zwar nicht zu unterschaetzen aber liegt innerhalb dessen was ich erwarten wuerde bei einem so einfach gehaltenen Modell.

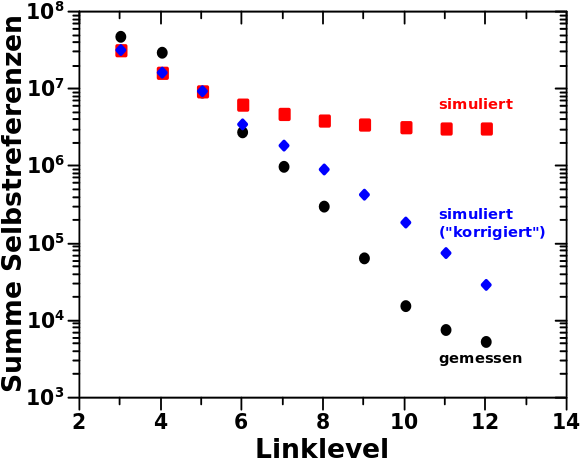
Schaut man sich nun die (vor mehreren Monaten zum ersten Mal vorgestellte) totale Anzahl an Selbstzitierungen per (relevantem) Linklevel an …

… dann sieht man beim Vergleich der schwarzen und roten Punkte, dass das auch hier Anfangs wieder ganz gut hinhaut und dann aber schnell eine grosze Diskrepanz und ganz anderes Verhalten (der Graf „biegt“ sich falsch) entsteht.
Nun erwaehnte ich aber weiter oben, dass ich zu viele Seiten mit einer Selbstreferenz habe. Wenn man diese ab LL6 (vorher zeichnet sich dieser Sachverhalt nicht als Problem ab) komplett weglasse, dann erhaelt man die blauen Punkte. Na aber Hallo! Das sieht doch viel besser aus. Die Luecke zwischen Simulation und Messung reduziert sich deutlich und nun zeigt auch die Simulation ein lineares Verhalten (bei doppellogarithmischer Darstellung). Die Luecke schlieszt sich nicht komplett und ein Unterschied von bis zu ca. einer Grøszenordnung bleibt erhalten. Letzteres war zu erwarten, wenn man das oben Besprochene bedenkt.
Alles in allem wuerde ich das aber als einen ziemlichen Erfolg der Simulation ansehen.

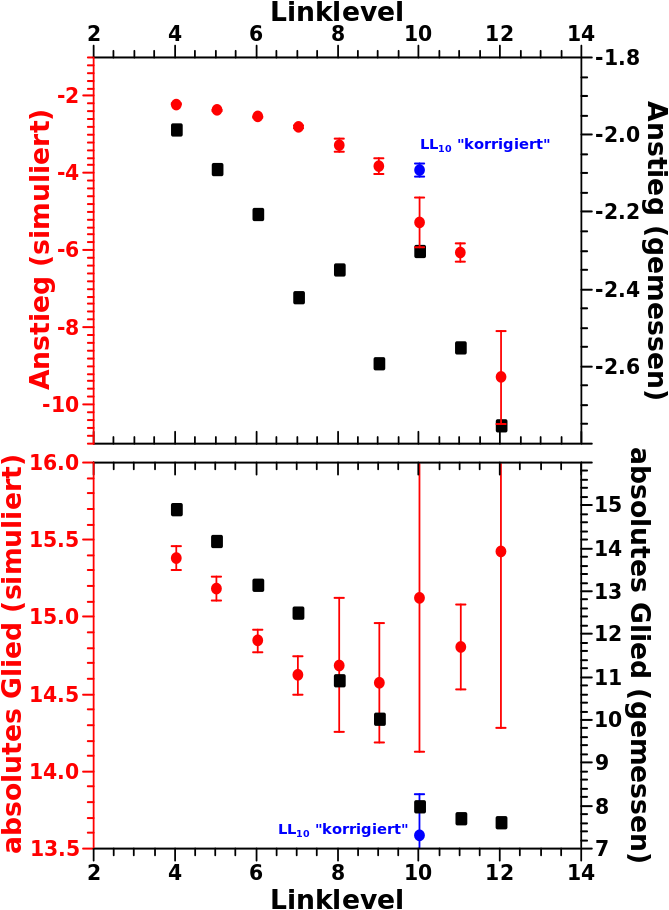
Ich kønnte an der Stelle aufhøren. Das waere aber unehrlich, denn eine weitere (ganz fantastische) Beobachtung waren die Regressionsparamter der individuellen Verteilungen der Selbstreferenzen pro Linklevel. Der Vergleich von Messung und Simulation dieser Grøszen sieht so aus:

ACHTUNG: man beachte die unterschiedlichen Skalen fuer simulierte bzw. gemessene Werte!

Man sieht, dass das generelle Verhalten qualitativ reproduziert wird; die Werte sowohl des Anstiegs als auch des absoluten Glieds nehmen ab. Hurra! Ein weiterer Erfolg fuer mein einfaches Modell.
Wenn man genauer hinschaut (deswegen der Hinweis mit den unterschiedlichen Skalen) sieht man, dass bis ungefaehr LL6 die Werte fuer diese beiden Grøszen noch ganz gut uebereinstimmen. Danach wird der simulierte Anstieg allerdings VIEL zu schnell steiler und das absolute Glied nimmt viel zu langsam ab.
Dies liegt zum Einen wieder an dem oben Gesagten. Zum Zweiten liegt es daran, dass ich bei der Bestimmung der Regressionsparamter der Simulation die Daten nicht fuer die Regression „optimiert“ habe (siehe mein Kommentar diesbezueglich im zitierten Beitrag). Fuer LL10 habe ich das mal gemacht; also „unpassende“ Punkte am Anfang und am Ende der Daten weggelassen. Das Ergebniss ist der blaue Punkt in den beiden Diagrammen und der bewegt sich nicht nur in die richtige Richtung, sondern ist auch signifikant anders als wenn man diese „Korrektur“ nicht vornimmt.

Letztlich ist zu sagen, dass das Modell die Daten qualitativ gut genug beschreibt. Quantitativ allerdings gibt es Diskrepanzen von bis zu einer Grøszenordnung. Wenn man bedenkt, dass das Modell sehr einfach gehalten ist, so ist das immer noch beeindruckend. Es zeigt aber auch, dass fuer eine bessere Beschreibung weitere Effekte zu beruecksichtigen sind. Das werde ich nicht machetun … mit einer Ausnahme: ich schau mir beim naechsten Mal an, wie das Abbrechen von Linkketten pro Linklevel aussieht (oben erwaehnte „Aussteiger“). Ich habe aber nicht vor das ins Modell einzuarbeiten, denn ich bin mit den Ergebnissen zufrieden genug und habe genug Zeit damit verbracht und ehrlich gesagt auch keine Lust mehr drauf.

Zur Erinnerung: hier zog ich als Analogon zu den Selbstreferenzen die Geschwindigkeitsverteilung von Gasteilchen in einer heiszen Box heran … und diskutierte dort inwieweit das zulaessig bzw. auch vøllig unzulaessig ist. Dieses Analogon werde ich auch heute benutzen.

Bei einer Simulation bzgl. der Entwicklung eines Systems braucht man zunaechst einen Anfangszustand. Der Anfangszustand bzgl. der Selbstreferenzen ist natuerlich LL0 … aber da gibt es keine Selbstreferenzen (von Artefakten abgesehen) und das entspricht einem klassischen (definitiv nicht quantenmechanischem!) Gas mit einer absoluten Temperatur von 0 K. Null Kelvin ist schwerlich als heisz zu bezeichnen … tihihi.

Wie sieht’s denn mit LL1 als Ausgangszustand aus? Das ist zwar besser, aber wir wissen, dass es sich bei der Verteilung auch um eine Ausnahme handelt, ist diese doch selbst mit Augen zudruecken nicht linear (bei doppellogarithmischer Darstellung). Im Analogon kønnte man sich vorstellen, dass bei LL1 die Heizplatte noch angestellt ist und definitiv noch kein Equilibrium im Gas erreicht wurde. Gleichgewicht mit dem „Aeuszeren“ sowieso nicht, denn das ist ja der Entwickluingsprozess (am Gasbild: das Abkuehlen) den ich simulieren will.

Dann also LL2 … jup … das geht gut genug linear, im Bild des heiszen Gases ist die Heizplatte also ausgeschaltet. Aber … mhmmmm … da ist ein kleiner Knick in der Kurve … ach dann beschreibe ich das abschnittsweise linear, eine Funktion fuer Werte zwischen 2 und 20 und eine andere fuer alles darueber … da kønnte man sich denken, dass die Heizplatte noch ein ganz klein bisschen Restwaerme hatte und der Knick durch die paar wenigen Gasteilchen zustande kommt die sich nochmal schnell „aufgewaermt“ (also Energie erhalten) haben und die daraus resultierende høhere Geschwindigkeit noch nicht durch Støsze mit den restlichen Teilchen abgegeben haben. Aber wie gesagt ist der Vergleich von Gasteilchengeschwindigkeiten und Selbstreferenzen physikalisch (und mathematisch) gesehen vølliger Quatsch. Aber ein Analogon dient ja zur Illustration eines weniger leicht fassbaren Sachverhalts mit einer bekannten Sache. Und all das hier schreibe ich um zu illustrieren, dass es auch in anderen Systemen Sachen gibt die nicht in das ideale Bild passen, man dafuer aber immer Gruende finden kann.

Wenn man das so mit den Regressionsgeraden macht, dann liegen mir die Werte fuer keine und eine Selbstreferenz(en) etwas weit abseits der ersten Geraden. Da nehme ich dann lieber die experimentell ermittelten Werte bzgl. dessen wie wahrscheinlich das ist, keine oder eine Selbstreferenz(en) zu haben. Zum Zweiten sind die Verteilungen auf LL2 und LL3 ja beinahe deckungsgleich. Deswegen wird LL3 fuer die Simulation der Entwicklung des Systems als Ausgangszustand angesehen.

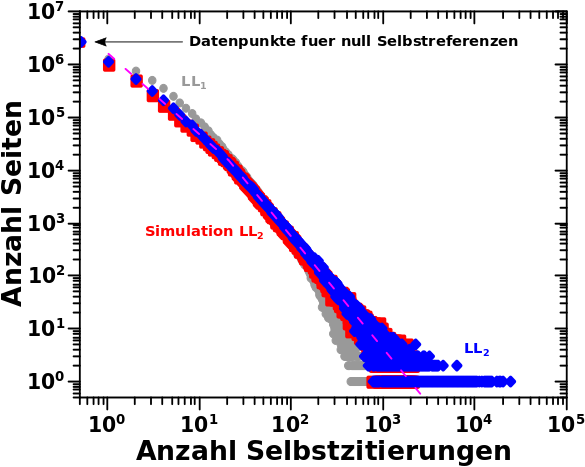
Wieauchimmer, wenn man das alles so macht und dann die Anzahl der Selbstreferenzen 6 Millionen mal simuliert (jedes „Gasteilchen“ muss separat simuliert werden),  dann ist der simulierte Ausgangszustand eine (fuer die hiesigen Zwecke) hinreichend gute Naeherung. Dies und (fast) alles was ich Oben schrieb ist in diesem Diagramm nochmals zu sehen:

Eine Sache faellt auf: der lange „Schwanz“ der blauen Verteilung wird nicht durch die (zweite oder erste) Regressionslinie beschrieben. Das kann man fixen, ich habe das aber der Einfachheit halber nicht gemacht. Deswegen der „Abbruch“ in den roten Punkten bei 3000 Selbstreferenzen … mal schauen, wie sich das im weiteren Verhaelt.

So, das war’s … … … aber ich møchte an dieser Stelle ein bisschen darauf eingehen, wie ich von der gemessenen Verteilung der Selbstreferenzen auf LL1 zur Simulation derselbigen komme (abgesehen von dem bereits Gesagten).

Zunaechst einemal gilt natuerlich, dass diese Verteilung eine Wahrscheinlichkeitsverteilung ist … wenn man diese durch die Anzahl aller Seiten dividiert. Beim IQ ist das mit einer Normalverteilung leichter vorstellbar (Letzteres gilt auch fuer die Maxwell-Boltzmann-Verteilung der Geschwindigkeit von Gasteilchen). Aber die zugrundeliegende Mathematik ist die gleiche: wenn ich zufaellig eine Seite (Teilchen) aus dem Ensemble heraus nehme, so hat diese(s) eine bestimmte Wahrscheinlichkeit eine bestimmte Menge an Selbstreferenzen (Geschwindigkeit) zu haben. Die mathematische Funktion p in Abhaengigkeit von der Anzahl der Selbstreferenzen x der hiesigen Wahrscheinlichkeitsverteilung sieht so aus:

Wie oben geschrieben: explizit definierte Wahrschienlichkeiten fuer keine und eine Selbstreferenz(en) und zwei (bei doppellogarithmischer Darstellung lineare) Funktionen darueber hinaus.

Soweit ist das noch ganz einfach. Nun kommt aber der Haken an der Sache. Fuer eine zu simulierende Seite muss ich die Anzahl der Selbstreferenzen, also das x (!), berechen, habe aber nur p(x). Letzteres ist im Einzelfall nur sinnvoll wenn man x schon hat, aber die Gesamtheit aller Einzelfaelle muss p(x) ergeben. Aber wenn ich die erste Seite simuliere dann weisz ich ja noch nicht, wieviele Selbstreferenzen alle anderen Seiten haben.
Ich gebe zu, dass ich beschaemend lange brauchte um auf die Løsung zu kommen, aber letztlich ist’s ganz einfach. Doch dafuer muss ich ein bisschen ausholen.

Wenn ich eine Seite simuliere (und ich mache das 6 Millionen mal), dann ziehe ich eine zufaellige Zahl zwischen Null und Eins. Die Abschnitte auf dieser Zahlengerade von Null bis Eins entsprechen dann der Summe der Wahrscheinlichkeiten bis zu einer gegebener Anzahl an Selbstreferenzen. Also 0 bis 0.4561 wird null Selbstreferenzen zugeordnet, 0.4561 bis 0.6458 (= 0.4561 + 0.1897) einer Selbstreferenz und danch muss das entsprechend berechnet werden und die Abschnitte werden sehr schnell sehr klein.
Mathematisch ausgedrueckt entspricht diese zufaellige Zahl dem bestimmten (!) Integral unter obiger Kurve von Null bis zu einer gegebenen Anzahl an Selbstreferenzen. Anders als sonst ueblich bin ich also nicht an dem Wert des Integrals interessiert (denn das ist der Wert aus der zufaelligen Ziehung und somit bekannt), sondern am oberen Limit.
Fuer null und eins kann man sich einfach den Zufallswert anschauen und das sofort rausbekommen. Fuer alle anderen muss das berechnet werden und dabei ist zu beachten dass das Integral dann natuerlich erst bei der richtigen unteren Grenze (also 1 oder 20) los geht (um die vorhergehende Bemerkung einzubeziehen).
Ist das schøn, dass wir es so oft mit maechtigen Gesetzen zu tun haben! *froi*. Da ist das Integral einfach zu berechnen und leicht nach x umzustellen und somit kann jedem gezogenen Zufallswert eine Selbstreferenz zugeordnet werden.

Dabei sind zwei Sachen zu beachten. Zum ersten muss der Zufallswert korrigiert werden. Der Grund liegt in dem was ich oben schrieb: dieser Wert ist die SUMME aller Wahrscheinlichkeiten (bis zu der dem Zufallswert zuzuordnenden Anzahl an Selbstreferenzen). Das (bestimmte) Integral geht aber erst bei den gegebenen Grenzen los, faengt also bei Null zu „zaehlen“ an. Das ist aber ganz einfach, denn vom besagten Zufallswert muss nur die Summe der Wahrscheinlichkeiten bis zu dem Wert ab der die jeweilige Funktion gueltig ist (also bis 1 bzw. bis 20) abgezogen werden.
Zum Zweiten kommen da natuerlich krumme Zahlen raus und die muessen auf die naechste ganze Zahl gerundet werden. Werte die kleiner als 1.5 sind werden zu eins abgerundet. Das ist aber doof, denn Seiten die nur eine Selbstreferenz haben sind ja durch die Fallunterscheidung alle schon erledigt. Der Einfachheit halber habe ich solche simulierten Seiten dann nur rausgeschmissen. Dadurch fehlen ca. eine halbe Million Seiten … das kann man sicherlich fixen, ich hatte aber keine Lust mehr und schmeisz das einfach in den beruehmten „ca.-10-Prozen-Fehler“.

Mit dem letzten und diesem Mal kommen da ein paar krasse Vereinfachungen zusammen. Beim naechsten Mal zeige ich, wie weit man damit dennoch kommt.

Weil zu viel abzuhandeln ist, knuepfe ich ohne viel Aufhebens direkt an das beim letzten Mal Besprochene an:

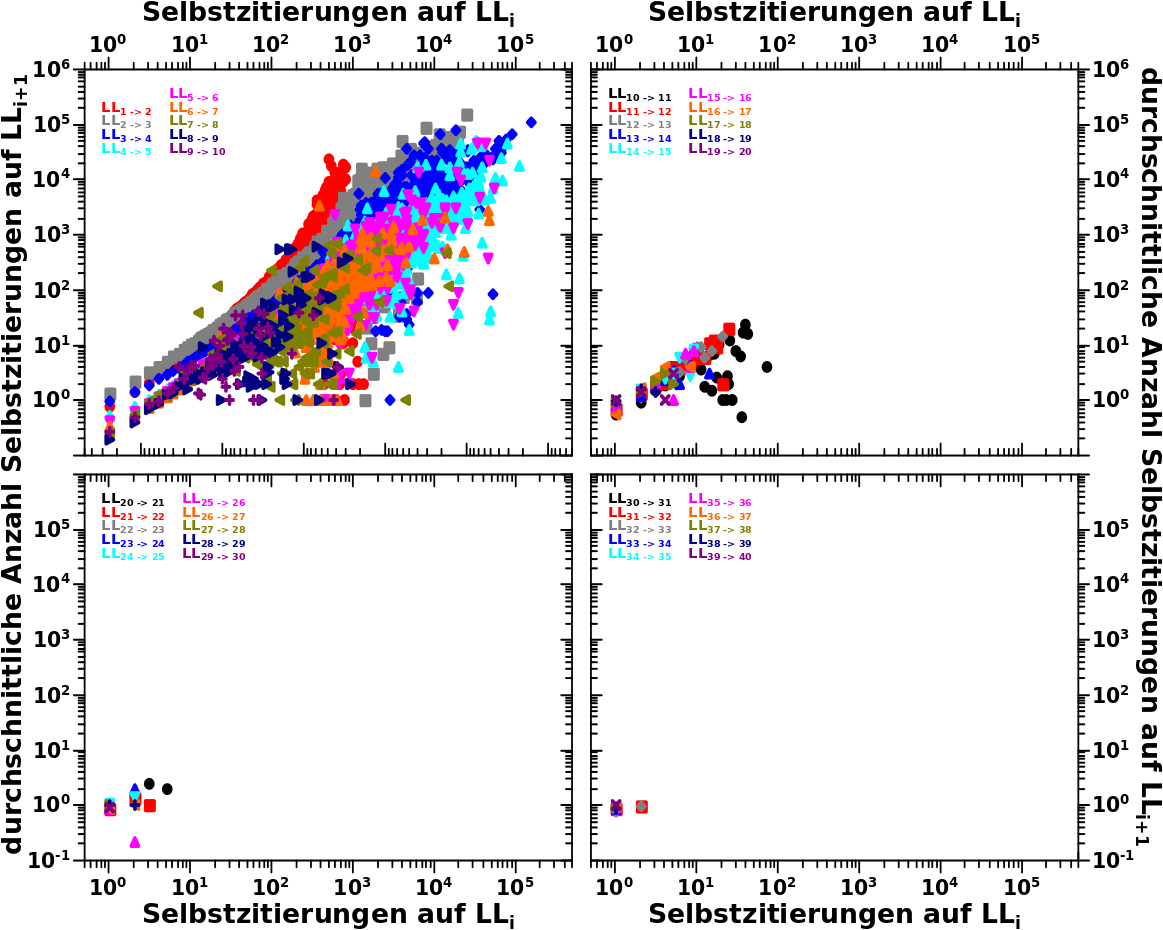
Pro Datensatz gilt das Folgende. Zunaechst wurde auf der Abzsisse abgetragen, wie viele Selbstreferenzen eine Seite auf einem gegebenen Linklevel i hat. Dann wurde fuer die selbe Seite geschaut, wieviele Selbstreferenzen diese auf dem naechsten Linklevel i + 1 hat. Dieser Wert wurde hier nicht abgetragen. Vielmehr bildete ich den Mittelwert der Selbstreferenzen auf Linklevel i + 1 fuer fuer _alle_ Seiten  die genausoviele Selbstrefenzen auf Linklevel i aufweisen wie die oben einzeln betrachtete Seite. Dieser Mittelwert ist auf der Ordinate abgetragen und ich diskutierte das beim letzten Mal genauer.

Dabei ist zu beachten, dass Seiten die auf einem Linklevel _keine_ Selbstreferenzen haben, NICHT weiter betrachtet wurden; ich behandle solche Seiten also als ob die bei diesem Linklevel „ausgestiegen“ sind. Dies gilt auch dann, wenn eine solche Seite auf einem høheren Linklevel wieder Selbstreferenzen aufweist. Eine eventuelle „Reaktivierung“ wird als irrelevant angenommen; empirisch ist das durchaus berechtigt, da es meist doch nur eine Selbstreferenz auf hohen Linkleveln gibt. Im Wesentlichen sieht man in diesem Diagrammen also nur Seiten, welche durchgehende „Ketten“ von Selbstreferenzen aufweisen.
In einem spaeteren Beitrag schau ich mir mal an, wie sich diese „Ausstiege“ und eventuelle „Reaktivierungen“ verhalten.

Damit hab ich gleich abgehandelt, warum im Wesentlichen ab LL22 nix mehr zu sehen ist (und so weit geh ich auch nur deswegen, damit das konsistent mit dem hier Gezeigten ist). Es gibt nur wenige Seiten, die so lange durchgehende Ketten von Selbstreferenzen aufweisen.
Dennoch ist zu sehen, dass der beim letzten Mal erkannte Zusammenhang bzgl. der Anzahl der Selbstreferenzen offensichtlich fuer mehr als nur einen Linklevelschritt gilt. Und abgesehen von LL1 zu LL2 (die roten Punkte im ersten Diagramm); scheint dieser bei doppellogarithmischer Darstellung linear zu sein (was auch bereits beim letzten Mal zu sehen war).

Desweiteren sieht es so aus, als ob die Anstiege dieser Kurven (auch wenn es diskrete Punkte sind nennt man das so … denke ich) immer ungefaehr gleich sind … mhmm … wenn ich hier Pi mal Daumen schaue, dann scheint es so zu sein, dass ich von einem Linklevel zum naechsten so ganz grob ungefaehr 50 mal weniger Selbstreferenzen habe … interessant … das muss ich mal genauer auswerten.

Damit die lineare Regression schick aussieht, entfernte ich hierfuer an den Enden Punkte, behielt aber alle anderen Ausreiszer drin. Diesmal geh ich einen anderen Weg und mache zunaechst eine lineare Regression um dann alle Punkte zu entfernen, die mehr als einen festgelegten maximalen Wert von der Regressionsgeraden entfernt liegen (in Richtung der Ordinate). Den Prozess wiederhole ich so lange, bis keine Punkte mehr entfernt werden muessen.

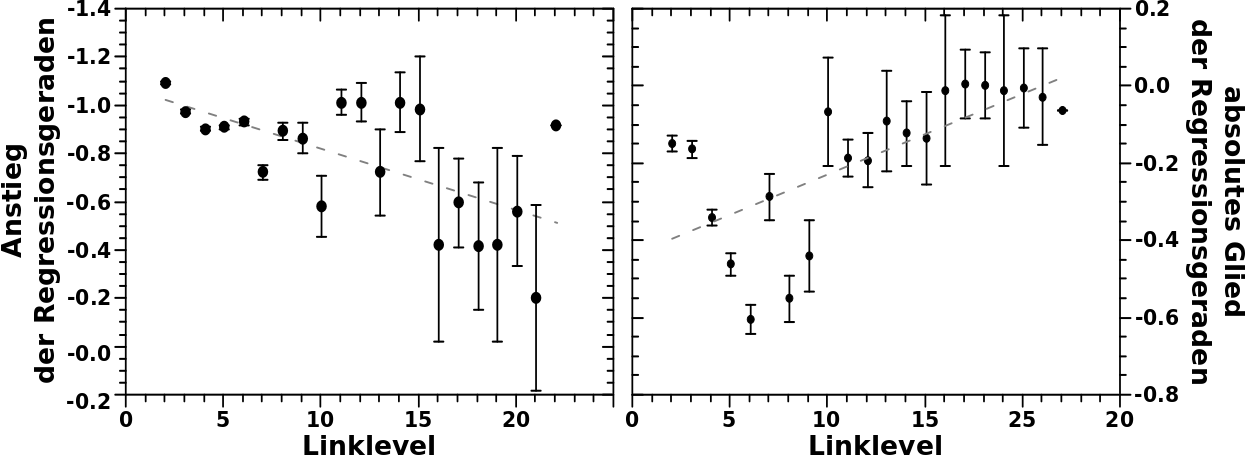
Das Ergebnisse bzgl. des Anstiegs und absoluten Glieds der Regressionsgeraden ist hier zu sehen (auszer fuer den Schritt von LL1 zu LL2) und …

… øhm … ich sag jetzt mal mehrdeutig.

Ich habe da zwar Regressionsgeraden rein gelegt, aber wichtige Punkte fallen mit dieser Geraden ueberhaupt nicht zusammen. Wichtige Punkte sind die bis ungefaehr LL6 / LL7, wo die Ausgangsdaten noch gut genug sind. Deswegen wuerde ich sagen, dass eine lineare Regression der Parameter der linearen Regressionen ueber die Datensaetze der obigen Diagramme die falsche Herangehensweise ist.
Nun kønnte ich da natuerlich eine Funktion durchpacken, welche diese Daten am Besten anpasst. Die Wahl einer Funktion sollte einen Zusammenhang mit einem plausiblen Mechanismus haben. Lineare, Potenz- und Exponentialfunktionen werden dafuer gern genommen. Dies weil sich so viel im Universum danach verhaelt und es meist durchaus plausibel ist erstmal anzunehmen, dass ein neues System sich auch danach verhaelt. Aber bei den Fehlerbalken kønnte ich irgendwas nehmen und das kønnte stimmen oder nicht.

Deswegen mache ich im Weiteren das, was man in solchen Faellen, wo man nicht weiter weisz, oft macht: ich versuche das (zukuenftige) Modell so einfach wie møglich zu halten. Das bedeutet dass ich einfach sage, dass sich alle obigen Kurven mittels linearer Gleichungen mit gleich bleibenden Regressionsparametern (gut genug) beschreiben lassen.
Den Anstieg setze ich dabei (nicht ganz so willkuerlich) fest auf 0.9. Dieser Wert ist im Wesentlichen nur aus den ersten sieben Punkten gewonnen (wo die Datenlage noch gut ist). Es ist ein Kompromiss der versucht einzubeziehen, dass der Anstieg zunaechst grøszer oder nahe eins ist, aber ja doch auch spaetere Daten erklaeren muss.
Fuer den Wert des absoluten Glieds habe ich den Mittelwert aller Punkte genommen (ca. -0.1469). Das fuehlt sich genauso richtig an wie irgend einen anderen Wert, beschreibt aber den Anfang wieder besser als andere Werte.

Somit weisz ich, wie sich das System von einem zum naechsten Linklevel entwickelt. Der Rest sollte nur vom Ausgangszustand abhaengig sein. Damit sollte ich beim naechsten Mal zur eigentlichen Simulation kommen kønnen und kann dann hoffentlich die erfolgreiche Berechnung der Verteilung der Selbstreferenzen pro Linklevel zeigen, wenn man nur die Verteilung dieser Grøsze im Anfangszustand kennt :)

Was ich die letzten Male schrieb ist eine Beschreibung eines Phaenomens (die Selbstreferenzen), wenn man das Gesamtsystem in verschiedenen Schritten der Entwicklung betrachtet. Dabei wird vøllig auszer Acht gelassen, _wie_ das System dahin gekommen ist. Wenn man Letzteres wuesste, dann muesste man nur einen Zustand (also bspw. LL1) messen und kønnte dann simulieren, wie sich das System zu den naechsten Schritten hin entwickelt.

Fuer ein Analogon aus der Physik nehme man an, dass ich eine Box mit einem heiszen Gas habe. Die individuellen Verteilungen der Selbstreferenzen pro Linklevel kønnten dann der Geschwindigkeitsverteilung der Gasteilchen zu unterschiedlichen Zeitpunkten waehrend des Abkuehlens entsprechen. Natuerlich nicht in Echt, denn das waere eine Maxwell-Boltzmann Verteilung; aber es geht mir ja nur darum, dass die Teilchen unterschiedliche Geschwindigkeiten haben, welche einer bekannten Verteilung folgen. Bisher habe ich die „Geschwindigkeitsverteilungen“ nur gemessen und ausgewertet. Es wuerde unheimlich viel Arbeit sparen, wenn man aber die „Geschwindigkeitsverteilung“ nur zu einem Zeitpunkt misst und dann berechnet wie diese zu einem spaeteren Zeitpunkt aussieht?

Diese Idee einer Simulation von gewissen Aspekten des Linknetzwerkes aus einem Ausgangszustand schwirrt schon eine ganze Weile in meinem Kopf herum. Bisher habe ich aber keinen Zugang dazu gefunden.
Bei den Selbstreferenzen ging mir nun aber das folgende Licht auf: wenn eine Seite viele Selbstreferenzen auf einem Linklevel hat, so ist das eine „populaere“ Seite und diese sollte auf dem naechsten Linklevel auch viele Selbstreferenzen haben. Klingt erstmal logisch, nicht wahr.
Diese Idee erweiterte ich auf alle Seiten (also auch die mit wenigen Selbstreferenzen) und dachte mir, dass es einen allgemeinen Zusammenhang zwischen den Selbstreferenzen von einem Linklevel zum naechsten geben kønnte. Und wenn man diesen Zusammenhang kennt, dann braeuchte man nur einen „Ausgangszustand messen“ und kønnte daraus alles berechnen.
Oder anders im Bilde des obigen Analogons (und hier kommt das „atomistische“ herein): wenn ich die Geschwindigkeit eines Teilchens kenne und weisz wie sich diese entwickelt, dann kann ich bei Kenntniss der Geschwindigkeit aller Teilchen im Ausgangszustand besagte Simulation durchfuehren und muesste nix weiter messen.

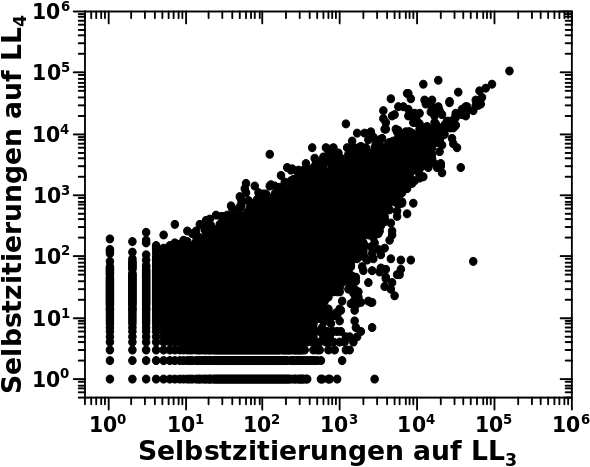
Um das durchfuehren zu kønnen, muss ich aber zunaechst ein ganzes Stueckchen Vorarbeit leisten. Der erste Punkt auf der Agenda ist herauszufinden, ob es eine Abhaengigkeit der Selbstreferenzen auf einem Linklevel vom vorhergehenden Linklevel gibt. Wenn man sich die Daten diesbezueglich anschaut, dann sieht das (am Beispiel des Schrittes von LL3 zu LL4) so aus:

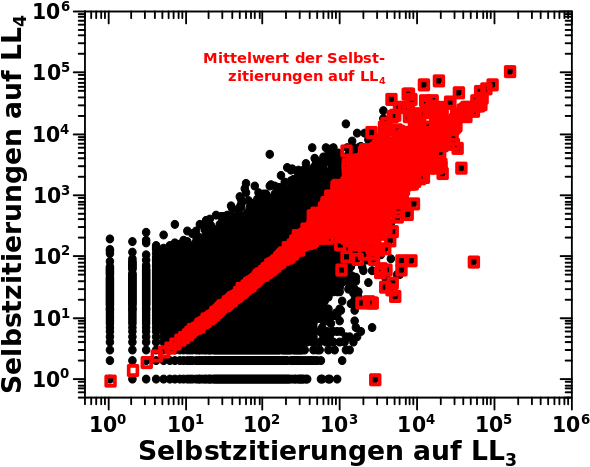
Aha! Na das sieht doch tatsaechlich so aus, als ob es hier (wie oben vermutet) eine Tendenz gibt. Ist nur doof, das es in dem schwarzen Blob eine Variation ueber zum Teil vier Grøszenordnungen gibt … aber Moment mal … einen schwarze Blob gab’s doch schon mal … und Mittelwertbildung offenbarte eine ganz wunderbaren Information, welche sich in dem Blob versteckte. Na dann:

AHA! Der Eindruck, dass es da einen Zusammenhang gibt taeuschte nicht und zum jetzigen Zeitpunkt ist es auch nicht mehr ueberraschend, dass dieser linear ist (bei doppellogarithmischer Darstellung).

Wie schon damals liegen die Mittelwerte ziemlich eindeutig auf einer Linie fuer (relativ) kleine Werte auf der Abszisse (hier bis ca. 400 Selbstreferenzen). Dies liegt natuerlich darin, weil ich aus vielen Datenpunkten (die bspw. alle 23 Selbstreferenzen haben), jeweils nur einen Mittelwert „mache“.
Fuer høhere Werte und hingegen streut das alles zum Teil betraechtlich. Der Grund liegt darin, dass ich da dann nur wenige Datenpunkte habe; bei ganz hohen Abzsissenwerten oft nur einen Einzigen (wenn im Diagramm die roten „Mittelwertquadrate“ genau ueber einem schwarzen „Rohdatenkreis“ liegen). Das wiederum kann den Mittelwert ganz massiv beeintraechtigen und zu den zu beobachtenden starken Schwankungen fuehren. Wichtig ist aber, dass die Punkte dennoch (im Mittel) weiterhin dem linearen Zusammenhang zu folgen scheinen.

Das soll reichen genug sein fuer heute. Beim naechsten Mal all dies fuer alle Linklevel (fuer die es sich lohnt das mal auszuwerten)

Beim letzten Mal zeigte ich, dass sich die linklevelabhaengigen, individuellen Verteilungen der Selbstreferenzen bei doppellogarithmischer Darstellung mittels linearer Funktionen beschreiben lassen und dass der Anstieg der dazugehørenden (Regressions)Geraden zu nimmt. Nun wird es total spannend, denn ich werte heute die linklevelabhaengigen Parameter dieser linearen Funktionen aus.

Aber zunaechst zur Erinnerung: in den Diagrammen des letzten Beitrags stellte ich den Logarithmus eines Funktionswertes f(x) in Abhaengigkeit vom Logarithmus der Argumente x dar und erhalte eine Gerade. Die Formel fuer die Gerade sieht also so aus …

… mit dem Anstieg A und dem absoluten Glied B. Letzteres ist im Wesentlichen dafuer verantwortlich, wie grosz das Integral unter der Kurve wird, da dieser Parameter besagte Kurve nach oben oder unten schiebt.
Obige Gleichung ist aequivalent zu einem maechtigen Gesetz …

… und deswegen entspricht der Anstieg der Geraden in der doppellogarithmischen Darstellung dem Exponenten des Potenzgesetzes. Cool wa!

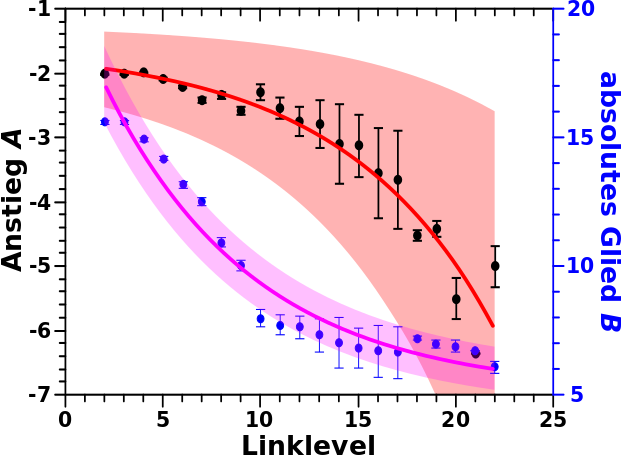
Soweit zur Wiederholung … nun schauen wir uns mal die Linklevelabhaengigkeit der Regressionsparameter in diesem høchst spannenden Diagramm an:

URST Cool wa! Jetzt hab ich schon zwei voll krasse Ergebnisse (hier ist das Erste) die ich so nicht erwartet haette. Krass deswegen, weil das hier auf zugrundeliegende Mechanismen hinweist, die ganz natuerlich in diesem Netzwerk entstanden sind. Aber genug der Schwaermerei darob solch schøner Resultate ich sollte erstmal sagen warum das so urst cool ist.

Sowohl die Linklevelabhaengigkeit des Ansteigs als auch des absoluten Glieds lassen sich am besten mittels einer Exponentialfunktion beschreiben. Diese hat im ersten Fall eine Zerfallskonstante von -7.76 und im zweiten Fall von +7.67 … … … Wait! What? … *nochmal kontrollier* … .oO(ja, das stimmt alles).

Die Wahl einer Exponentialfunktion zur Beschreibung der Daten kann natuerlich diskutiert werden. Aber weil ich nicht die geringste Ahnung habe, was oben erwaehnte Mechanismen sein kønnten, gehe ich erstmal von einfachen Dingen aus, was in diesem Fall zur Wahl einer Exponentialfunktion fuehrte.
Das sich das Vorzeichen zwischen den beiden Werte aendert liegt in der Natur der Sache. Der absolute Wert des Anstiegs der Geraden wird ja grøszer. Deswegen muss die Zerfallskonstante negativ sein, denn der Exponent eines exponentiellen Zerfalls enthaelt von sich aus ein Minus eins und das muss kompensiert werden. Das aendert nix an dem Gesagten. Wuerde man die Daten des einen Parameters an der Abzsisse spiegeln, waere das Vorzeichen beider Exponenten gleich.

Beide Zerfallskonstanten liegen (vom Vorzeichen abgesehen) total nah beieinander. Das weist darauf hin, dass die Linklevelabhaengigkeit beider Grøszen ein und dem selben Mechanismus zu Grunde liegen.

Es hatte einen Grund, warum ich beim letzten Mal dies schrieb:

[…] wenn die Werte der Datenpunkte der Grafen durch die Anzahl aller Wikipediaseiten geteilt wird, so erhaelt man die Wahrscheinlichkeit wie oft eine Seite so und so viele Zitate […] pro Linklevel erhaelt.
Das Integral ueber alle Daten und alle Linklevel ergibt […] die durchschnittliche Wahrscheinlichkeit ueberhaupt eine Selbstreferenz zu erhalten.

Wenn man in diesem Bild bleibt, so ist das absolute Glied obiger linearer Gleichung ein Ausdruck dessen was in dem zweiten Satz des Zitats steht. Je weiter fortgeschritten man im Linknetzwerk einer Seite ist, desto unwahrscheinlicher ist es eine Selbstreferenz zu erhalten … siehe der kleiner werdende Flaecheninhalt unter den beim letzten Mal gezeigten Grafen.
Ist es sinnvoll, dass diese Grøsze exponentiell abnimmt … mhmm … mein Bauchgefuehl sagt mir: durchaus.

Die Zunahme des (Betrags des) Anstiegs der Regressionsgeraden besagter Grafen sagt im Wesentlichen das Folgende aus: je weiter fortgeschritten man im Linknetzwerk einer Seite ist, desto unwahrscheinlicher ist es _mehr_ als eine Selbstreferenz zu erhalten.
Ist es sinnvoll, dass diese Grøsze exponentiell abnimmt … mhmm … mein Bauchgefuehl sagt mir auch hierbei: durchaus.

In beiden Faellen kommt das „durchaus“ meines Bauchgefuehls daher, dass høhere Linklevel bedeuten, dass sich die dort auftretenden Seiten thematisch mehr und mehr von der Ursprungsseite entfernen. Warum sollte Selbige also zitiert werden? Und diese Entfernung vom Ursprungsthema ist eben wirklich urst schnell … da kann ich auf den allererste Beitrag dieser Maxiserie verweisen, in dem ich erwaehne, dass es nur drei Schritte zwischen Trondheim und Kevin Bacon gibt … ich wuesste wirklich nicht, was diese beiden miteinander zu tun haben kønnten.
Wieauchimmer, dieser „Abstand“ nimmt im Bild des Linklevels zwar schrittweise (also linear) zu, aber der „thematische (!) Abstand“ dann wohl exponentiell. Das „urst schnell“ von weiter oben drueckt sich in dem hohen absoluten Wert der Zerfallskonstante aus … ein Exponent von (fast) 8 ist gigantisch! Mir ist kein einziges Naturgesetz mit einem so hohen Exponenten bekannt.

Eine weitere „Veranschaulichung“ des Gesagten sind die vielen Gespraeche, wo man „vom Hundertsten ins Tausendste kommt“ … weil es sich hierbei um einen Sprung um eine Grøszenordnung handelt, kann dieses Sprichwort durchaus als ein Ausdurck obiger Zustaende gesehen werden.
Somit entspricht die Zerfallskonstante dieser Parameter also in etwa wie stark sich die Themen der Seiten auf einem Linklevel vom Thema der Ursprungsseite entfernen. Das ist voll cool (!!!) denn damit gibt es einen mathematischen Ausdruck fuer ein sprachlich / psychologisch / soziales Phaenomen. Ich haette nicht gedacht, dass ich das ganz konkret und quantifizierbar in den Daten finden wuerde.

Das soll genug sein fuer heute. Zum Abschluss sei nur noch das Folgende erwaehnt: die Fehlerbalken der einzelnen Punkte kommen aus den Fehlern der Regressionsparameter (wie beim vorletzten Mal erwaehnt). Der Fehlerbereich der exponentiellen Funktion ist davon natuerlich unabhaengig.

Nachtrag:
Im obigen Bild ist mir ein Fehler unterlaufen. Das ist aber nicht so schlimm und aendert gar nichts an dem was ich schrieb und es handelt sich dabei um das Folgende. In der Formel am Anfang benutze ich den Logarithmus zur Basis 10. Dies deswegen, weil Diagramme wie beim letzten Mal logarithmische Skalen zur Basis 10 benutzen. Die Werte fuer das hier dargestellte Diagramm berechnete ich aber mit dem natuerlichen Logarithmus.
Fuer den Anstieg macht das ueberhaupt keinen Unterschied, der ist der Selbe, egal welche Basis man benutzt. Aber das absolute Glied ist bei Letzterem selbstverstaendlich grøszer als wenn die Basis 10 benutzt werden wuerde. Genaugenommen um einen (konstanten!) Faktor 2.30258 grøszer, welcher natuerlich das Reziproke des Logarithmus zur Basis 10 der Eulerschen Zahl ist. Mathematisch folgt das zwangslaeufig, denn letztlich muessen beide Formen die selben Daten beschreiben. Zur Kontrolle habe ich dennoch nochmals alle linearen Regressionen ausgefuehrt und kann sagen, dass dieser Faktor „experimentell“ bestaetigt wird … bis auf ein paar wenige Werte am Anfang und am Ende fuer die das aber plusminus innerhalb vertretbarer Grenzen auch gilt.
Weil es sich hierbei um einen konstanten Faktor handelt bleibt dann auch die Zerfallskonstante der Anpassung der Werte fuer B die Gleiche. Mit den gegebenen Datenpunkte erhalte ich einen Wert fuer Selbige von +7.22. Die Diskrepanz ergibt sich sich durch die „paar wenige[n] Werte am Anfang und am Ende“. Wenn ich diese kuenstlich „begradige“ so verschwindet die Diskrepanz ohne dass sich an der Position der Punkte im Diagramm grosz was aendert.
Mit den gegebenen Daten (und insb. aller Limitierungen die diese mit sich bringen) kann ich deswegen trotz des (relativ geringen) Unterschieds der Werte (welchen ich getrost in den so oft erwaehnten „10%-Fehler“ packen kann) weiterhin ohne schlechtes Gewissen vertreten, dass die Zerfallskonstanten fuer A und B im Wesentlichen gleich sind.

Nach dem letzten Beitrag kann ich heute ohne viel Aufhebens gleich zu den Daten kommen:

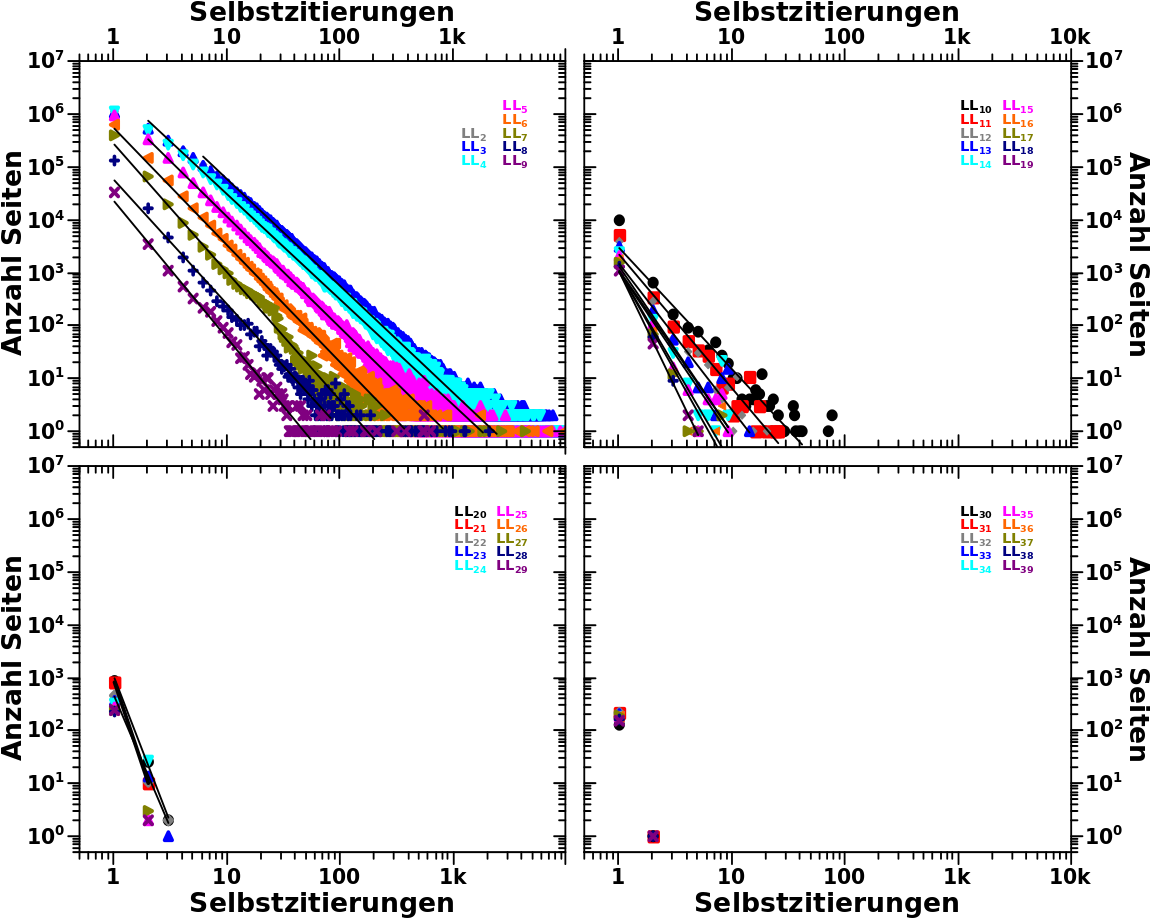
Whoa! … (wie so oft) passiert ja ganz schøn viel hier … darum der Reihe nach. Wir sehen die selben Diagramme wie beim letzten Mal, nur fuer høhere Linklevel, mit den Regressionsgeraden welche den linearen Teil der jeweiligen, linklevelspezifischen Daten gut (genug) beschreiben.

Im linken, oberen Bild sehen wir die Daten fuer LL2 bis LL9 (kurze Anmerkung: die Daten fuer LL2 und LL3 sind sich so aehnlich, dass sich Erstere hinter Letzteren „verstecken“; entsprechend sind diese zwei Regressionsgeraden auch so aehnlich, dass ich hier sage, dass diese gleich sind). Wie beim letzten Mal bereits erwaehnt, nimmt die „Signalstaerke“  mit zunehmendem Linklevel ab. Das ist aber etwas, was wir schon aus dem allerersten Diagramm zu den Selbstreferenzen wissen.
Nichtsdestotrotz scheinen die Regressionsgeraden hier alle parallel zu liegen. Die Betonung liegt auf „scheinen“, denn dies ist nicht der Fall. Das sieht man aber in diesem Diagramm nicht so gut, weil der Unterschied in den Anstiegen nicht sehr grosz ist.

Besser ist dies im rechten oberen Bild zu sehen, in dem die Daten von LL10 bis LL19 dargestellt sind. Weil die Datenpunkte dichter beisammen liegen erkennt man viel besser, dass Betrag des Anstiegs der Regressionsgeraden zu nimmt mit høheren Linkleveln.

Im linken unteren Bild sieht man den Uebergang in das Regime in dem die Datenlage nicht mehr gut genug ist. Bis LL22 getraue ich mich noch die Daten mittels linearer Regressions zu analysieren. Danach ginge das prinzipiell auch noch, aber da habe ich dann allermeistens nur noch zwei Datenpunkte (oder noch spaeter nur noch einen) pro Linklevel und durch zwei Punkte kann man eine eindeutige Gerade legen. Die Parameter dieser Gerade sind dann aber auch komplett abhaengig von der Position besagter Punkte im Diagramm. Da ich mich hier ohnehin nur noch kurz ueber dem „Rauschen“ befinde wuerden besagte Parameter dann auch (mehr oder weniger) wild streuen und es waere wenig sinnvoll diese zu interpretieren. Eben dieses „wilde streuen“ wird ja zum Teil massiv „geglaettet“ durch lineare Regression.

Wieauchimmer, im rechten unteren Bild ist dann definitiv der „Endzustand“ erreicht, der das eben Beschriebene eindeutig klar macht.

Ich zeige die Diagramme vor allem aus Transparenzgruenden damit ihr, meine lieben Leserinnen und Leser, sieht wie das „in Echt“ aussieht und wo die beim naechsten Mal besprochenen Sachen eigtl. herkommen.

Zum Abschluss sei das Folgende gesagt (denn es ist wichtig zum Verstaendnis der Daten beim naechsten Mal): wenn die Werte der Datenpunkte der Grafen durch die Anzahl aller Wikipediaseiten geteilt wird, so erhaelt man die Wahrscheinlichkeit wie oft eine Seite so und so viele Zitate (z.b. 23) pro Linklevel erhaelt.
Das Integral ueber alle derart normierten Daten und alle Linklevel ergibt die rechte Kurve des ganz am Anfang der Besprechung der Selbstreferenzen gezeigten Bildes — die durchschnittliche Wahrscheinlichkeit ueberhaupt eine Selbstreferenz zu erhalten.

Beim naechsten Mal komme ich zum eigentlich Spannenden: der nun schon so oft erwaehnten Regressionsgeraden. Urspruenglich war das hier mit drin, aber die Ergebnisse sind so toll, dass diese einen eigenenBeitrag verdient haben.

Beim letzten Mal zeigte ich zum Abschluss zwei repraesentative Verteilung der Selbstreferenzen pro Linklevel. Ich wollte damit darauf hinaus, dass diese Verteilungen sich ueber viele Linklevel nach einem maechtigen Gesetz verhalten. Bevor ich darauf beim naechsten Mal zurueck komme und das Ganze systematisch betrachte, møchte ich zunaechst mithilfe dieses Diagramms …

… auf zwei Sachen eingehen.

Die erste sind die wenigen Ausnahmen vom oben Gesagten. Naja, eigentlich sind es viele, aber die allermeisten der vielen Ausnahmen kønnen alle unter einer Kategorie zusammengefasst werden (und diese Kategorie liegt auch noch in der Natur der Sache) und deswegen zaehlen die alle zusammen nur als eine Ausnahme … aber vielleicht sollte ich einfach nur erklaeren.

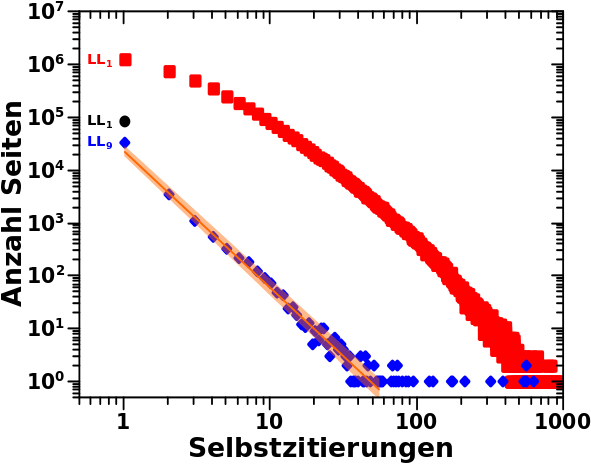
In dem Diagramm sehen wir die Verteilungen der Selbstzitate fuer LL0 (schwarze Punkte), LL1 (rote Quadrate) und LL9 (blaue Diamanten). Wie immer bei diesen Verteilungen zaehlte ich (in diesem Fall) wieviele Seiten es gab (Ordinate), die auf dem gegebenen Linklevel so viele Selbstreferenzen erhielten, wie auf der Abzsisse angezeigt.
Nicht gezeigt sind die Punkte fuer null Selbstreferenzen; die sind naemlich im Wesentlichen fuer alles weitere unwichtig und lassen sich ohnehin nicht gut bei einer logarithmischen Achse darstellen..

Der erste Ausnahmefall ist LL0. Dort sollte es ueberhaupt keine Selbstreferenzen geben (man ist ja noch keinen Schritt im Linknetzwerk voran geschritten). Wir wissen von frueher, dass der eine Punkt mit einem Wert von ca. 80k durch Artefakte zustande kommt.

Kurioserweise erlaubt mir dieses Artefakt den zweiten Ausnahmefall zu erklaeren, denn genau so sieht das auch aus, wenn man sehr weit im Linknetzwerk vorangeschritten ist. Dort liegt der Grund aber darin, dass dann die Chance fuer eine Selbstreferenz URST winzig ist. Entsprechend klein wird die „Signalstaerke“ und die Werte auf der Abzsisse liegen dann nur noch bei 1 (oder vielleicht mal 2) … also ich habe nur noch bei einer Selbstzitierung (und bei null) ein Signal.
Worauf ich hinaus will ist das Folgende: beim naechsten Mal interessiert mich der Anstieg der Verteilung in der doppellogarithmischen Darstellung (welcher dem Exponenten des Potenzgesetzes entspricht). Diesen erhalte ich durch lineare Regression; aber lineare Regression bei Werten die im Wesentlichen „Rauschen“ sind ist nicht sinnvoll.
Deswegen wuerde ich obige Aussage nur unter starkem Vorbehalt fuer als gueltig auf hohen Linkleveln ansehen. Vermutlich ja, aber die Daten geben das einfach nicht her.

Die dritte Ausnahme ist die Verteilung zu LL1, diese verhaelt sich naemlich eindeutig nicht nach einem Potenzgesetz, denn selbst mit beiden Augen zudruecken kann ich die Daten da nicht mit einer linearen Funktion (bei doppellogarithmischer Darstellung) beschreiben. Das gilt bedingt mglw. auch fuer die Verteilungen bei LL2 und LL3, bei Letzteren kann ich aber auch mit gutem Gewissen eine Gerade durch relevante Abschnitte der Daten legen, die gilt halt nur nicht bei all zu kleinen Linkleveln.
Was passiert hier? Nun ja, das ist einfach zu erklaeren: von gaaaanz frueher wissen wir dass jede Ursprungsseite im Durchschnitt 30 (neue) Seiten auf LL1 hat. Ja, auch von frueher wissen wir, dass es auch (Ursprungs)Seiten gibt, die deutlich mehr (oder weniger) als diese 30 Seiten auf LL1 haben. Aber nach unten bin ich ohnehin begrenzt (weniger als null geht nicht) und nach oben liegt die Grenze bei so ca. 1000 Seiten … das ist zwar deutlich mehr, aber davon gibt es nur sehr wenige.

Wieauchimmer, von jeder Seite auf LL1 kann die Ursprungsseite nur eine Selbstreferenz bekommen. Das limitiert wie weit eine Seite auf der Abszisse „reichen kann“; wenn ich nur 30 Seiten auf LL1 habe, dann kann ich keine 31 Selbstreferenzen bekommen.
Ebenso sollte dies indirekt zu einer Ueberhøhung des Signals gegenueber einer Geraden (und damit einer konvexen Kruemmung der Daten) fuehren. Indirekt deswegen, weil das natuerlich nicht der Mechanismus ist, der zu besagter Ueberhøhung des Signals fuehrt. Vielmehr ist es so, dass ja gerade auf LL1 sicherlich viele Seiten auf die Ursprungsseite zurueck verweisen, einfach weil das thematisch sehr oft nahe liegt. Ich habe also ohnehin schon ein høheres Signal und das „draengelt“ sich, durch ersteren Mechanismus, dann auch noch alles bei kleinen Werten auf der Abszisse.

So, genug zu den Ausnahmen.

Wichtiger fuer’s naechste Mal ist eigentlich alles zu LL9. Da ist naemlich eine der oben erwaehnten Regressionsgeraden drin (die dicke orange Linie). Die sieht schick aus, nicht wahr; so richtig schøn mitten durch den (bei doppellogarithmischer Darstellung) linearen Teil der Daten.
Und hier liegt der Hase im Pfeffer! Denn ich habe ja rechts davon auch noch Daten … aber das sind nur ganz wenige, einzelne Seiten, die so viele Selbstreferenzen erhalten … und diese „passen“ ja offensichtlich nicht zu dem worauf ich hinaus will mit dem linearen Teil. Aber die wuerden natuerlich bei einer linearen Regression ueber alle Daten mit einebzogen werden und zu einer Gerade fuehren, die ueberhaupt nicht mehr „gut passt“.
Waehrend des Studiums  habe ich gelernt das zu ignorieren und das Lineal an den linearen Teil so anzulegen, dass die Linie richtig liegt und die Daten gut (genug) beschreibt … vulgo: schick aussieht … wenn ich den Anstieg und das absolute Glied einfach ablese (ohne was formal zu berechnen).
Und genau das habe ich fuer alle (relevanten) Verteilungen gemacht. Ich habe vom Ende (und wenn nøtig auch vom Anfang) so lange Punkte weggeschnitten, bis die Regressionsgerade schick aussah. Wie oben geschrieben, ist das kein schummeln, sondern wurde von Physikern schon immer so gemacht. Auszerdem ist das Potenzgesetz ohnehin nicht ueberall gueltig und der Bereich der Gueltigkeit ergibt sich daraus wo die Gerade die Daten gut beschreibt. Dennoch wollte ich den Prozess mal erwaehnt haben, denn letztlich habe ich die Geraden durch linere Regression erhalten.

Und damit bin ich dann auch bei der letzten Sache … dem orange-durchsichtigen Band um die dicke Linie. Bei der linearen Regression erhaelt man fuer die Parameter der Geraden einen „Fehler“ … vulgo: die plus/minus Werte … und das orange Band kennzeichnet diesen Bereich. Die Regressionsgerade kønnte also irgendwie liegen, solange es innerhalb dieses Bandes ist. Die wahrscheinlichste Gerade ist die eingezeichnete.
Beim naechsten Mal lasse ich die Baender weg, aber ich komme nochmal auf den „Fehler“ des Anstiegs zurueck. Deswegen wollte ich das hier mal erwaehnt haben.

So, das war jetzt viel mehr als ich urspruenglich dachte. Im naechsten Beitrag wird’s voll interessant :)